プロセス報酬アノテーション
プロセス報酬モデルのために、first-errorモードとステップごとモード、任意のneutralラベル、人間の検証付きのLLMによる事前ラベリングで、ステップ単位の報酬ラベルを収集します。
v2.4.0の新機能
プロセス報酬モデルは、最終的な答えだけでなく、モデルが取る推論のステップを採点します。そのため、訓練にはトレースごとに1つのラベルではなく、ステップごとに1つのラベルが必要です。process_reward スキーマは、そのラベルを集めます。
2つのモードは、速度と詳細さのバランスが異なります。first-errorモードは、1回のクリックを求めます。最初に誤ったステップを選び、それ以降はすべて損なわれたものとして扱います。ステップごとモードは、すべてのステップに判断を求めます。コストはより高くなりますが、first-errorでは捉えられないケース、たとえばエージェントが自分のミスから立ち直る場合を捉えられます。
どちらも、コーディングトレース、エージェントトレース、思考連鎖のディスプレイで使えます。
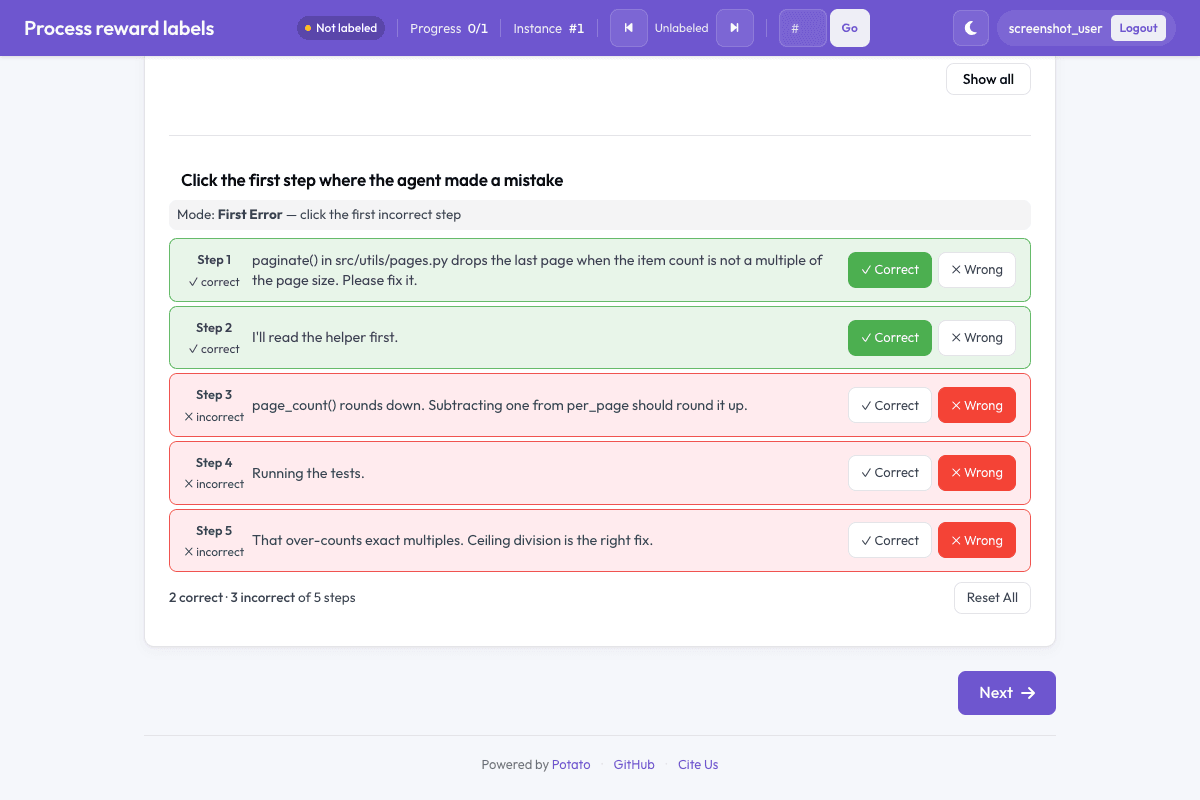 最初の誤りのステップを1回クリックすると、トレース全体にラベルが付きます
First-Errorモード
アノテーターはトレースを上から読み、最初に誤っているステップをクリックします。それより前のステップは正しいものとして記録され、クリックしたステップとそれ以降はすべて誤りとして記録されます。これにより、バイナリのPRM訓練が期待するラベル列になります。エラーの手前までは 1、エラー以降は -1 です。
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent made a mistake"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
steps_key はステップのリストを保持するフィールドを指定し、step_text_key は各ステップ内で表示するフィールドを指定します。
アノテーションのワークフロー
- ステップは、最初は未マークの状態です
- アノテーターが、最初に誤っているステップをクリックします
- それより前のものはすべて緑になります
- そのステップが、最初のエラーとしてマークされます
- それ以降のものはすべて、損なわれたものとしてマークされます
色によって連鎖が見えるようになります。1回の判断でトレース全体にラベルを付けることが、このモードの狙いです。
ステップごとモード
すべてのステップを、それぞれ独立に判断します。PRM800K形式の3値のラベルには allow_neutral を追加します。この場合、ステップは、正しくも誤りでもないものになりえます。
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
allow_neutral が適用されるのは、ステップごとモードだけです。first-errorの連鎖には、neutralのステップを置く位置がないため、このオプションは無視されます。
inline_with_trace: true は、評価のコントロールを別のパネルにまとめるのではなく、ディスプレイ内の各ステップに付けます。長いトレースでアノテーターが自分の位置を見失うのを避けたい場合に、これが適しています。
ラベルの名前を変える
3つのボタンは、既定ではCorrect、Neutral、Wrongと表示されます。reward_labels は、これらの言葉が合わない分野のために名前を変更します。
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    reward_labels:
      correct: "Valid"
      neutral: "Neutral"
      incorrect: "Flawed"
思考連鎖のセグメント化
推論のトレースは、通常、ステップのリストではなく、1本の長い文字列として届きます。cot_segmentation は、アノテーションを始める前にそれを分割します。
cot_segmentation:
  source_key: reasoning      # the item field holding the long CoT string
  strategy: auto             # blank_line | numbered | markers | sentence | llm | auto
  target_key: cot_steps      # where the step list is written
  min_step_chars: 30         # merge anything shorter into the previous step
  max_steps: 200

instance_display:
  fields:
    - key: cot_steps
      type: cot_trace
      label: "Reasoning"

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
min_step_chars は設定する価値があります。これがないと、文や空行によるセグメント化が1行の断片を生み、アノテーターは単独では判断できず、返ってくるラベルはノイズになります。
LLMによる事前ラベリング
モデルがステップごとのラベルを提案し、アノテーターが1つずつ確認または上書きできます。長いトレースでは、ゼロからラベルを付けるより速くなります。
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Verify or correct each suggested reward"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
    ai_prelabel: true
    require_verification: true

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    max_tokens: 768
    temperature: 0.1
    include:
      all: true
ai_prelabel は、提案を要求するボタンを追加します。require_verification は、すべての提案が確認または変更されるまで、アノテーションを受け付けません。これによって、出力がモデルのラベルではなく、人間のラベルのままになります。
max_tokens には、十分な余裕を持たせてください。長い思考連鎖にステップごとの判定を加えると、大きな応答になり、途中で切れた応答は、提案がまったくない状態として描画されます。
出力の内容
アノテーションは、スキームの名前の下に、steps のリストと、収集した mode として保存されます。
{
  "step_rewards": {
    "mode": "per_step",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": 0, "source": "ai", "verified": true, "ai_reward": 0},
      {"reward": null, "source": null, "verified": false}
    ]
  }
}
reward は、正しい場合は 1、誤りの場合は -1、neutralの場合は 0 です。スキップされたステップは 0 ではなく null になるため、誰も判断していないステップは、正しくも誤りでもないと判断されたステップと区別できます。ラベルが訓練データになるときは、この区別が重要です。スキップをneutralとして扱うと、気づかないうちに信号を作り出してしまうためです。
source は、値が人から来たのかモデルから来たのかを記録し、verified は、人が確認したかどうかを記録します。ai_prelabel がオンの場合、ai_reward は、アノテーターが上書きした後も、モデルの元の提案を保持します。これにより、2回目の作業なしで、モデルがどれだけ正しかったかを報告できます。
エクスポート
Potatoには、PRMやDPO用の組み込みのエクスポート形式はありません。アノテーションをエクスポートして、自分で整形してください。
python -m potato.export -c config.yaml -f jsonl -o ./export/first-errorのアノテーションを、ステップ単位の訓練ラベルに変換するのは短い作業です。自分で書くことで、スキップされたステップの扱いを自分で決められます。
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "steps": [
                    {"content": src, "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_training_data.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
分析
import json
from collections import Counter
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

print(f"Traces annotated: {len(traces)}")

all_correct = sum(
    1 for t in traces
    if all(s.get("reward") == 1 for s in t.get("steps", []))
)
print(f"Traces with no errors: {all_correct} ({all_correct / len(traces):.1%})")

# Where the first error lands
first_error_positions = []
for t in traces:
    for i, s in enumerate(t.get("steps", [])):
        if s.get("reward") == -1:
            first_error_positions.append(i)
            break

if first_error_positions:
    avg = sum(first_error_positions) / len(first_error_positions)
    print(f"Average first-error position: step {avg:.1f}")
    print("By position:", Counter(first_error_positions).most_common(10))
ai_prelabel がオンの場合、同じレコードから、モデルの提案がレビューを経て残った頻度が分かります。
kept = changed = 0
for t in traces:
    for s in t.get("steps", []):
        if s.get("ai_reward") is None:
            continue
        if s.get("reward") == s.get("ai_reward"):
            kept += 1
        else:
            changed += 1

total = kept + changed
if total:
    print(f"AI suggestions kept: {kept}/{total} ({kept / total:.1%})")
新しい分野で事前ラベリングを信頼する前に、見るべき数値は、この承認率です。100%近い率は、通常、モデルが正しいのではなく、アノテーターが確認せずに承認していることを意味します。
研究上の位置づけ
プロセス報酬アノテーションは、マルチステップのシステム向けの報酬モデルに関する研究を支えるために存在します。この手法全体の動機となっている知見は、最終的な答えが正しくても、その土台となる推論に欠陥がありうるということです。ステップ単位のラベルは両者を切り分け、ここにあるfirst-errorモードとステップごとモードは、その研究の流れが使うラベル形式に対応しています。
分類体系の設計と、それに伴う一致度の問題については、同じトレースをエラー分類の側から扱っている、ステップ単位のエラー局所化を参照してください。
関連項目
- コーディングエージェントのアノテーション - コーディングエージェントのトレースの表示とアノテーション
- エージェント型アノテーション - エージェントトレースのアノテーション全般
- エクスポート形式 - Potatoがエクスポートする形式
- 品質管理 - 一致度と調停
- LLM をアノテーションでファインチューニングする - ステップの評価で
prm-rewardにより、プロセス報酬モデルを学習する
実装の詳細については、ソースドキュメントを参照してください。