時系列による EEG、ECG、睡眠段階のアノテーション
30秒のエポックごとに睡眠をスコアリングし、EDF+ や WFDB の記録上でインターバルとイベントにマークを付け、各アノテーターのラベルを BIDS の events.tsv としてエクスポートします。
v2.13.0 で追加
time_series ディスプレイは、多チャンネルの記録をブラウザに描画し、interval_label スキームは、記録上のラベル付きインターバルと点イベントを記録します。睡眠研究者は、この2つを睡眠段階の判定に使います。睡眠段階の判定では、ポリソムノグラフィーの30秒のエポックごとに、AASM の段階 W、N1、N2、N3、REM のいずれかを割り当てます。EEG 研究者はアーチファクトと発作にマークを付け、心臓病学の研究者は PhysioNet の ECG 記録の拍とリズムをレビューし、ウェアラブルの研究者は加速度計データの活動区間にラベルを付け、天文学者は光度曲線のトランジットやフレアにマークを付けます。品質の評価、メモ、記録に関するその他の質問は、プロットの隣の通常のスキームに入れます。
European Data Format(EDF)は、睡眠や EEG の記録のような医療の時系列を交換、保存するための標準形式で、EDF+ は、アノテーションと、途切れのある記録を加えたものです。WFDB は、PhysioNet の記録形式です。WFDB の記録は、.hea ヘッダーと .dat の信号ファイル、および .atr のような省略可能なアノテーションファイルからなります。
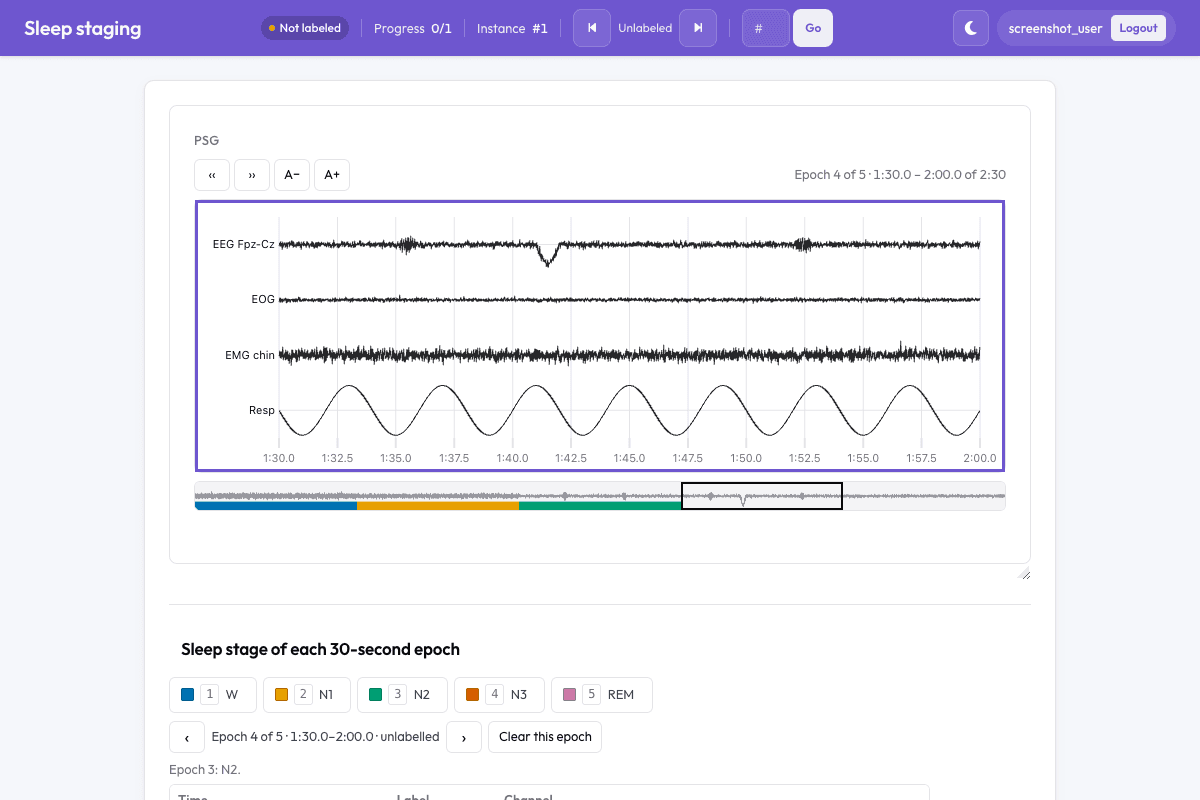 30秒のエポックを1つずつ睡眠段階判定します
- 形式: EDF と EDF+(連続および不連続)、BDF と BDF+、WFDB の記録、時刻列を持つ CSV または TSV、Parquet、小さなインラインの JSON オブジェクト。EDF と BDF のファイルはメモリマップされ、追加のライブラリは不要です。
- 既存のラベル: EDF+ のアノテーション、WFDB の
.atrファイル、Brain Imaging Data Structure(BIDS)のevents.tsvは、事前アノテーションとして読み込まれます。アノテーターは、その事前アノテーションを保持、編集、または破棄できます。 - 長い記録: ブラウザが記録をダウンロードすることはありません。サーバーは、画面上の範囲について、チャンネルごとに1ピクセルあたり最大2つの値(生のサンプル、または各ピクセルの最小値と最大値)を送ります。したがって、8時間の記録も、30秒の記録とほぼ同じ速さで開きます。
- オフライン: 信号ファイルは、Potato サーバー上で、メディアディレクトリまたはタスクディレクトリから読み込まれます。URL、絶対パス、
..による脱出は拒否されます。
WFDB の記録と Parquet ファイルには、signals エクストラ(wfdb と pyarrow)が必要です。
pip install 'potato-annotation[signals]'設定
次の設定は、4チャンネルのポリソムノグラムで、30秒のエポックごとの睡眠段階の判定を構成します。2つ目のスキームは、同じプロットをクリックして、覚醒(arousal)にマークを付けます。
annotation_task_name: "Sleep staging"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/psg.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: signal               # item field holding the EDF file name
      type: time_series
      label: "PSG"
      display_options:
        window: 30
        channels:
          - {name: "EEG Fpz-Cz", range: [-120, 120]}
          - {name: "EOG", range: [-150, 150]}
          - "EMG chin"
          - "Resp"

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: interval_label
    name: stage
    description: "Sleep stage of each 30-second epoch"
    signal_field: signal
    mode: epoch
    epoch_length: 30
    require_all_epochs: true    # counted only while the scheme is required
    label_requirement: {required: true}
    labels:
      - {name: W, key_value: "1"}
      - {name: N1, key_value: "2"}
      - {name: N2, key_value: "3"}
      - {name: N3, key_value: "4"}
      - {name: REM, key_value: "5"}
    preannotation_labels:       # EDF+ hypnogram names -> scheme labels
      "Sleep stage W": W
      "Sleep stage 1": N1
      "Sleep stage 2": N2
      "Sleep stage 3": N3
      "Sleep stage R": REM
      "Arousal": null

  - annotation_type: interval_label
    name: arousals
    description: "Arousals (click on the plot)"
    signal_field: signal
    mode: free
    pre_annotations: false
    labels:
      - {name: arousal, key_value: "a", kind: event}
channels リストは、レーンとその順序を選び、range は、チャンネルの単位でレーンの振幅のスケールを固定します。範囲を固定すると、EEG のレーンは、どのエポックでも同じスケールに保たれます。preannotation_labels のマップは、EDF+ の睡眠段階図の段階名をスキームのラベルに変更し、ファイルの覚醒エントリーを除外します。2つ目のスキームは pre_annotations をオフにしており、アノテーターはそこで、手作業で覚醒にマークを付けます。require_all_epochs と label_requirement を併用すると、すべてのエポックに段階が付くまで、「次へ」はブロックされたままです。各スキームの signal_field は、time_series フィールドの key と等しくなければならず、一致しない場合、サーバーは起動を拒否します。
各項目は、media_directory からの相対パスで信号ファイルを指定します。
{"id": "night-01", "note": "Night 1", "signal": "psg/night-01.edf"}EEG のレビューのためのフリーモード
EEG のレビューは、フリーモードを使います。フリーモードでは、アノテーターは、プロット上をドラッグしてインターバルにラベルを付け、クリックして点イベントにマークを付けます。次の部分的なブロックは、上の設定の annotation_schemes を置き換えます。
annotation_schemes:
  - annotation_type: interval_label
    name: eeg_events
    description: "Mark artifacts and seizures, and click each spike"
    signal_field: signal
    mode: free
    channel_scope: either       # all channels, or the lane the drag starts on
    labels:
      - {name: artifact, key_value: "1"}
      - {name: seizure, key_value: "2"}
      - {name: spike, key_value: "3", kind: event}
channel_scope: either では、アノテーターは、プロットの上のトグルで、新しいインターバルを全チャンネルに適用するか、1つのレーンに適用するかを選びます。電極のアーチファクトが1つのレーンにだけ現れる一方で、全般発作はすべてのチャンネルにわたることがあるためです。段階付けしたエポックの中の無呼吸や覚醒にマークを付けるには、エポックのスキームを維持し、同じ signal_field を持つフリーモードのスキームを追加します。上の睡眠の設定は、この方法で覚醒にマークを付けています。2つのスキームには、異なるラベルのキーを与えてください。
信号ファイル
項目で指定されたファイルの拡張子が、リーダーを決めます。
| 拡張子 | 形式 | 必要なもの |
|---|---|---|
.edf | EDF、EDF+(連続および不連続) | なし |
.bdf | BioSemi の BDF、BDF+(24ビット) | なし |
.hea | WFDB の記録(ヘッダーと、ヘッダーが列挙する .dat ファイル) | signals エクストラ |
.csv、.tsv | 時刻列と、チャンネルごとに1列 | なし |
.parquet、.pq | 同じレイアウトの Parquet | signals エクストラ |
.json | ファイル内の、下記のインラインオブジェクト(最大 50 MB) | なし |
- EDF+。 継続時間を持つ各アノテーションは、全チャンネルにわたる事前アノテーション済みのインターバルになり、継続時間のない各アノテーションは、点イベントになります。EDF+D のファイルでは、各データレコードは、その時刻記録のアノテーションが与える開始時刻に配置され、レコード間の空きは、線の途切れとして描画されます。ヘッダーの記載より短いファイルは、最後の完全なレコードまで読み込まれ、プロットの下に警告が表示されます。
- WFDB。 記録は
.heaファイルで指定し、信号ファイルは同じディレクトリに置きます。<record>.atrの拍のアノテーションは、その記号(N、Vなど)でラベル付けされた点イベントになり、(AFIBのようなリズムのアノテーションは、次のリズムの変化まで続くAFIBのインターバルになります。サンプルは1ウィンドウずつ読み込まれ、長いホルター記録が全体として読み込まれることはありません。リーダーは複数セグメントの記録に対応していないため、複数セグメントの記録は、読み込む前に結合してください。 - CSV と Parquet。 時刻列は、設定されていれば
time_column、なければtime、t、timestamp、seconds、sec、time_s、datetime、mjd、jdという名前の最初の列、それもなければ最初の列です。そのほかの数値列はすべてチャンネルで、ヘッダー内の単位(ax (g)、ay [m/s^2])は、チャンネルの単位になります。時間の刻みがすべて、刻みの中央値の 0.1% 以内に収まる系列は、規則的にサンプリングされたものとして扱われ、それ以外の系列は、各サンプル自身の時刻を保持します。CSV と Parquet のファイルは全体が読み込まれ、256 MB に制限されます。それより大きな記録は、EDF に変換してください。 - インライン JSON。 小さな信号は、項目自体に入れられ、全チャンネルの合計で最大 500,000 サンプルです。
インラインオブジェクトは、規則的なサンプルには sampling_rate を、光度曲線のような不規則な系列には、サンプルごとに1つの時刻を持つ time リストを与えます。どちらのキーも、チャンネルごとに設定できます。t0 は、最初のサンプルの時刻を、トップレベルまたはチャンネルごとに設定します。data 内の null は欠損サンプルで、start_time は、time_format: clock のために、t = 0 の実時刻を与えます。
{"id": "demo", "signal": {
  "sampling_rate": 100,
  "start_time": "2024-01-01T22:00:00",
  "channels": [
    {"name": "Fz", "unit": "uV", "data": [0.1, 0.4, 0.2]},
    {"name": "Resp", "unit": "a.u.", "sampling_rate": 10, "data": [0.0, 0.3]}
  ]
}}
EDF、BDF、WFDB、および sampling_rate を持つインラインデータでは、時刻は記録の開始からの秒数です。CSV と Parquet では、時刻は時刻列の値そのまま(秒、日、MJD)で、日時の列は、最初の行からの秒数になります。保存されるラベルは、ファイルと同じ時間の基準を使います。
ディスプレイオプション
オプションは display_options の下、またはフィールド上に直接置きます。
time_series のオプション | デフォルト | 意味 |
|---|---|---|
window | 30 | 最初に表示する秒数であり、「次へ」と「前へ」のコントロールの刻み |
channels | すべて | 表示するチャンネルを順に、名前または {name, label, range: [low, high], color} で指定します |
layout | stacked | stacked はチャンネルごとに1つのレーンを与え、overlay はすべてのチャンネルを凡例付きで1つの y 軸に置きます |
draw | line | line、または、まばらで不規則な系列向けの points |
amplitude | recording | recording は、各レーンをファイル全体でのチャンネルの範囲(0.5 から 99.5 パーセンタイル)にスケーリングし、window は、画面上にあるものに合わせて再スケーリングします。チャンネルの range は、どちらの設定も上書きします |
lane_height | 56 | stacked レイアウトでの、レーンあたりのピクセル数。20から400 |
height | レーンから | プロットの高さ(ピクセル)。80から4000。値がない場合、高さはレーン数に lane_height を掛けて48を足した値で、160から1400の範囲に保たれます |
time_format | auto | elapsed(h:mm:ss)、clock(start_time からの実時刻)、number。auto は、time_unit が s のとき elapsed、それ以外では number を意味します |
time_unit | s | 日や MJD の CSV または Parquet データのための、時刻列の単位 |
invert_y | false | 天文の等級用に、overlay レイアウトで y 軸を反転します |
time_column | 自動 | CSV または Parquet の時刻列 |
annotation_extension | atr | 事前アノテーションとして読み込む WFDB のアノテーションファイル。なしにするには null |
max_file_mb | 2048 | 読み込む信号ファイルの最大サイズ(メガバイト)。それより大きなファイルは拒否されます |
overview | true | プロットの下に、記録全体、ラベル付けされた区間、現在のウィンドウを示すストリップを表示します。ストリップをクリックまたはドラッグすると、ウィンドウが移動します |
engine オプションが取る値は uplot だけです。信号ファイルは常にサーバー上で読み込まれるため、ディスプレイは allow_remote を拒否します。
スキームのオプション
interval_label のオプション | デフォルト | 意味 |
|---|---|---|
signal_field | 必須 | ラベル付けする time_series フィールドの key |
labels | 必須 | 名前、または {name, key_value, color, kind, tooltip}。kind は interval(デフォルト)または event |
mode | free | ドラッグとクリックには free、固定ウィンドウを順にラベル付けするには epoch |
epoch_length | 30 | エポックあたりの秒数 |
channel_scope | all | all はラベルをすべてのチャンネルに適用し、channel はドラッグを始めたレーンに適用し、either はトグルを表示します |
auto_advance | true | エポックモードで、ラベルのキーのあとに次のエポックへ移動します |
allow_overlap | フリーモードでは true、エポックモードでは false | false の場合、新しいインターバルは、同じチャンネル上の他のインターバルの重なった部分を置き換えます |
next_key、previous_key | ]、[ | ウィンドウを動かすキー |
pre_annotations | true | ファイル自身のアノテーション(EDF+、WFDB の .atr、またはインライン)から始めます。ファイルにアノテーションがない場合は、学習した signal-cnn モデルのインターバルから始めます。false にすると両方がオフになります |
preannotation_field | なし | BIDS の events.tsv のパス、または保存される形のアノテーションを持つ項目フィールド |
preannotation_labels | なし | ファイルのラベルをスキームのラベルに名前変更し、null に対応づけたラベルは破棄されます。名前を変更したアノテーションが保持されるのは、スキームが同じ種類でそのラベルを宣言している場合だけです |
require_all_epochs | false | エポックモードで、すべてのエポックにラベルが付くまで、「次へ」はブロックされたままです。スキームが必須の場合に適用されます |
min_annotations | なし | 項目が指定の数以上のインターバルとイベントを持つまで、「次へ」はブロックされたままです。スキームが必須の場合に適用されます |
instructions | なし | ラベルの上に表示されるテキスト |
key_value のないラベルには、キー 1 から 9、続いて q から p が割り当てられます。ラベルの色のデフォルトは、Okabe-Ito のパレットです。Okabe-Ito の色は、一般的な色覚特性があっても区別できます。
エポックをスコアリングし、インターバルにマークを付ける
エポックモードでは、記録は先頭から epoch_length のウィンドウに区切られ、アノテーターは1回に1つのエポックを見ます。段階のキーは、現在のエポックにラベルを付けて次へ進み、[ と ](または Page Up と Page Down)は、ラベルを付けずに移動し、「Clear this epoch」はラベルを削除します。概観ストリップは、スコアリング済みのすべてのエポックを、その段階の色で塗り、ストリップをクリックすると、ウィンドウがクリックした点へ移動します。
フリーモードでは、アノテーターは、ラベルのキーを押すかラベルボタンをクリックしてから、プロット上をドラッグしてインターバルにラベルを付け、ラベルがイベントのラベルなら、クリックして点にマークを付けます。インターバルのラベルを選んでいるときは、クリックでポインターの下のエントリーを選択し、ラベルのキーでそのエントリーのラベルを付け替え、Delete でエントリーを削除し、Escape で選択を解除します。すべてのエントリーは、Show と Delete のボタンとともにプロットの下に一覧され、このリストは、マウスなしでラベルをレビューするためのキーボード経由の手段です。
A− と A+ のボタンは、すべてのレーンの振幅を下げるか上げます。プロットにフォーカスがあるとき、左右の矢印キーは、Potato の他の場所のように項目間を移動する代わりに、1ウィンドウ分移動します。矢印キーに Shift を併用すると、ウィンドウの10分の1ずつパンします。
項目に保存済みの回答がない場合、ファイルのアノテーションは、注記とともに破線のオーバーレイとして表示されます。オーバーレイは、アノテーターの最初の変更時、または「Keep these」で保存され、「Discard them」はオーバーレイを消去します。エポックモードでは、ファイル内の睡眠段階図の区間は、その区間が半分以上を覆っているエポックに分割されます。
学習したモデルからのインターバル
v2.14.0の新機能
調査は、アノテーターがマークしたインターバルで signal-cnn モデルを学習し、残りの記録にモデルのインターバルを表示できます。エポックモードでは、モデルはすべてのエポックにラベルを付け、フリーモードでは、ラベル付きのインターバルをマークします。点イベントは、学習も予測もされません。model_training.writeback.schemas がそのスキームを指定していれば、モデルのインターバルは同じ破線のオーバーレイとして表示され、「· from the model」とともに一覧されます。記録自身のアノテーションが優先され、モデルのインターバルは、ファイルと preannotation_field のどちらにもアノテーションがない場合にだけ使われます。モデルの学習は科学分野のモデルで説明しています。
保存される回答
各スキームは、項目ごとに1つの JSON オブジェクトを保存します。
{"intervals": [{"start": 30.0, "end": 60.0, "label": "N2", "channel": null},
               {"start": 41.2, "end": 43.0, "label": "artifact", "channel": "EOG"}],
 "events":    [{"time": 52.25, "label": "arousal", "channel": null, "source": "file"}]}
channel はチャンネル名で、全チャンネルの場合は null です。ファイルから来て変更されていないエントリーは "source": "file" を保持し、学習したモデルから来て変更されていないエントリーは "source": "model" を保持します。
エクスポート
複数のアノテーターが同じ記録をスコアリングでき、num_annotators_per_item がその人数を設定します。2つの信号エクスポートは、どちらも各アノテーターのラベルを分けて保持します。
| 形式 | 出力 |
|---|---|
interval_label | intervals.csv と intervals.jsonl。インターバルまたはイベントごとに1行で、user_id, instance_id, schema, kind, start, end, duration, label, channel, source を持ちます。イベントは start が end に等しく、継続時間が 0 で、アノテーターのエントリーは source が annotator に設定され、変更されていない事前アノテーションは file または model になります |
bids_events | アノテーターと項目ごとの <annotator>/<instance>_events.tsv。onset, duration, trial_type, channel(全チャンネルでは n/a)を持ち、events.json のサイドカーが付きます。複数の interval_label スキームがある場合、各スキームに独自のフォルダーが付きます |
python -m potato.export -c config.yaml -f bids_events -o exports/bids汎用の CSV と JSONL のエクスポートは、回答をスキームごとに1つの JSON セルとして保持します。エポックモードでは、スコアリングされた各エポックが独自のインターバルになります。そのため、intervals.csv ファイルは、アノテーターごと、エポックごとに1行です。Potato の一致度指標は、interval_label スキームを対象にしません。エクスポートのあとで、intervals.csv から、睡眠段階のCohen のカッパのような、エポックごとの統計量を計算してください。
例
python potato/flask_server.py start examples/advanced/time-series-intervals/config-epochs.yaml -p 8000この例では、アノテーターは2つの項目で30秒のエポックをスコアリングし、両方の項目は、1つの合成の5分間の EDF+ ポリソムノグラムを指しています。config-epochs.yaml の隣の config.yaml は、同じ記録と、BIDS の events.tsv を持つ2分間の手首の加速度計 CSV に対して、フリーモードを実行します。
コーディングエージェントで調査を設定する
potato-skill 1.2.0 は Potato 2.13.1 を対象としており、interval_label と time_series を名前で認識します。このスキルは、アノテーターに何を尋ねるか、各記録を何人のアノテーターがスコアリングするか、トレーニングと注意チェック、エクスポートなど、調査設計の側面を支援します。このスキルは、信号ファイルの形式、ディスプレイのオプション、signals エクストラを、まだ文書化していません。potato-skill をインストールし、エージェントに調査を説明して、形式とオプションについては、このページの Markdown 版をエージェントに参照させてください。Markdown 版は https://www.potatoannotator.com/docs/annotation-types/time-series.md にあります。
関連資料
- インスタンス表示 - ディスプレイフィールドの設定方法
- スペクトログラムのアノテーション - 音声上の時間周波数ボックス
- エクスポート形式 - Potato のエクスポート形式とエクスポートコマンド
- 科学分野のモデル - マークされたインターバルで
signal-cnnモデルを学習する - アノテーターは何人必要か - 項目あたりのアノテーター数の選び方
- ヘルスケア - 臨床および生物医学のアノテーションのための Potato
実装の詳細については、ソースドキュメントを参照してください。