スペクトルのピークピッキングと積分
JCAMP-DX や mzML から読み込んだ NMR、IR、質量スペクトルでピークをピッキングして積分し、承認または却下する候補ピークを使って、ピークごとに1行の CSV を出力します。
v2.13.0 で追加
spectrum ディスプレイは、項目ごとに1つのスペクトルをブラウザに描画し、peak_picking スキームは、アノテーターがピッキングしたピーク、積分した領域、承認または却下した候補ピークを記録します。化学者や分光学者は、この2つを、ラベル付きスペクトルのデータセットの構築に使います。たとえば、NMR 分光法のピークリスト、赤外分光法のバンド帰属、質量スペクトルのピークのアノテーションです。教員は、同じスペクトルに対する各学生のピークリストを集め、エクスポート後にそのリストを採点します。自動ピークピッカーを実行しているグループは、そのピッカーのピークを候補として読み込み、アノテーターは、候補の各ピークを承認または却下します。
ピークピッキングは、スペクトル内の各ピークの位置と強度を列挙します。1H NMR スペクトルでは、多重線の積分値は、その多重線を生じるプロトンの数に比例します。アノテーターは、多重線をまたいでドラッグすることで、それを積分します。
JCAMP-DX は、IUPAC が保守している、分光データのテキスト形式です。mzML は、HUPO Proteomics Standards Initiative による、質量分析データの XML 形式です。1つの mzML ファイルは、1回の測定のスペクトルを保持します。
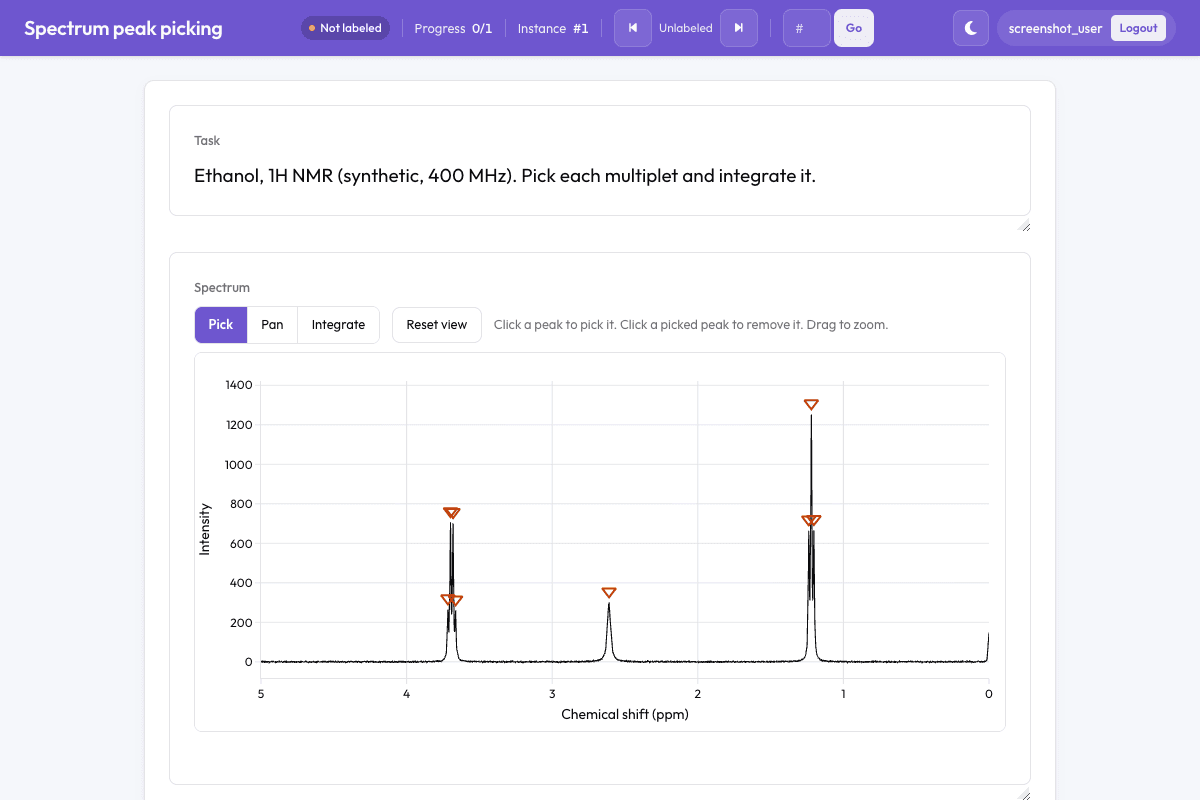 候補ピークは、アノテーターが1つずつ承認または却下するのを待ちます
- エンジン: Potato のリポジトリには Plotly 2.27.0(MIT)が含まれており、Potato は、スペクトルのあるページでだけ Plotly を読み込みます。Plotly は SVG を描画するため、このディスプレイは WebGL を必要としません。
- 形式: JCAMP-DX(
.jdx、.dx、.jcamp)、mzML(.mzML)、2列のテキスト(.csv、.tsv、.txt、.xy)。スペクトルは、2つのリストとして項目の中に直接書くこともできます。 - 長いスペクトル: ファイルはサーバー上で解析され、ブラウザが受け取る点は、最大で
max_points個(デフォルトは 4,000)です。元のスペクトルの各バケットは、その最小の点と最大の点を保持します。したがって、細い NMR の線も、高さがそのまま保たれます。ズームインすると、表示範囲の元の点が取得され、その範囲がmax_pointsを超える点を持つ場合にだけ、サーバーはその範囲を再びダウンサンプリングします。 - 軸の規約: 化学シフトと波数の軸は、左から右へ高い値から低い値に進みます。Hz で保存された NMR スペクトルは、ファイルの
.OBSERVE FREQUENCYで ppm に変換されます。 - オフライン: スペクトルファイルは、Potato サーバーのメディアディレクトリから読み込まれます。URL で指定されたスペクトルは拒否され、Potato がスペクトルをダウンロードすることはありません。
JCAMP-DX と CSV のファイルには追加のインストールは不要で、scipy はコア依存関係であるため、ピーク検出にも追加は不要です。mzML だけが、spectra エクストラ(pyteomics、psims、lxml)を必要とします。
pip install 'potato-annotation[spectra]'設定
次の設定は、1H NMR のピークピッキングを構成します。ディスプレイは自動検出で見つけたピークを提案し、アノテーターは、各提案を承認または却下し、各ピークに帰属と多重度を与え、各多重線を積分します。
annotation_task_name: "1H NMR peak picking"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/spectra.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: spectrum               # item field naming the spectrum file
      type: spectrum
      label: "1H NMR"
      display_options:
        prepick:                  # suggested peaks, off unless set
          method: detect
          prominence: 0.05
          max_peaks: 30

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: peak_picking
    name: peaks
    description: "Pick the peaks, assign each one, and integrate each multiplet"
    viewer_field: spectrum
    peak_fields:
      - name: assignment
        placeholder: "e.g. OCH2"
      - name: multiplicity
        options: [s, d, t, q, m, br]
    region_fields:
      - name: protons
        label: "nH"
    min_peaks: 1
    require_review: true          # every suggestion accepted or rejected
    label_requirement: {required: true}
options を持つフィールドは選択式のフィールドで、options を持たないフィールドは、テキストボックスです。ディスプレイは、NMR の線スペクトルでは、積分モードを自動的にオンにします。min_peaks、require_review、label_requirement を併用すると、アノテーターが少なくとも1つのピークをピッキングし、すべての提案を承認または却下するまで、「次へ」はブロックされたままです。スキームの viewer_field は、spectrum フィールドの key と等しくなければならず、一致しない場合、サーバーは起動を拒否します。
各項目は、media_directory からの相対パスで、スペクトルファイルを指定します。
{"id": "ethyl_acetate", "note": "1H NMR, 400 MHz, CDCl3.", "spectrum": "spectra/ethyl_acetate_1h.jdx"}自動ピークピッカーをレビューする
ピークピッカーの出力をレビューするには、そのピッカーのピークを各項目に入れます。そうすると、アノテーターは、提案された各ピークの承認か却下だけを行えます。
annotation_task_name: "Peak picker review"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/review.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: spectrum
      type: spectrum
      display_options:
        prepick: {method: item}   # the peaks listed in each item

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: peak_picking
    name: review
    description: "Accept the real peaks and reject the rest"
    viewer_field: spectrum
    peak_fields: []
    region_fields: []
    require_review: true
    allow_manual: false
label_requirement: {required: true}{"id": "ethanol", "note": "Peaks from the automatic picker.",
"spectrum": {"file": "spectra/ethanol_1h.jdx", "peaks": [3.69, 2.61, 1.22, {"x": 7.26, "label": "CHCl3"}]}}提案されるピークは、項目の peaks リスト内の数値、または {x, y, label} のマッピングです。y がない場合は、x の位置のスペクトルから読み取られ、label は、アノテーターが提案を承認したときに、ピークの label フィールドとして保存されます。allow_manual: false では、提案から離れた場所をクリックしても何もピッキングされず、「Add a peak at」ボックスは取り除かれます。peak_fields: [] と region_fields: [] では、スキームは、各ピークの隣にテキストの入力を求めません。
学習したピークモデルからの候補
v2.14.0の新機能
調査は、アノテーターが残したピークで peak-cnn モデルを学習し、残りのスペクトルにモデルのピークを候補として表示できます。モデルが予測するのはピークの位置だけです。承認した各ピークの帰属と多重度は、引き続きアノテーターが与えます。モデルのピークは、model_training.writeback.schemas が peak_picking スキームを指定し、ディスプレイに prepick が設定されているときにディスプレイへ届きます。prepick: {method: model} では、ディスプレイはモデルのピークだけを提示し、プロットの下のリストは各ピークに「· model」を付けます。承認されたモデルのピークは source: model として保存・エクスポートされます。モデルの学習と、モデルのピークの項目への書き戻しは科学分野のモデルで説明しています。
質量スペクトルと IR スペクトル
セントロイド化された mzML のスキャンは、スティックとして描画され、クリックすると最も近いスティックがピッキングされます。ピークテーブルしかない JCAMP-DX ファイルも、同じくスティックとして描画され、ほとんどの JCAMP-DX の質量スペクトルは、そうしたファイルです。次の部分的なブロックは、質量スペクトル用のディスプレイオプションを示し、ファイル自身のピークテーブルが、最も高い20個の候補として提示されます。
instance_display:
  fields:
    - key: spectrum
      type: spectrum
      display_options:
        prepick: {method: file, max_peaks: 20}
mzML の項目はスキャンを指定し、JCAMP-DX の複合ファイルはブロックを指定します。
{"id": "r7", "spectrum": {"file": "runs/sample1.mzML", "scan": 1043}}
{"id": "c2", "spectrum": {"file": "spectra/compound.jdx", "block": 1}}
透過率または反射率による IR スペクトルでは、ディスプレイは極小をピッキングします。ノイズの多い IR スペクトルでは、prominence を 0.1 など、より高くする必要があります。
スペクトルデータ
項目のフィールドは、メディアディレクトリ内のファイル名か、次の表のキーを持つマッピングです。
| キー | 意味 |
|---|---|
file または path | media_directory からの相対パスで指定するスペクトルファイル |
scan、index | mzML の測定のどのスペクトルを表示するか。index は測定内での0始まりの位置で、scan はネイティブ ID の scan=N の部分です。scan も index もない場合は、最初のスペクトルが表示されます |
block | JCAMP-DX の複合ファイルのどのブロックを表示するか。0始まりで、データを持つブロックだけを数えます |
peaks | prepick のメソッド item のための候補ピーク。数値または {x, y, label} のマッピング |
x、y | 同じ長さの2つのリストによるインラインのスペクトル |
x_units、y_units、kind、title、sticks | インラインのスペクトルの単位、スペクトルの種類、タイトル、スティックでの描画 |
ほかのキーは、受け付けるキーを示すメッセージとともに拒否されます。インラインの NMR スペクトルは、次の行のようになります。
{"id": "s1", "spectrum": {"x": [0.5, 1.0, 1.5], "y": [3, 40, 2], "x_units": "PPM", "kind": "nmr"}}Potato は JCAMP-DX を自力で読み込みます。これには、すべての ASDF 圧縮形式の ##XYDATA(DIF の Y チェックを検証済み)、##XYPOINTS、##PEAK TABLE、Bruker と MestReNova が書き出す ##NTUPLES 形式、##BLOCKS を持つ複合ファイルが含まれます。XYDATA の隣にあるピークテーブルは、そのファイル自身のピークリストであり、prepick のメソッド file は、そのリストを候補として提示します。横軸のない FID、2次元 NMR、JCAMP-CS の構造は、読み込まれません。
CSV ファイルは、x、y の順の2列で、カンマ、タブ、セミコロン、空白で区切られます。# で始まる行はコメントで、省略可能なヘッダー行は、shift (ppm)、wavenumber (cm-1)、transmittance (%T) のように、括弧内のテキストから単位を設定します。mzML は DOCTYPE も実体も使わないため、DOCTYPE や実体を宣言する mzML ファイルは、解析の前に拒否されます。
オプション
spectrum ディスプレイのオプション | デフォルト | 意味 |
|---|---|---|
spectrum_type | auto | nmr、ir、raman、uv、ms、other。auto は JCAMP-DX の DATA TYPE を読むか、x の単位から種類を推定します |
x_reversed | auto | true は x を高い値から低い値へ描画します。auto は、NMR(ppm または Hz)と IR(cm⁻¹)の軸を反転します |
x_label、y_label | 単位から | 「Chemical shift (ppm)」や「Wavenumber (cm⁻¹)」などの軸のタイトル |
mode | auto | line または sticks。auto は、ピークテーブルやセントロイド化された mzML のスキャンを、スティックとして描画します |
peak_direction | auto | max または min。auto は、透過率と反射率では min を使います |
integrate | auto | 積分モードを提供します。auto は、NMR の線スペクトルに対してのみ、積分モードをオンにします |
prepick | オフ | 候補ピーク。true、または次の表のキーを持つマッピング |
snap | true | クリックは、ポインターの正確な位置の代わりに、ポインターから9ピクセル以内の局所的な極大(または極小)をピッキングします |
max_points | 4000 | ブラウザに送られる点の数。200から100,000 |
max_file_mb | 50 | これより大きいスペクトルファイルは拒否されます。最大 500 |
scan、index | なし | すべての項目に対して表示する mzML のスペクトル。項目自身の scan または index が優先されます。2つのうち1つを与えます |
block | なし | すべての項目に対して表示する JCAMP-DX のブロック |
height | 380 | プロットの高さ。ピクセル、または CSS の長さ |
engine | plotly | 唯一のエンジン |
allow_remote | false | スペクトルはサーバー上で読み込まれるため、true は拒否されます |
prepick のキー | デフォルト | 意味 |
|---|---|---|
method | auto | detect はピーク検出を実行し、file は JCAMP-DX のピークテーブルを使い、item は項目の peaks リストを使い、model は学習した peak-cnn モデルのその項目のピークを使います。auto は、item、model、file、detect の順に、最初に利用できるものを使います |
prominence | 0.05 | detect では、ピークが周囲よりどれだけ高く突き出る必要があるか。y 範囲に対する割合で、0より大きく1より小さい値。スティックでは、最も高いスティックに対する割合での最小の高さ |
max_peaks | 40 | 候補の最大数。1から500で、最も顕著なものが残ります |
min_distance | なし | detect で、候補どうしの最小の間隔。x の単位 |
検出は、フル解像度のスペクトルに対して、プロミネンスのしきい値を付けて scipy.signal.find_peaks を実行します。候補ピークがアノテーターの判断を左右するおそれがあるため、候補はデフォルトではオフです。アノテーターがピッカーのピークをどのくらいの頻度で承認するかを測る調査では、候補をオンにする必要があります。
peak_picking のオプション | デフォルト | 意味 |
|---|---|---|
viewer_field | 必須 | instance_display 内の spectrum フィールドの key |
peak_fields | 1つのテキストフィールド label | 各ピークの隣の入力。{name, type, options, required, placeholder, label} のリスト。[] で入力なし |
region_fields | 1つのテキストフィールド label | 同じものを、積分した各領域に対して指定します |
min_peaks | なし | スキームが必須の場合、この数のピークがピッキングされるまで、項目は未完了のままです |
max_peaks | なし | これを超えてピークをピッキングしようとすると、メッセージとともに拒否されます |
require_review | false | スキームが必須の場合、すべての候補が承認または却下されるまで、項目は未完了のままです |
allow_manual | true | false は、ピークを候補からだけにし、「Add a peak at」を取り除きます |
instructions | なし | 質問の下のテキスト |
label_requirement | なし | {required: true} でスキームを必須にします |
| フィールドのキー | デフォルト | 意味 |
|---|---|---|
name | 必須 | 英字、数字、_、- からなる短い識別子。リスト内の文字列だけの要素は、名前として読まれます |
type | text、options が与えられた場合は choice | text または choice |
options | なし | choice フィールドの選択肢。yes、no、on、off は引用符で囲んでください。そうしないと、YAML がこの4語を真偽値として読みます |
required | false | スキームが必須の間、すべてのピーク(または領域)で、このフィールドを埋める必要があります |
placeholder | なし | 空のテキストボックスに表示されるヒントのテキスト |
label | 先頭を大文字にした名前 | プロットの下の表の列見出し |
ピークをピッキングして積分する
プロットの上のツールバーには、3つのモードがあります。
| モード | クリック | ドラッグ |
|---|---|---|
| Pick(デフォルト) | ポインターの下のピークをピッキングします。ピッキング済みのピークをクリックすると削除され、候補をクリックすると、その候補が承認されます | ドラッグしたボックスにズームします |
| Pan | 何もしません | スペクトルに沿って移動します |
Integrate(integrate がオンのとき) | ポインターの下の領域を削除します | ドラッグした x の範囲を積分します |
プロット上のダブルクリックか、Reset view ボタンで、ズームアウトして元に戻ります。タッチスクリーンでは、タップがクリックとして動作します。
snap がオンの場合、線の近くでクリックすると、その線の頂点がピッキングされるため、アノテーターは、多重線の各線をピッキングする前にズームインして、線を分離します。候補ピークは白抜きのオレンジの三角形、ピッキング済みのピークは、そのピークのフィールド値でラベル付けされた塗りつぶしの三角形として描画されます。各領域は、網掛けされ、最初の領域に対する相対的な積分値でラベル付けされ、最初の領域は 1.00 と表示されます。
サーバーは、各積分を、領域の両端の間にあるすべての元の点に対する台形積分として計算し、ベースライン補正は行いません。そのため、多重線より広く描かれた領域は、高い値になります。相対的な積分値に固定の基準が必要な場合は、どのシグナルを最初に積分するかを、説明に書いてください。integrate: true のスティックスペクトルでは、積分値は、その領域内のスティックの強度の合計です。
プロットの下には、スキームが、候補ピークを Accept ボタンと Reject ボタン、および Accept all と Reject all とともに一覧します。却下された候補は小さなボタンとして表示され、そのボタンを押すと、候補が復元されます。Peaks の表には、ピークごとに1行があり、ピークの位置、強度、由来、フィールド、Remove ボタンを持ちます。Integrals の表には、領域ごとに1行があり、領域の範囲、積分値、相対積分値、フィールドを持ちます。「Add a peak at」ボックスでは、アノテーターが位置を入力して Enter を押し、候補に一致する位置は、その候補を承認します。すべてのコントロールはボタンかフォームのフィールドなので、アノテーターは、キーボードだけでスペクトルをレビューできます。
保存される回答
peak_picking スキームは、項目ごとに1つの JSON オブジェクトを保存します。
{"viewer": "spectrum",
 "items": [{"kind": "peak", "x": 2.0399, "y": 3003, "source": "auto", "width": 0.0031,
            "fields": {"assignment": "CH3CO", "multiplicity": "s"}},
           {"kind": "peak", "x": 7.26, "y": 132, "source": "manual"},
           {"kind": "region", "from": 1.969, "to": 2.120, "integral": 15.77,
            "fields": {"protons": "3"}}],
 "rejected": [4.1464]}
source は、承認された候補では auto、学習したピークモデルの承認された候補では model、アノテーターが追加したピークでは manual です。width は、検出されたピークの、半値プロミネンスでの全幅で、x の単位です。rejected は、アノテーターが却下した候補の位置を列挙します。アノテーターが承認も却下もしなかった候補は保存されず、必須のスキームでの require_review は、すべての候補が、この2つのリストのどちらかに入ることを保証します。
エクスポート
peak_table エクスポートは、ピーク、領域、却下された候補ごとに1行を書き出します。
python -m potato.export --config config.yaml --format peak_table --output out/エクスポートは、peaks.csv と peaks.jsonl を書き出し、--option format=csv または --option format=jsonl は、該当するファイルだけを書き出します。JSONL の行は、空の列を省きます。
| 列 | 内容 |
|---|---|
user_id、instance_id、schema | アノテーター、項目、スキーム |
kind | peak、region、rejected |
x、y、width | ピークの位置、強度、幅(検出されたピークのみ)。rejected の行は x だけを持ちます |
from、to、integral、relative | 領域の範囲、積分値、同じ回答内の最初の領域に対する積分値 |
source | ピークでは auto、model、manual のいずれか。領域は manual、却下された候補は auto |
label | その行のフィールド値を " / " でつないだもの |
| フィールドごとに1列 | assignment や multiplicity など。名前が上の列と等しい場合は、field_ が前に付きます |
複数のアノテーターが同じスペクトルでピークをピッキングでき、num_annotators_per_item がその人数を設定します。汎用の CSV と JSONL のエクスポートにも回答が含まれ、スキームごとに1つの JSON セルになります。Potato の一致度指標は、peak_picking スキームを対象にしません。エクスポートのあとで、peaks.csv からアノテーターのピークリストを比較してください(たとえば、1つの項目のピークを、ppm または cm⁻¹ の許容範囲内で対応づける)。ピークピッカーのレビューでは、source: auto のピークの行と rejected の行の数から、各アノテーターの承認率がわかります。学習したモデルの候補については、代わりに source: model のピークの行を数えてください。
例
python potato/flask_server.py start examples/advanced/spectrum-peak-picking/config.yaml -p 8000この例には、DIFDUP 圧縮の JCAMP-DX で Hz による2つの合成の 1H NMR スペクトル(酢酸エチルとエタノール)と、CSV の合成の IR 透過率スペクトルが1つあります。検出による候補と require_review はオンです。3つのスペクトルはすべて作り物です。同じディレクトリの generate_spectra.py が、ファイルを再生成します。
コーディングエージェントで調査を設定する
potato-skill 1.2.0 は Potato 2.13.1 を対象としており、peak_picking と spectrum を名前で認識します。このスキルは、アノテーターに何を尋ねるか、各スペクトルを何人のアノテーターがピッキングするか、トレーニングと注意チェック、エクスポートなど、調査設計の側面を支援します。このスキルは、スペクトルのファイル形式、ディスプレイのオプション、spectra エクストラを、まだ文書化していません。potato-skill をインストールし、エージェントに調査を説明して、形式とオプションについては、このページの Markdown 版をエージェントに参照させてください。Markdown 版は https://www.potatoannotator.com/docs/annotation-types/spectra.md にあります。
関連資料
- 化学構造 - 分子上の構造編集と原子の選択
- インスタンス表示 - ディスプレイフィールドの設定方法
- エクスポート形式 - Potato のエクスポート形式とエクスポートコマンド
- 科学分野のモデル - ピッキングされたピークで
peak-cnnモデルを学習する - アノテーターは何人必要か - 項目あたりのアノテーター数の選び方
- ライフサイエンス - ライフサイエンスとバイオキュレーションのための Potato
実装の詳細については、ソースドキュメントを参照してください。