轉寫格式
Potato 能讀取的所有轉寫與字幕格式:Whisper、WhisperX、Deepgram、AssemblyAI、AWS Transcribe、SRT、WebVTT、TTML、YouTube 字幕、CTM、Praat TextGrid 和 ELAN EAF,以及並列檔案和歸一化的話輪模型。
Potato 能讀取 21 種轉寫和字幕輸入,並在顯示之前把它們全部轉換成同一個話輪模型。無論你的語音識別流水線或字幕工具產出的是什麼,都可以直接把 Potato 指過去,不用寫轉換指令碼。 本頁是關於哪些格式可用、每種格式如何被識別、各自帶來什麼資訊的參考。分步說明見如何標註 Whisper 轉寫文本和如何標註 YouTube 字幕。
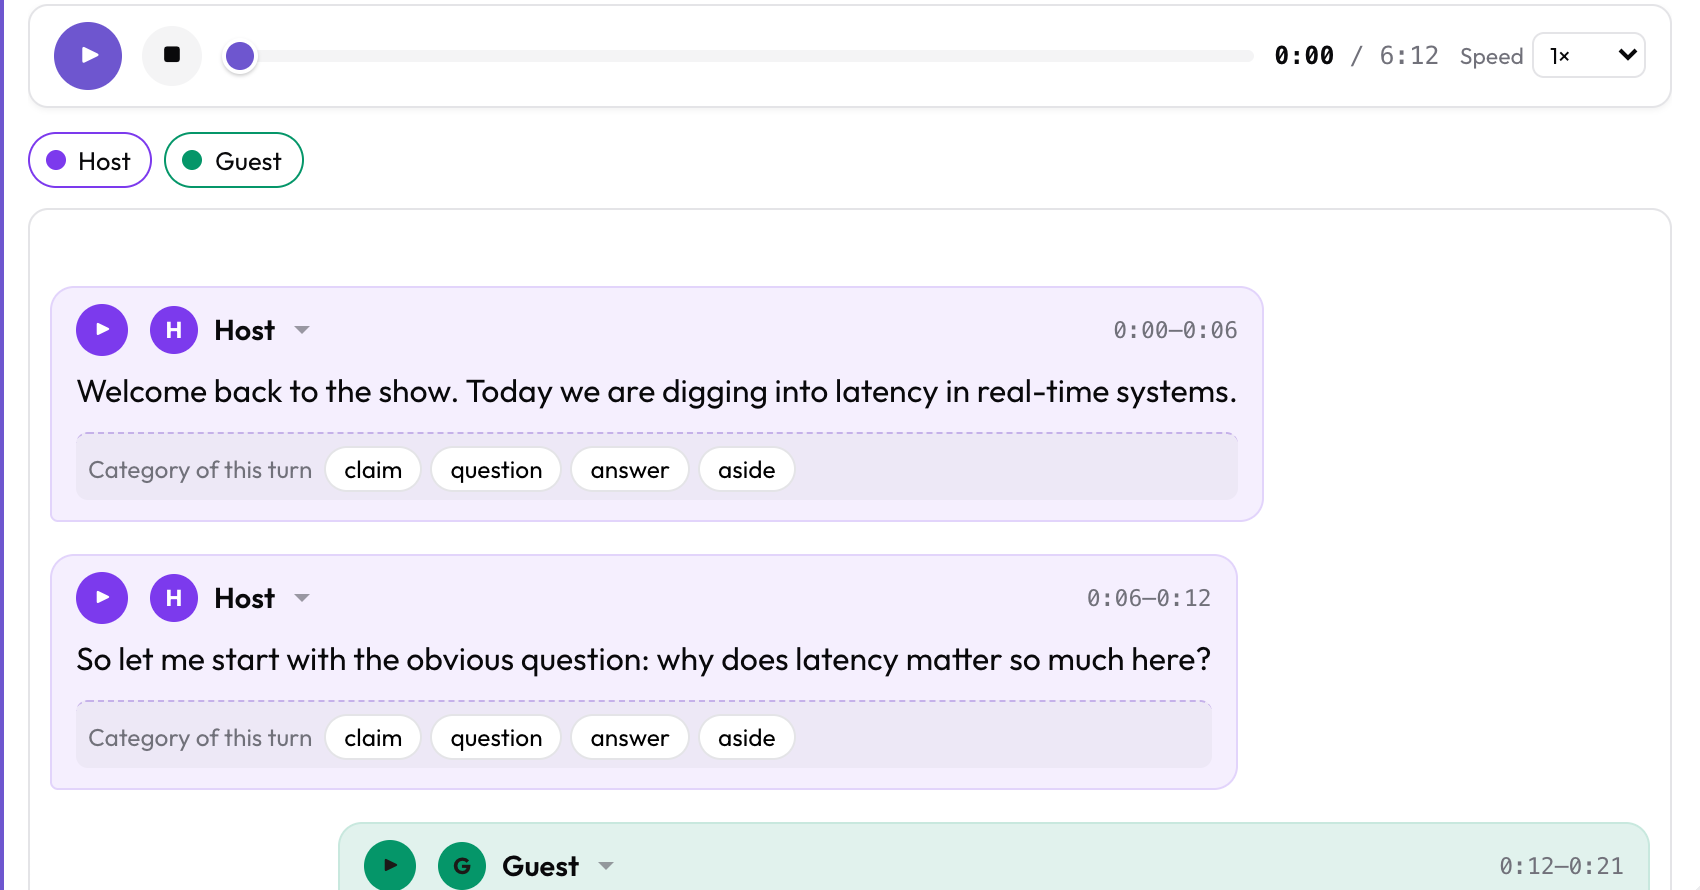 一個並列的 SRT 檔案呈現為說話人氣泡,每個話輪上都掛著一個問題
轉寫從哪裡來
語音識別和說話人分離生成轉寫,本頁的解析器負責讀取。可以執行 Whisper、WhisperX、pyannote 或某個雲端 API;從 2.9 版起,也可以用 potato transcripts --transcribe --diarize 在自己的機器上完成這兩步,詳見在本地轉寫。格式檢測和解析不會執行任何模型。
Note: Think-Aloud 模式確實會執行一個本地 Whisper 模型,但目的不同:它錄下標註員在工作時說出的思考過程。那是一個採集功能,不是轉寫匯入。
按內容識別,而不是按副檔名
Potato 會檢查檔案內部的內容,而不是相信檔名。一個叫 captions.txt 的 WebVTT 檔案依然會被當作 WebVTT 解析。實際的結果是:同一份轉寫無論是內嵌在資料檔案裡,還是從磁碟上的並列檔案讀取,都能工作,配置不需要改動。
支援的格式
語音識別輸出
| 格式 | 識別依據 | 說話人 | 逐詞時間 |
|---|---|---|---|
| Whisper JSON | segments 陣列 | 無 | 有,使用 --word_timestamps 時 |
| WhisperX / 已分離說話人的 JSON | 帶 speaker 的 segments | 有 | 有 |
| whisper.cpp JSON | transcription 陣列 | 無 | 無 |
| Whisper TSV | start/end/text 表頭 | 無 | 無 |
| AWS Transcribe | results.items 或 results.audio_segments | 有 | 有 |
| Deepgram | results.channels 或 results.utterances | 有,需 diarize=true | 有 |
| AssemblyAI | text 加 words/utterances | 有,需 speaker_labels | 有 |
| Rev.ai | monologues 陣列 | 有 | 有 |
| SPoRC | turn_text/turnText 行 | 有,推斷得出 | 無 |
字幕與隱藏字幕
| 格式 | 識別依據 | 說話人 |
|---|---|---|
SubRip(.srt) | 字幕塊箭頭,,mmm 分隔符 | 來自 Name: 字首 |
WebVTT(.vtt) | WEBVTT 頭 | 來自 <v Name> 標籤或 Name: 字首 |
SubStation Alpha(.ass、.ssa) | [Script Info] / Dialogue: | 來自 Name 欄位 |
| TTML / DFXP | <tt> 根元素 | 來自 speaker/agent 屬性 |
| YouTube srv1/srv2/srv3 | <transcript><text> XML | 來自 Name: 字首 |
| YouTube json3 | events 陣列 | 沒有;自動字幕不帶說話人 |
SubRip 和 WebVTT 覆蓋了你會遇到的絕大部分情況。TTML 出現在廣播檔案以及專業字幕工具匯出的檔案裡。
對齊與語言學標註
| 格式 | 識別依據 | 說話人 |
|---|---|---|
| NIST CTM | 空白分隔的列,數值型起始時間和時長 | 來自聲道欄位 |
| Praat TextGrid | File type = "ooTextFile" | 每個說話人一層 |
| ELAN EAF | ANNOTATION_DOCUMENT 根節點 | 來自 PARTICIPANT,否則用層 ID |
TextGrid 的長格式和短格式都能解析。對 ELAN 檔案,Potato 會把 ALIGNABLE_ANNOTATION 和 REF_ANNOTATION 對照 TIME_ORDER 表解析,並從頭部讀取媒體引用。
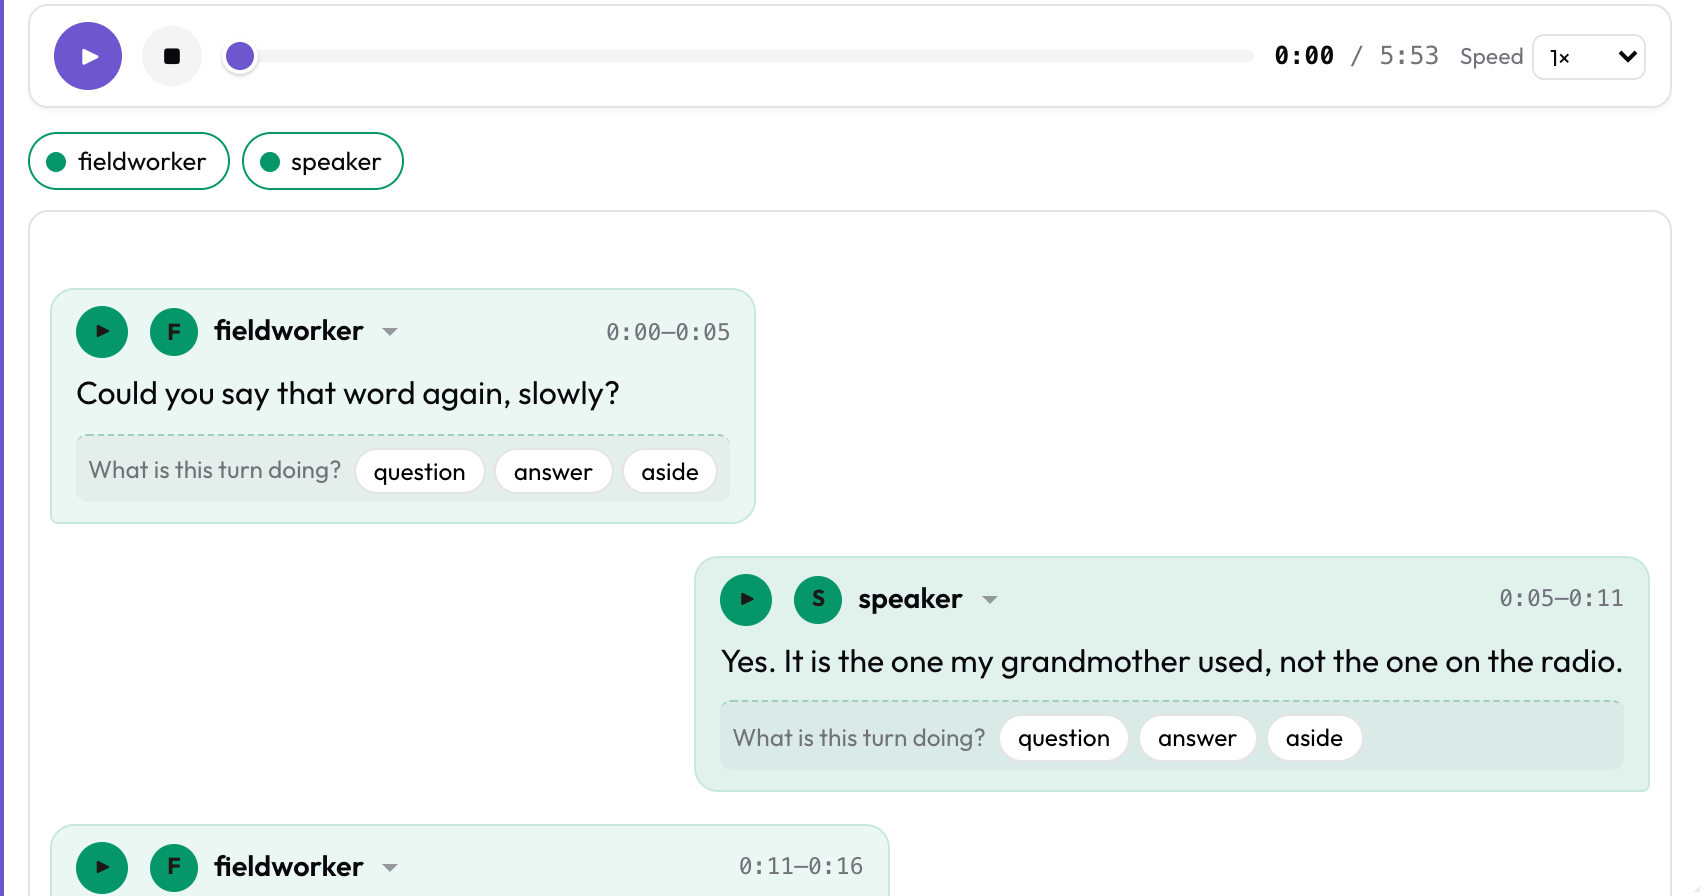 TextGrid 的每一層都成為一個說話人,中間的空區間被跳過
其他
三種通用形態湊齊了這 21 種:
- 一個
{speaker, start, end, text}字典的簡單列表。 - 一個
{"audio": ..., "turns": [...]}物件。 - 完全沒有時間資訊的純段落,顯示為一個氣泡。
不支援的格式
這些沒有對應的解析器,請先轉換。
- SAMI(
.smi)、MicroDVD(.sub)、SubViewer(.sbv) - Transcriber(
.trs)、EXMARaLDA、CHAT/CHILDES(.cha) - Montreal Forced Aligner 和 Gentle 的原生輸出。請從這些工具匯出 CTM 或 TextGrid。
- 包在特殊外殼裡的 Azure Speech、Google Speech-to-Text 以及 Whisper API 的
verbose_json - 單獨的 RTTM 說話人分離檔案
只要來源提供,逐詞置信度都會被解析並保留在資料模型中,但目前沒有檢視它的介面。
歸一化的話輪模型
上面所有格式最終都會變成這樣:
{
  "audio": "media/interview_01.mp3",
  "turns": [
    {
      "turn_id": "t0",
      "speaker": "host",
      "start": 0.0,
      "end": 6.5,
      "text": "Welcome back.",
      "words": [{"word": "Welcome", "start": 0.0, "end": 0.4, "confidence": 0.99}],
      "confidence": 0.97
    }
  ]
}只有來源本身帶有這些資訊時,words 和 confidence 才會出現。未做說話人分離的話輪 speaker 為 null,會顯示為帶選擇器的 Unassigned,供標註員補上。
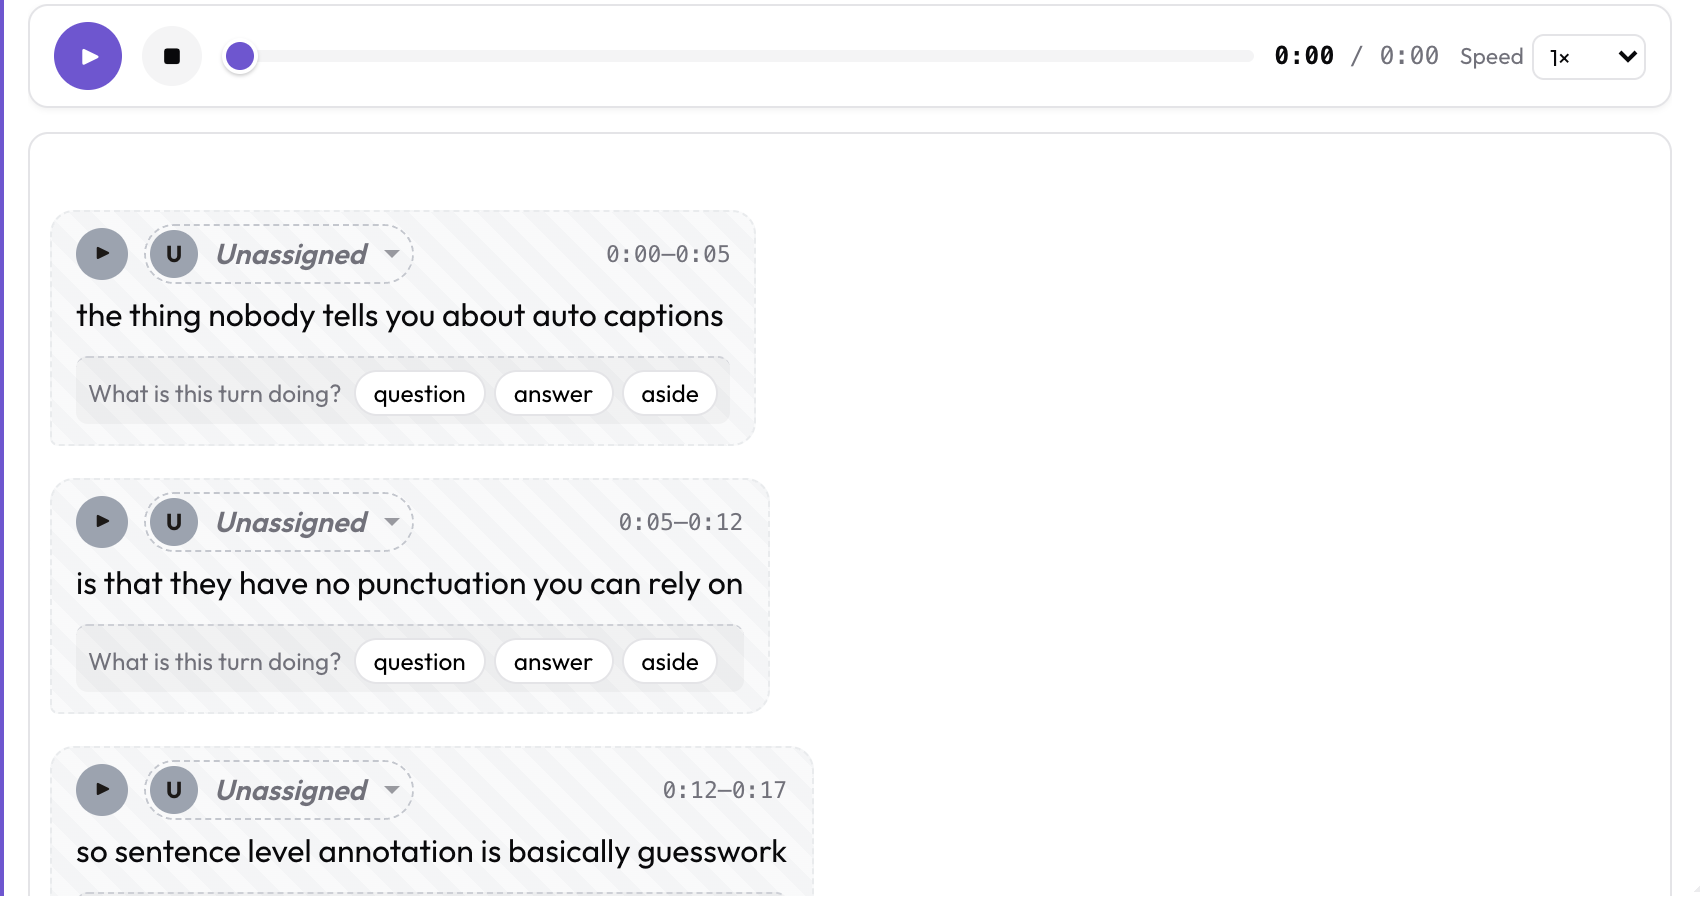 YouTube 自動字幕到達時沒有說話人,所以在標註員選定之前每個話輪都是 Unassigned
turn_id 是話輪級標註和說話人分配的持久化鍵。來源中若有顯式的 turn_id 或 step_id 字串就用它,否則用 t{索引}。同一個檔案總是產生相同的 ID,所以標註在重新整理後依然保留。
Warning: 不同工具的時間單位並不一致。Whisper 和 Deepgram 用浮點秒;AssemblyAI、whisper.cpp 的偏移量以及 Whisper 的 TSV 輸出用整數毫秒。Potato 在邊界處完成換算,因此之後的一切都是秒。如果你自己的預處理把兩者混在一起,時間就會差 1000 倍。
並列檔案
如果一個欄位值是一行的短路徑且以已知的轉寫副檔名結尾,它會被從磁碟讀取,而不是當作文本。這樣一來,語音識別工具本來就生成好的目錄結構,即媒體檔案旁邊放著對應的 .srt 或 .json,無需任何預處理步驟即可使用:
{
  "id": "int_001",
  "conversation": {
    "audio": "media/int_001.mp3",
    "transcript": "media/int_001.srt"
  }
}
路徑相對於 task_dir 解析,並經過與其他所有配置路徑相同的路徑安全校驗,因此資料檔案無法讀取項目之外的內容。
可識別的副檔名:.srt .vtt .webvtt .json .json3 .srv1 .srv2 .srv3 .ttml .dfxp .xml .ass .ssa .tsv .ctm .TextGrid .eaf .txt
如果你的資料裡確實存放著看起來像檔名的一行轉寫,請關閉這個啟發式判斷:
display_options:
  transcript_is_path: auto   # auto (default) | true | false
配置
顯示方式:audio_dialogue
音訊對話顯示把話輪畫成與音訊同步的說話人氣泡,每個話輪上都有播放按鈕。
instance_display:
  fields:
    - key: conversation
      type: audio_dialogue
      label: "Transcript"
      span_target: true
      display_options:
        audio_key: audio
        turns_key: turns
        speaker_key: speaker
        text_key: text
        transcript_is_path: auto
        show_timestamps: true
        allow_speaker_assignment: auto
scroll_height: 460px| 選項 | 預設值 | 作用 |
|---|---|---|
audio_key | audio | 欄位值中存放音訊 URL 或路徑的子鍵。 |
turns_key | turns | 存放話輪列表的子鍵,也接受 segments。 |
speaker_key / text_key | speaker / text | 話輪級的鍵。 |
speakers | [] | {id, name, color, side} 名單。未列出的說話人會得到確定性的顏色和左右交替的位置。 |
allow_speaker_assignment | auto | 當存在未分離的話輪或有名單需要校正時,auto 會開啟點選分配。true 強制開啟,false 關閉。 |
transcript_is_path | auto | 是否把欄位值當作並列檔案的路徑讀取。 |
show_timestamps | true | 在每個話輪上顯示 mm:ss–mm:ss。 |
scroll_height | 480px | 可滾動轉寫區域的高度。 |
playback_rates | [1, 1.25, 1.5, 2] | 速度選擇器中的選項。 |
標註方案
從 2.7.1 起,speech_transcript、voice_interaction 和 tiered_annotation 都直接從實例記錄中讀取轉寫,並接受本頁列出的所有格式。在此之前只有 audio_dialogue 顯示方式能做到。
annotation_schemes:
  - annotation_type: speech_transcript
    name: transcript_review
    description: "Mark transcription errors"
    segments_key: segments       # record field holding the transcript

  - annotation_type: voice_interaction
    name: barge_in
    description: "Mark overlaps and barge-in"
    turns_key: turns
分層標註可以用轉寫預先填好某一層,讓標註員去修正已有的對齊,而不是手工重新切分語音:
  - annotation_type: tiered_annotation
    name: tiers
    source_field: audio_url
    media_type: audio
    tiers:
      - name: utterance
        labels:
          - name: speech
            color: "#7c3aed"
預填的標註在標註員真正做出修改之前不會寫入,所以只是開啟過實例的人不會被記上工作量。
在本地轉寫
從 Potato 2.9 起,potato transcripts 可以自己生成轉寫稿,而不只是讀取現成的轉寫稿。安裝擴充套件包,然後把它指向一個錄音資料夾:
pip install 'potato-annotation[transcribe]'
potato transcripts ./interviews --transcribe --diarize --num-speakers 2 -o data/interviews.json
轉寫使用 faster-whisper,說話人分離使用 sherpa-onnx,二者都在你自己的機器上執行,不需要 PyTorch,也不需要 Hugging Face 令牌。分離後的輪次標為 SPEAKER_00、SPEAKER_01,與 WhisperX 生成的標籤相同。如果知道說話人數量,請傳入 --num-speakers。
模型權重在首次使用時下載,因此第一次執行需要聯網。若要在隔離網路中執行,先在聯網的機器上準備一次:Whisper 使用本地的 CTranslate2 模型目錄,說話人分離使用 POTATO_MODEL_CACHE。
系統會先執行語音活動檢測,這樣 Whisper 就不會在靜音段編造文字。但它也可能在沒有任何警告的情況下丟掉輕聲或耳語。如果你確定含有語音的音訊轉寫結果偏短,請加上 --asr-no-vad 重新執行。
用 potato transcripts 生成資料檔案
把轉換工具指向一個裝著語音識別輸出的目錄,它會寫出可直接標註的資料檔案:
# Pair transcripts to media by basename
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.json

# Media served from elsewhere
potato transcripts './captions/*.vtt' \
  --media-url-prefix https://cdn.example.org/audio -o data/talks.json

# What did it detect? Writes nothing.
potato transcripts ./whisper_out --dry-run
--dry-run 不寫任何東西,只報告它找到了什麼,這也是發現目錄裡放錯 Whisper 輸出檔案的最快方式:
Scanned 3 file(s):
  talk_01.srt          SRT                  2 turns      5.0s  2 speaker(s): Alice, Bob
  talk_02.vtt          WebVTT               1 turns      3.0s  undiarized
  talk_03.json         whisper.cpp JSON     1 turns      2.4s  undiarized

3 item(s), 4 turn(s).
1 item(s) have no media. Pass --media-dir or --media-url-prefix to enable playback.
| 選項 | 用途 |
|---|---|
-o、--output | 寫到哪裡。除 --dry-run 外必填。 |
--format | json(預設)或 jsonl。 |
--media-dir | 按檔案主名配對的媒體目錄。 |
--media-url-prefix | 用媒體的基準 URL 代替本地檔案。 |
--field | 轉寫要放進條目的哪個欄位。預設 conversation。 |
--id-prefix | 加在每個生成 ID 前面的字串。 |
--speaker-key | 源資料中存放說話人標籤的鍵。 |
-r、--recursive | 遞迴進入子目錄。 |
--dry-run | 報告每個檔案識別出的格式和話輪數。 |
--emit-config | 同時列印一段匹配的 config.yaml。 |
-q、--quiet | 關閉逐檔案報告。 |
條目 ID 來自去掉末尾媒體副檔名後的檔名,所以 Whisper 的 interview_01.mp3.json 得到的是 interview_01,而不是 interview_01.mp3。
再匯出回去
分層標註可以匯出為 ELAN EAF 和 Praat TextGrid,所以一份轉寫能走完一個來回:匯入、在 Potato 裡標註、匯出、在 ELAN 或 Praat 裡精修,再把結果讀回來。
python -m potato.export --config config.yaml --format eaf --output ./out/
python -m potato.export --config config.yaml --format textgrid --output ./out/
這兩個匯出器都以 tiered_annotation 的輸出為基礎。其他方案通過標準格式匯出。
問題排查
| 現象 | 發生了什麼 |
|---|---|
| 全部顯示為一個大氣泡 | 格式沒有被識別,退回到了純段落兜底。執行 potato transcripts <file> --dry-run,如果報告 plain text,說明時間資訊根本沒被解析。通常這個檔案是 Whisper 的 .txt(完全沒有時間資訊),而不是 .json 或 .srt。 |
| 沒有說話人,全是 Unassigned | 來源沒有說話人標籤。Whisper 本身不做說話人分離,YouTube 自動字幕也不做。請在上游執行說話人分離,或讓標註員在介面裡分配。 |
| 時間差了 1000 倍 | 上游把秒和毫秒混用了。whisper.cpp 的 offsets、AssemblyAI 和 Whisper 的 TSV 都是毫秒。 |
| 轉寫路徑本身顯示成了正文 | 並列檔案讀不出來,於是路徑被當成內容顯示了。檢查它是否解析到 task_dir 之下。伺服器日誌裡會記錄具體原因。 |
| 一行的內嵌轉寫被當成檔名 | 在顯示欄位上設定 transcript_is_path: false。 |
示例項目
Potato 倉庫中的 examples/audio/transcript-formats/ 並排展示六種格式,每種都從並列檔案載入:SubRip、WebVTT、Whisper JSON、YouTube json3、Praat TextGrid 和 Deepgram。六種都產生相同的說話人氣泡。
python potato/flask_server.py start examples/audio/transcript-formats/config.yaml -p 8000同一個任務也提供為可下載的示例設計:Transcript Format Ingestion。
實現細節參見源文件。
延伸閱讀
- 如何標註 Whisper 轉寫文本,完整流程
- 如何標註 YouTube 字幕,字幕及其限制
- 對話標註,說話人氣泡顯示方式
- 音訊標註,從零開始的波形切分
- 為標註設計資料格式