Think-Aloud 模式
標註者一邊幹活一邊說話,Potato 把逐字轉寫稿存下來當作理由。語音轉文字完全在本地跑,用的是 faster-whisper,音訊不出本機,流程裡沒有云端 API,也沒有 LLM。
v2.7.0 新增
在 LLM 出現之前,理解判斷過程的黃金方法是出聲思考法,而它從來沒能真正進到標註工具裡。Think-Aloud 模式讓標註者幹活時直接說出來就行。
逐字轉寫稿會被原樣存成理由,刻意不做摘要,因為對出聲思考的記錄做轉述,等於汙染了你本來想採集的那份材料。標籤可以用語音提交,靠的是一套基於規則的解析器識別固定說法,整條流程裡沒有任何 LLM。
語音轉文字完全在本地通過 faster-whisper 執行,39 MB 的 tiny.en 模型在 CPU 上就能即時跑。音訊不會離開本機,沒有云端 API 要調,也沒有按 token 計費的賬單要付。
Note: Think-Aloud 轉寫的是你的標註者。如果你想標註的是已有的轉寫稿,來自 Whisper、雲端 ASR API 或下載來的字幕,那是另一個功能:見轉寫格式。這兩者常被混淆,因為都用到了 Whisper。
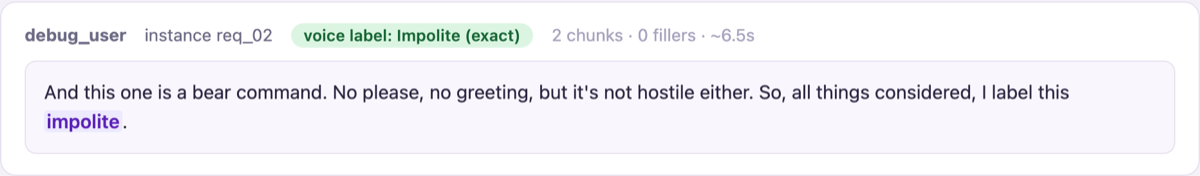
記錄人的思維鏈
重點不只是收集理由。Think-Aloud 捕捉的是一個人究竟怎麼推到那個標籤上,於是你可以把這條人的思維鏈,和模型在同一條目上的思維鏈擺在一起看。
Potato 的過程獎勵標註逐步拆解模型怎麼推理,Think-Aloud 捕捉的是人怎麼推理。兩者都是採集介面,把它們在同一個條目上並排放著,有意思的分歧就是在那裡冒出來的。
工作方式
- 標註者點一下 🎤 出聲思考,然後隨便說。
- 音訊按完整的六秒分塊採集,並在本地轉寫。
- 要用語音提交標籤,就用下面這些被接受的說法之一:
- "I label this Polite" / "I'd call it neutral"
- "My answer is impolite"
- "Final answer: polite" / "I go with neutral"
- 識別到之後會自動在介面裡選中對應選項,常規的儲存流程隨之觸發,小標籤給出確認:Heard: Impolite ✓。之後再說一句新的,標籤就改了,以最後一次提交為準。
- 設了
require_spoken_label: true時,還沒提交標籤就按下一條,會觸發一次提示,告訴他們期望的說法。再按一次就放行,而點選標籤始終有效。
思考過程中提到的一切都會被忽略。"This seems polite, but…" 什麼也不會提交。只有固定說法才會提交,這正是基於規則的解析夠用的原因。聽錯了會由標籤的模糊匹配兜住,所以 "in polite" 會解析成 Impolite。
安裝
pip install faster-whisper # local STT; first recording downloads the model (~39 MB)瀏覽器需要麥克風許可權。localhost 算作安全上下文。
配置
thinkaloud:
  enabled: true
  schema: politeness          # scheme whose labels can be spoken (default: first radio)
  stt: auto                   # faster_whisper | mock | auto
  model: tiny.en              # tiny.en is CPU real-time; base.en is sturdier
  chunk_seconds: 6            # recording chunk length
  require_spoken_label: true  # nudge on Next without a committed label
  # stems:                    # override accepted phrasing regexes (advanced)
  # fillers: [um, uh, hmm, i guess, maybe]
# language: en| 選項 | 預設值 | 說明 |
|---|---|---|
stt | auto | faster_whisper(本地)、mock(測試和開發用),或 auto,它會選 faster-whisper,缺失時給出有用的報錯。 |
model | tiny.en | 任意 faster-whisper 模型 id。 |
chunk_seconds | 6 | 每個分塊都是一個完整的音訊檔案。 |
stems | 內建 | 被接受說法的正則詞幹;每條都會捕獲其後跟著的詞。 |
fillers | um, uh, hmm, … | 猶豫計數器所用的詞表。 |
require_spoken_label | true | 什麼都沒提交時,在下一條按鈕上給一次性提示。 |
你能得到什麼
- 逐字的理由文本流,與每個 (標註者, 實例) 對齊,標籤那句話被單獨拆出來。轉寫稿減去提交那句,就是理由。
- 確定性的猶豫訊號:靜音分塊計數,以及基於可配置詞表的填充詞計數,都用算術算出來,不靠模型。
- 一個審閱頁面
/thinkaloud/review(管理員),列出每個會話的轉寫稿、語音提交的標籤、置信度和猶豫統計。 - 免手操作的標註,算是順帶的好處,其中包括實打實的無障礙支援和對重複性勞損的緩解。
資料與 API
轉寫稿持久化到 {output_annotation_dir}/thinkaloud/transcripts.jsonl(只追加,每個分塊一條記錄)。
| 端點 | 方法 | 鑑權 | 用途 |
|---|---|---|---|
/thinkaloud/api/chunk | POST | session | Multipart 音訊分塊 → 轉寫 + 識別 |
/thinkaloud/api/text | POST | session | 文本分塊(無音訊路徑) |
/thinkaloud/api/state | GET | session | 某個實例的會話聚合資料 |
/thinkaloud/review | GET | admin | 轉寫稿審閱頁面 |
/thinkaloud/api/export | GET | admin | 所有會話的 JSON |
設計說明
- 解析器跑在最近兩個分塊的滑動視窗上,因此跨分塊邊界的說法依然能識別到。
- 標籤匹配先精確匹配,再字首匹配,最後用
difflib在 0.8 閾值上匹配,並優先取精確匹配。"polite" 絕不會模糊撞上 "Impolite"。 - 要接入新的 STT 後端,就在
potato/thinkaloud/stt.py裡繼承STTBackend,並在create_stt中註冊。