시계열을 이용한 EEG, ECG, 수면 단계 주석
30초 에포크로 수면을 채점하거나 EDF+ 및 WFDB 기록에 구간과 이벤트를 표시한 뒤, 각 주석자의 레이블을 BIDS events.tsv 파일로 내보냅니다.
v2.13.0에서 추가
time_series 디스플레이는 다채널 기록을 브라우저에서 그리고, interval_label 스킴은 기록에 대한 레이블이 붙은 구간과 시점 이벤트를 기록합니다. 수면 연구자는 이 둘을 수면 단계 판정에 사용합니다. 수면 단계 판정은 수면다원검사의 30초 에포크마다 AASM 단계 W, N1, N2, N3, REM 중 하나를 배정합니다. EEG 연구자는 아티팩트와 발작을 표시하고, 심장학 연구자는 PhysioNet의 ECG 기록에서 박동과 리듬을 검토하며, 웨어러블 연구자는 가속도계 데이터에서 활동 구간에 레이블을 달고, 천문학자는 광도 곡선에서 통과나 플레어를 표시합니다. 기록에 대한 품질 평가, 메모, 그 밖의 질문은 플롯 옆의 일반 스킴에 넣습니다.
European Data Format(EDF)은 수면 및 EEG 기록 같은 의료 시계열을 교환하고 저장하기 위한 표준 형식이며, EDF+는 주석과 공백이 있는 기록을 추가합니다. WFDB는 PhysioNet의 기록 형식입니다. WFDB 기록은 .hea 헤더와 .dat 신호 파일, 그리고 .atr 같은 선택적인 주석 파일로 이루어집니다.
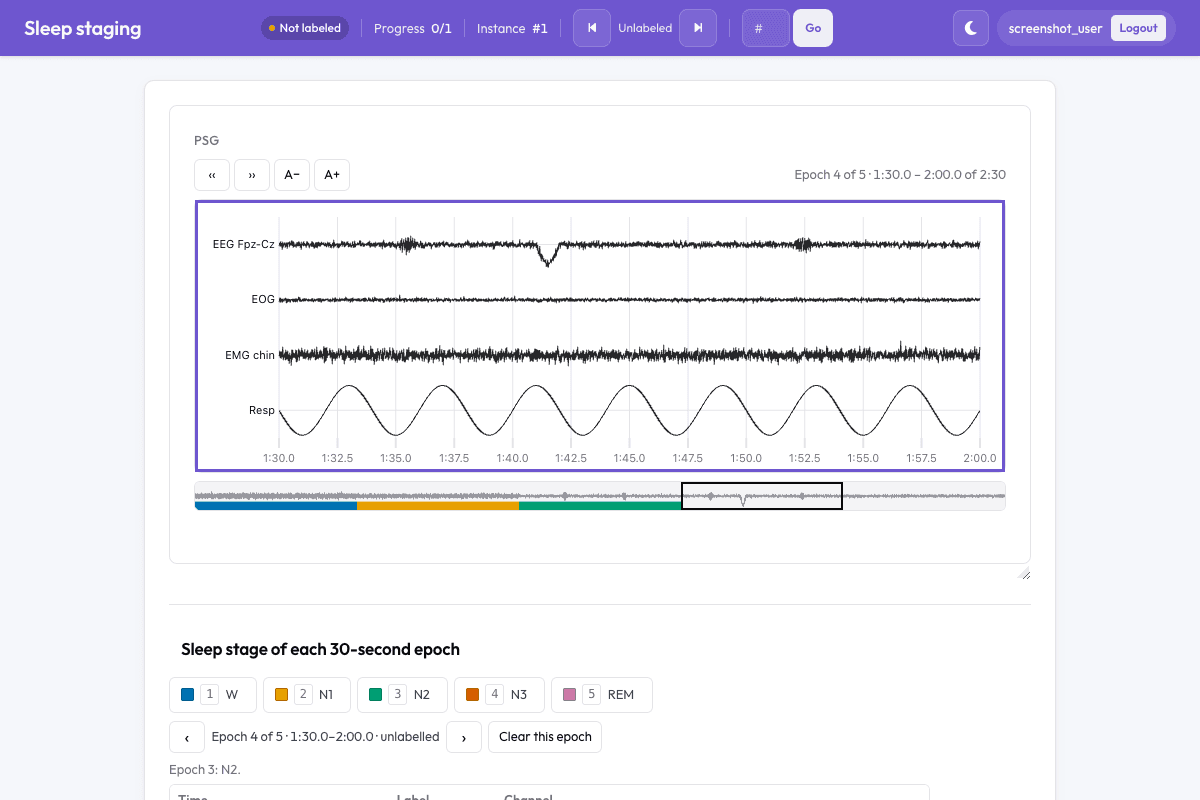 30초 에포크 단위로 수면 단계를 판정합니다
- 형식: EDF와 EDF+(연속 및 불연속), BDF와 BDF+, WFDB 기록, 시간 열이 있는 CSV 또는 TSV, Parquet, 작은 인라인 JSON 객체. EDF와 BDF 파일은 메모리 매핑되며 추가 라이브러리가 필요 없습니다.
- 기존 레이블: EDF+ 주석, WFDB
.atr파일, Brain Imaging Data Structure(BIDS)events.tsv는 사전 주석으로 불러옵니다. 주석자는 사전 주석을 유지하거나 수정하거나 버립니다. - 긴 기록: 브라우저는 기록을 내려받지 않습니다. 서버는 화면에 보이는 범위에 대해 채널당 픽셀마다 최대 두 개의 값(원시 샘플, 또는 각 픽셀의 최솟값과 최댓값)을 보냅니다. 따라서 8시간 기록도 30초 기록과 거의 같은 속도로 열립니다.
- 오프라인: 신호 파일은 Potato 서버의 미디어 디렉터리 또는 작업 디렉터리에서 읽습니다. URL, 절대 경로,
..탈출은 거부됩니다.
WFDB 기록과 Parquet 파일에는 signals 엑스트라(wfdb와 pyarrow)가 필요합니다.
pip install 'potato-annotation[signals]'설정
아래 설정은 채널 네 개의 수면다원검사에 대해 30초 에포크의 수면 단계 판정을 구성합니다. 두 번째 스킴은 같은 플롯을 클릭하여 각성을 표시합니다.
annotation_task_name: "Sleep staging"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/psg.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: signal               # item field holding the EDF file name
      type: time_series
      label: "PSG"
      display_options:
        window: 30
        channels:
          - {name: "EEG Fpz-Cz", range: [-120, 120]}
          - {name: "EOG", range: [-150, 150]}
          - "EMG chin"
          - "Resp"

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: interval_label
    name: stage
    description: "Sleep stage of each 30-second epoch"
    signal_field: signal
    mode: epoch
    epoch_length: 30
    require_all_epochs: true    # counted only while the scheme is required
    label_requirement: {required: true}
    labels:
      - {name: W, key_value: "1"}
      - {name: N1, key_value: "2"}
      - {name: N2, key_value: "3"}
      - {name: N3, key_value: "4"}
      - {name: REM, key_value: "5"}
    preannotation_labels:       # EDF+ hypnogram names -> scheme labels
      "Sleep stage W": W
      "Sleep stage 1": N1
      "Sleep stage 2": N2
      "Sleep stage 3": N3
      "Sleep stage R": REM
      "Arousal": null

  - annotation_type: interval_label
    name: arousals
    description: "Arousals (click on the plot)"
    signal_field: signal
    mode: free
    pre_annotations: false
    labels:
      - {name: arousal, key_value: "a", kind: event}
channels 목록은 레인과 그 순서를 고르며, range는 채널 단위로 레인의 진폭 스케일을 고정합니다. 범위를 고정하면 모든 에포크에서 EEG 레인이 같은 스케일을 유지합니다. preannotation_labels 매핑은 EDF+ 수면 단계도의 단계 이름을 스킴의 레이블로 바꾸고 파일의 각성 항목은 버립니다. 두 번째 스킴은 pre_annotations를 끄며, 주석자는 거기서 각성을 직접 표시합니다. require_all_epochs와 label_requirement를 함께 쓰면 모든 에포크에 단계가 붙을 때까지 다음 버튼이 막혀 있습니다. 각 스킴의 signal_field는 time_series 필드의 key와 같아야 하며, 일치하지 않으면 서버가 시작을 거부합니다.
각 항목은 media_directory 기준으로 신호 파일을 지정합니다.
{"id": "night-01", "note": "Night 1", "signal": "psg/night-01.edf"}EEG 검토를 위한 자유 모드
EEG 검토는 자유 모드를 사용합니다. 자유 모드에서 주석자는 플롯을 가로질러 드래그해서 구간에 레이블을 달고 클릭해서 시점 이벤트를 표시합니다. 아래의 부분 블록은 위 설정의 annotation_schemes를 대체합니다.
annotation_schemes:
  - annotation_type: interval_label
    name: eeg_events
    description: "Mark artifacts and seizures, and click each spike"
    signal_field: signal
    mode: free
    channel_scope: either       # all channels, or the lane the drag starts on
    labels:
      - {name: artifact, key_value: "1"}
      - {name: seizure, key_value: "2"}
      - {name: spike, key_value: "3", kind: event}
channel_scope: either이면 주석자는 플롯 위의 토글로 새 구간을 모든 채널에 적용할지 한 레인에 적용할지 고릅니다. 전극 아티팩트는 한 레인에만 있을 수 있고 전신 발작은 모든 채널에 걸쳐 있습니다. 판정된 에포크 안에서 무호흡이나 각성을 표시하려면 에포크 스킴을 유지하고 같은 signal_field를 가진 자유 모드 스킴을 추가하세요. 위의 수면 설정이 이런 방식으로 각성을 표시합니다. 두 스킴에는 서로 다른 레이블 키를 주세요.
신호 파일
항목에 지정된 파일의 확장자가 리더를 정합니다.
| 확장자 | 형식 | 필요한 것 |
|---|---|---|
.edf | EDF, EDF+(연속 및 불연속) | 없음 |
.bdf | BioSemi BDF, BDF+(24비트) | 없음 |
.hea | WFDB 기록(헤더와 헤더가 나열한 .dat 파일) | signals 엑스트라 |
.csv, .tsv | 시간 열 하나와 채널당 열 하나 | 없음 |
.parquet, .pq | 같은 구성을 Parquet로 | signals 엑스트라 |
.json | 파일에 담긴 아래의 인라인 객체(최대 50 MB) | 없음 |
- EDF+. 지속 시간이 있는 각 주석은 모든 채널에 걸친 사전 주석 구간이 되고, 지속 시간이 없는 각 주석은 시점 이벤트가 됩니다. EDF+D 파일에서는 각 데이터 레코드가 시간 기록 주석이 주는 시작 시점에 놓이며 레코드 사이의 공간은 선의 끊김으로 그려집니다. 헤더가 말한 것보다 짧은 파일은 마지막으로 완전한 레코드까지 읽으며 플롯 아래에 경고가 표시됩니다.
- WFDB. 기록은
.hea파일로 지정하고 신호 파일은 같은 디렉터리에 둡니다.<record>.atr의 박동 주석은 기호(N,V, ...)가 레이블인 시점 이벤트가 되며,(AFIB같은 리듬 주석은 다음 리듬 변화까지 이어지는AFIB구간이 됩니다. 샘플은 한 번에 한 창씩 읽으므로 긴 홀터 기록도 통째로 불러오지 않습니다. 리더가 다중 세그먼트 기록을 지원하지 않으므로 다중 세그먼트 기록은 불러오기 전에 합치세요. - CSV와 Parquet. 시간 열은
time_column이 설정되어 있으면 그것이고, 아니면time,t,timestamp,seconds,sec,time_s,datetime,mjd,jd라는 이름의 첫 열이며, 그것도 없으면 첫 열입니다. 나머지 모든 숫자 열은 채널이고 헤더의 단위(ax (g),ay [m/s^2])는 채널의 단위가 됩니다. 시간 간격이 모두 중앙값 간격의 0.1% 이내인 시리즈는 규칙적으로 샘플링된 것으로 취급하고, 그 밖의 시리즈는 각 샘플의 고유한 시간을 유지합니다. CSV와 Parquet 파일은 통째로 불러오며 256 MB로 제한됩니다. 더 큰 기록은 EDF로 변환하세요. - 인라인 JSON. 작은 신호는 항목 자체에 넣을 수 있으며 모든 채널을 합쳐 최대 500,000개의 샘플입니다.
인라인 객체는 규칙적인 샘플에는 sampling_rate를, 광도 곡선 같은 불규칙한 시리즈에는 샘플마다 시간 하나씩인 time 목록을 줍니다. 두 키는 채널별로도 설정할 수 있습니다. t0은 최상위 또는 채널별로 첫 샘플의 시간을 정합니다. data의 null은 누락된 샘플이며, start_time은 time_format: clock을 위해 t = 0의 벽시계 시간을 줍니다.
{"id": "demo", "signal": {
  "sampling_rate": 100,
  "start_time": "2024-01-01T22:00:00",
  "channels": [
    {"name": "Fz", "unit": "uV", "data": [0.1, 0.4, 0.2]},
    {"name": "Resp", "unit": "a.u.", "sampling_rate": 10, "data": [0.0, 0.3]}
  ]
}}
시간은 EDF, BDF, WFDB, 그리고 sampling_rate가 있는 인라인 데이터에서 기록 시작부터의 초입니다. CSV와 Parquet에서는 시간 열에 쓰인 값(초, 일, MJD) 그대로이며, 날짜-시간 열은 첫 행부터의 초가 됩니다. 저장되는 레이블은 파일과 같은 시간 기준을 사용합니다.
디스플레이 옵션
옵션은 display_options 아래 또는 필드에 직접 둡니다.
time_series 옵션 | 기본값 | 의미 |
|---|---|---|
window | 30 | 처음에 보여 주는 초이자 다음 및 이전 컨트롤의 이동 단위 |
channels | 전체 | 이름 또는 {name, label, range: [low, high], color}로 나타낸, 순서대로 보여 줄 채널 |
layout | stacked | stacked는 채널당 레인 하나를, overlay는 모든 채널을 범례와 함께 하나의 y축에 놓습니다 |
draw | line | line, 또는 성기고 불규칙한 시리즈를 위한 points |
amplitude | recording | recording은 각 레인을 파일 전체에 걸친 채널의 범위(0.5에서 99.5 백분위수)로 스케일링하고, window는 화면에 보이는 범위로 다시 스케일링합니다. 채널의 range는 두 설정을 모두 재정의합니다 |
lane_height | 56 | 쌓기 배치에서 레인당 픽셀 수이며 20에서 400 사이 |
height | 레인에서 | 80에서 4000 사이의 픽셀 단위 플롯 높이. 값이 없으면 높이는 레인 수 곱하기 lane_height 더하기 48이며 160에서 1400 사이로 유지됩니다 |
time_format | auto | elapsed(h:mm:ss), clock(start_time에서의 벽시계 시간), number. auto는 time_unit이 s이면 elapsed, 아니면 number입니다 |
time_unit | s | 일이나 MJD 단위의 CSV 또는 Parquet 데이터를 위한 시간 열의 단위 |
invert_y | false | 천문학의 등급을 위해 겹침 배치에서 y축을 뒤집습니다 |
time_column | 자동 | CSV 또는 Parquet의 시간 열 |
annotation_extension | atr | 사전 주석으로 읽는 WFDB 주석 파일, 없으면 null |
max_file_mb | 2048 | 읽는 신호 파일의 최대 크기(메가바이트). 더 큰 파일은 거부됩니다 |
overview | true | 플롯 아래에 전체 기록, 레이블이 붙은 구간, 현재 창을 보여 주는 띠를 표시합니다. 띠를 클릭하거나 드래그하면 창이 이동합니다 |
engine 옵션은 uplot 한 가지 값만 받습니다. 신호 파일은 항상 서버에서 읽으므로 디스플레이는 allow_remote를 거부합니다.
스킴 옵션
interval_label 옵션 | 기본값 | 의미 |
|---|---|---|
signal_field | 필수 | 레이블을 달 time_series 필드의 key |
labels | 필수 | 이름, 또는 {name, key_value, color, kind, tooltip}. kind는 interval(기본값) 또는 event입니다 |
mode | free | 드래그와 클릭을 위한 free, 고정된 창을 순서대로 레이블링하는 epoch |
epoch_length | 30 | 에포크당 초 |
channel_scope | all | all은 모든 채널에, channel은 드래그를 시작한 레인에 레이블을 적용하며, either는 토글을 보여 줍니다 |
auto_advance | true | 에포크 모드에서 레이블 키를 누른 뒤 다음 에포크로 이동합니다 |
allow_overlap | 자유 모드에서 true, 에포크 모드에서 false | false이면 새 구간이 같은 채널의 다른 구간과 겹친 부분을 대체합니다 |
next_key, previous_key | ], [ | 창을 이동하는 키 |
pre_annotations | true | 파일 자체의 주석(EDF+, WFDB .atr, 인라인)에서 시작하며, 파일에 주석이 없으면 학습된 signal-cnn 모델의 구간에서 시작합니다. false는 둘 다 끕니다 |
preannotation_field | 없음 | BIDS events.tsv 경로 또는 저장 형태의 주석을 담은 항목 필드 |
preannotation_labels | 없음 | 파일 레이블을 스킴 레이블로 바꾸며, null로 대응된 레이블은 버립니다. 이름이 바뀐 주석은 스킴이 같은 종류로 그 레이블을 선언한 경우에만 유지됩니다 |
require_all_epochs | false | 에포크 모드에서 모든 에포크에 레이블이 붙을 때까지 다음 버튼이 막혀 있습니다. 스킴이 필수일 때 적용됩니다 |
min_annotations | 없음 | 항목에 지정한 수 이상의 구간과 이벤트가 생길 때까지 다음 버튼이 막혀 있습니다. 스킴이 필수일 때 적용됩니다 |
instructions | 없음 | 레이블 위에 표시하는 텍스트 |
key_value가 없는 레이블은 키 1에서 9, 이어서 q에서 p를 받습니다. 레이블 색은 기본적으로 Okabe-Ito 팔레트입니다. Okabe-Ito 색은 흔한 색각 이상에서도 구별됩니다.
에포크 채점과 구간 표시
에포크 모드에서 기록은 시작부터 epoch_length 창으로 나뉘며, 주석자는 한 번에 에포크 하나를 봅니다. 단계 키는 현재 에포크에 레이블을 달고 다음으로 이동하며, [와 ](또는 Page Up과 Page Down)는 레이블 없이 이동하고, "Clear this epoch"는 레이블을 제거합니다. 개요 띠는 채점된 모든 에포크를 단계별로 색칠하며, 띠를 클릭하면 창이 클릭한 지점으로 이동합니다.
자유 모드에서 주석자는 레이블 키를 누르거나 레이블 버튼을 클릭한 뒤, 플롯을 가로질러 드래그해서 구간에 레이블을 달거나, 이벤트 레이블이면 클릭해서 시점을 표시합니다. 구간 레이블을 고른 상태에서 클릭하면 포인터 아래의 항목이 선택되고, 레이블 키는 그 항목의 레이블을 바꾸고, Delete는 항목을 제거하며, Escape는 선택을 해제합니다. 모든 항목은 Show와 Delete 버튼과 함께 플롯 아래에 나열되며, 이 목록은 마우스 없이 레이블을 검토하는 키보드 경로입니다.
A− 및 A+ 버튼은 모든 레인의 진폭을 낮추거나 높입니다. 포커스가 있는 플롯에서 왼쪽과 오른쪽 화살표 키는 Potato의 다른 곳처럼 항목 사이를 이동하지 않고 한 창씩 이동합니다. Shift와 화살표 키는 창의 10분의 1만큼 이동합니다.
항목에 저장된 답이 없으면 파일의 주석이 메모와 함께 점선 오버레이로 표시됩니다. 오버레이는 주석자의 첫 변경 또는 "Keep these"로 저장되며, "Discard them"은 오버레이를 지웁니다. 에포크 모드에서 파일의 수면 단계도 구간은 그 구간이 절반 이상 덮는 에포크들로 나뉩니다.
학습된 모델의 구간
v2.14.0의 새 기능
연구에서 주석자가 표시한 구간으로 signal-cnn 모델을 학습시키고, 나머지 기록에 모델의 구간을 표시할 수 있습니다. 에포크 모드에서는 모델이 모든 에포크에 레이블을 붙이고, 자유 모드에서는 모델이 레이블이 붙은 구간을 표시합니다. 점 이벤트는 학습하지도 예측하지도 않습니다. model_training.writeback.schemas가 스킴을 지정하면 모델의 구간이 같은 점선 오버레이로 표시되고 "· from the model"과 함께 목록에 나옵니다. 기록 자체의 주석이 우선하며, 파일과 preannotation_field가 아무것도 주지 않을 때만 모델의 구간을 씁니다. 과학 모델에서 모델을 학습시키는 방법을 다룹니다.
저장되는 답
각 스킴은 항목당 JSON 객체 하나를 저장합니다.
{"intervals": [{"start": 30.0, "end": 60.0, "label": "N2", "channel": null},
               {"start": 41.2, "end": 43.0, "label": "artifact", "channel": "EOG"}],
"events": [{"time": 52.25, "label": "arousal", "channel": null, "source": "file"}]}channel은 채널 이름이며, 모든 채널이면 null입니다. 파일에서 왔고 바뀌지 않은 항목은 "source": "file"을 유지하며, 학습된 모델에서 왔고 바뀌지 않은 항목은 "source": "model"을 유지합니다.
내보내기
여러 주석자가 같은 기록을 채점할 수 있으며 num_annotators_per_item이 그 수를 정합니다. 두 신호 내보내기 모두 각 주석자의 레이블을 따로 보관합니다.
| 형식 | 출력 |
|---|---|
interval_label | intervals.csv와 intervals.jsonl이며 구간 또는 이벤트당 한 행에 user_id, instance_id, schema, kind, start, end, duration, label, channel, source를 가집니다. 이벤트는 start가 end와 같고 지속 시간이 0이며, 주석자 항목은 source가 annotator로 설정되고, 바뀌지 않은 사전 어노테이션은 file 또는 model로 설정됩니다 |
bids_events | 주석자와 항목마다 <annotator>/<instance>_events.tsv이며 onset, duration, trial_type, channel(모든 채널이면 n/a)을 가지고 events.json 사이드카가 함께 만들어집니다. interval_label 스킴이 여럿이면 각 스킴이 자기 폴더를 받습니다 |
python -m potato.export -c config.yaml -f bids_events -o exports/bids일반 CSV 및 JSONL 내보내기는 답을 스킴당 JSON 셀 하나로 담습니다. 에포크 모드에서는 채점된 각 에포크가 별도의 구간입니다. 따라서 intervals.csv 파일은 주석자당 에포크마다 한 행을 가집니다. Potato의 합의도 지표는 interval_label 스킴을 다루지 않습니다. 내보낸 뒤 intervals.csv에서 수면 단계에 대한 Cohen의 카파 같은 에포크별 통계량을 계산하세요.
예제
python potato/flask_server.py start examples/advanced/time-series-intervals/config-epochs.yaml -p 8000이 예제에서 주석자는 항목 두 개에서 30초 에포크를 채점하며, 두 항목 모두 합성한 5분 길이의 EDF+ 수면다원검사 하나를 가리킵니다. config-epochs.yaml 옆의 config.yaml은 같은 기록과, BIDS events.tsv가 있는 2분 길이의 손목 가속도계 CSV에 대해 자유 모드를 실행합니다.
코딩 에이전트로 연구 설정하기
potato-skill 1.2.0은 Potato 2.13.1을 대상으로 하며 interval_label과 time_series를 이름으로 압니다. 이 스킬은 연구 설계 측면을 안내합니다. 주석자에게 무엇을 물을지, 기록당 몇 명의 주석자가 채점할지, 훈련과 주의 점검, 내보내기가 여기에 포함됩니다. 이 스킬은 아직 신호 파일 형식, 디스플레이 옵션, signals 엑스트라를 문서화하지 않습니다. potato-skill을 설치하고 에이전트에게 연구를 설명한 뒤, 형식과 옵션은 이 페이지의 Markdown 사본을 가리켜 알려 주세요. Markdown 사본은 https://www.potatoannotator.com/docs/annotation-types/time-series.md에 있습니다.
더 읽을거리
- 인스턴스 표시 - 디스플레이 필드를 설정하는 방법
- 스펙트로그램 주석 - 오디오의 시간-주파수 상자
- 내보내기 형식 - Potato의 내보내기 형식과 내보내기 명령
- 과학 모델 - 표시한 구간으로
signal-cnn모델 학습시키기 - 애너테이터는 몇 명이 필요한가? - 항목당 주석자 수 정하기
- 의료 - 임상 및 생의학 주석을 위한 Potato
구현 세부 사항은 소스 문서를 참고하세요.