스펙트럼 피크 선택과 적분
JCAMP-DX 또는 mzML 파일에서 읽은 NMR, IR, 질량 스펙트럼의 피크를 선택하고 적분하며, 제안된 피크를 수락하거나 거부하고 피크당 CSV 한 행을 얻습니다.
v2.13.0에서 추가
spectrum 디스플레이는 항목당 스펙트럼 하나를 브라우저에서 그리고, peak_picking 스킴은 주석자가 선택한 피크, 적분한 영역, 수락하거나 거부한 제안 피크를 기록합니다. 화학자와 분광학자는 이 둘을 NMR 분광법의 피크 목록, 적외선 분광법의 띠 귀속, 질량 스펙트럼의 피크 주석처럼 레이블이 붙은 스펙트럼 데이터셋을 만드는 데 사용합니다. 교수자는 같은 스펙트럼에 대한 각 학생의 피크 목록을 모아 내보낸 뒤 채점합니다. 자동 피크 선택기를 운영하는 그룹은 선택기의 피크를 제안으로 불러오고, 주석자는 제안된 각 피크를 수락하거나 거부합니다.
피크 선택은 스펙트럼에서 각 피크의 위치와 강도를 나열합니다. 1H NMR 스펙트럼에서 다중선의 적분값은 그 다중선을 일으키는 양성자 수에 비례합니다. 주석자는 다중선을 가로질러 드래그해서 적분합니다.
JCAMP-DX는 IUPAC이 관리하는 분광 데이터용 텍스트 형식입니다. mzML은 HUPO Proteomics Standards Initiative의 질량 분석 데이터용 XML 형식입니다. mzML 파일 하나는 한 번의 실행에서 얻은 스펙트럼을 담습니다.
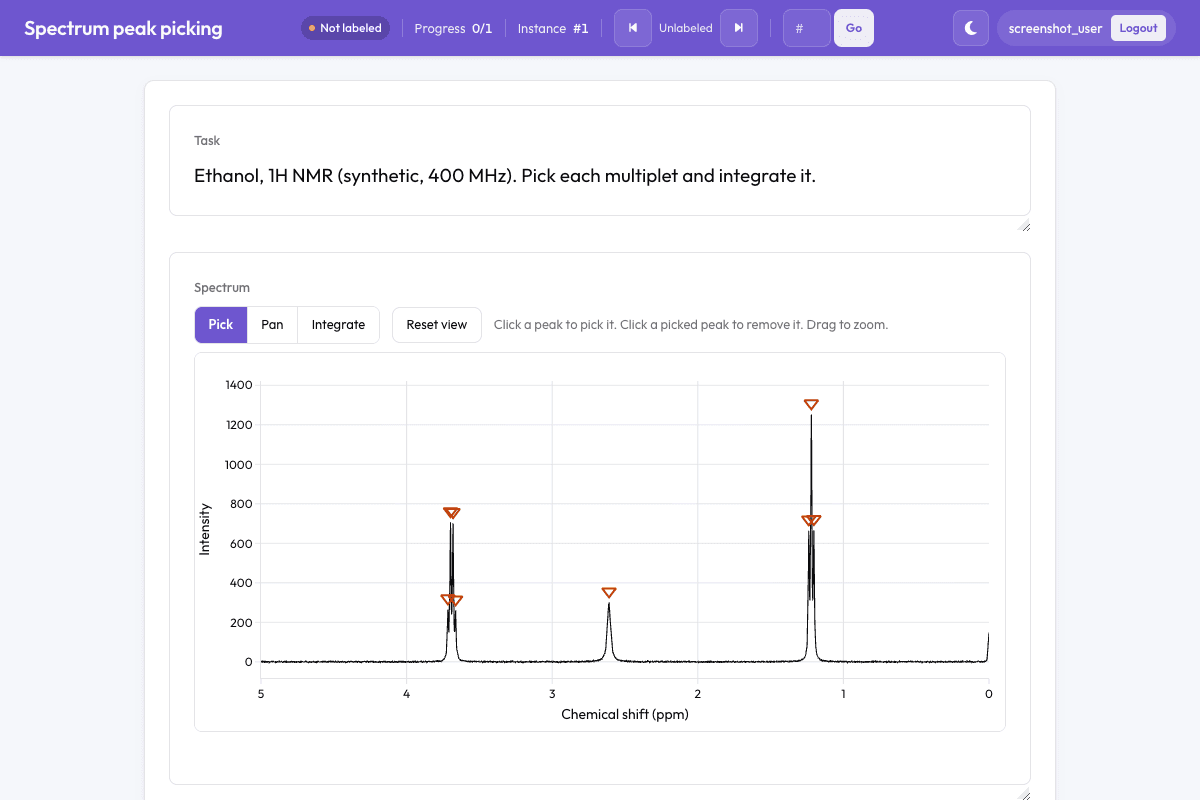 제안된 피크는 어노테이터가 각각 수락하거나 거부할 때까지 대기합니다
- 엔진: Potato 저장소는 Plotly 2.27.0(MIT)을 포함하며, Potato는 스펙트럼이 있는 페이지에서만 Plotly를 불러옵니다. Plotly는 SVG를 그리므로 디스플레이에 WebGL이 필요 없습니다.
- 형식: JCAMP-DX(
.jdx,.dx,.jcamp), mzML(.mzML), 두 열 텍스트(.csv,.tsv,.txt,.xy). 스펙트럼을 두 목록으로 항목 안에 직접 쓸 수도 있습니다. - 긴 스펙트럼: 파일은 서버에서 파싱하며, 브라우저는 최대
max_points개(기본값 4,000)의 점을 받습니다. 원본 스펙트럼의 각 구간은 가장 낮은 점과 가장 높은 점을 유지합니다. 따라서 좁은 NMR 선도 전체 높이를 유지합니다. 확대하면 보이는 범위의 원본 점을 가져오며, 서버는 그 범위에max_points보다 많은 점이 있을 때에만 다시 다운샘플링합니다. - 축 규칙: 화학적 이동과 파수 축은 왼쪽에서 오른쪽으로 높은 값에서 낮은 값으로 이어집니다. Hz로 저장된 NMR 스펙트럼은 파일의
.OBSERVE FREQUENCY로 ppm으로 변환됩니다. - 오프라인: 스펙트럼 파일은 Potato 서버의 미디어 디렉터리에서 읽습니다. URL로 지정한 스펙트럼은 거부되며 Potato는 스펙트럼을 내려받지 않습니다.
JCAMP-DX와 CSV 파일에는 추가 설치가 필요 없고, scipy가 핵심 의존성이므로 피크 검출에도 추가 설치가 필요 없습니다. mzML만 spectra 엑스트라(pyteomics, psims, lxml)가 필요합니다.
pip install 'potato-annotation[spectra]'설정
아래 설정은 1H NMR 피크 선택을 구성합니다. 디스플레이는 자동 검출로 찾은 피크를 제안하고, 주석자는 각 제안을 수락하거나 거부하며, 각 피크에 귀속과 다중도를 주고, 각 다중선을 적분합니다.
annotation_task_name: "1H NMR peak picking"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/spectra.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: spectrum               # item field naming the spectrum file
      type: spectrum
      label: "1H NMR"
      display_options:
        prepick:                  # suggested peaks, off unless set
          method: detect
          prominence: 0.05
          max_peaks: 30

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: peak_picking
    name: peaks
    description: "Pick the peaks, assign each one, and integrate each multiplet"
    viewer_field: spectrum
    peak_fields:
      - name: assignment
        placeholder: "e.g. OCH2"
      - name: multiplicity
        options: [s, d, t, q, m, br]
    region_fields:
      - name: protons
        label: "nH"
    min_peaks: 1
    require_review: true          # every suggestion accepted or rejected
label_requirement: {required: true}options가 있는 필드는 선택 필드이고, options가 없는 필드는 텍스트 상자입니다. 디스플레이는 NMR 선 스펙트럼에서 Integrate 모드를 스스로 켭니다. min_peaks, require_review, label_requirement를 함께 쓰면 주석자가 피크를 하나 이상 선택하고 모든 제안을 수락하거나 거부할 때까지 다음 버튼이 막혀 있습니다. 스킴의 viewer_field는 spectrum 필드의 key와 같아야 하며, 일치하지 않으면 서버가 시작을 거부합니다.
각 항목은 media_directory 기준으로 스펙트럼 파일을 지정합니다.
{"id": "ethyl_acetate", "note": "1H NMR, 400 MHz, CDCl3.", "spectrum": "spectra/ethyl_acetate_1h.jdx"}자동 피크 선택기 검토
피크 선택기의 출력을 검토하려면 선택기의 피크를 각 항목에 넣습니다. 그러면 주석자는 제안된 각 피크를 수락하거나 거부하기만 할 수 있습니다.
annotation_task_name: "Peak picker review"
task_dir: .
media_directory: media
output_annotation_dir: annotation_output
data_files: [data/review.json]
item_properties: {id_key: id, text_key: note}

instance_display:
  fields:
    - key: spectrum
      type: spectrum
      display_options:
        prepick: {method: item}   # the peaks listed in each item

user_config:
  allow_all_users: true

annotation_schemes:
  - annotation_type: peak_picking
    name: review
    description: "Accept the real peaks and reject the rest"
    viewer_field: spectrum
    peak_fields: []
    region_fields: []
    require_review: true
    allow_manual: false
label_requirement: {required: true}{"id": "ethanol", "note": "Peaks from the automatic picker.",
"spectrum": {"file": "spectra/ethanol_1h.jdx", "peaks": [3.69, 2.61, 1.22, {"x": 7.26, "label": "CHCl3"}]}}제안 피크는 항목의 peaks 목록에 있는 숫자 또는 {x, y, label} 매핑입니다. y가 없으면 스펙트럼의 x 위치에서 읽으며, label은 주석자가 제안을 수락할 때 피크의 label 필드로 저장됩니다. allow_manual: false이면 제안에서 벗어난 곳을 클릭해도 아무것도 선택되지 않고 "Add a peak at" 상자가 제거됩니다. peak_fields: []와 region_fields: []이면 스킴은 각 피크 옆에 텍스트를 요구하지 않습니다.
학습된 피크 모델의 제안
v2.14.0의 새 기능
연구에서 주석자가 유지한 피크로 peak-cnn 모델을 학습시키고, 나머지 스펙트럼에 모델의 피크를 제안으로 표시할 수 있습니다. 모델은 피크 위치만 예측합니다. 수락한 피크마다 귀속과 다중도는 여전히 주석자가 지정합니다. model_training.writeback.schemas가 peak_picking 스킴을 지정하고 표시에 prepick이 설정되어 있으면 모델의 피크가 표시에 나타납니다. prepick: {method: model}이면 표시는 모델의 피크만 제공하며, 플롯 아래 목록은 각 피크에 "· model"을 붙입니다. 수락한 모델 피크는 source: model로 저장되고 내보내집니다. 과학 모델에서 모델을 학습시키고 모델의 피크를 항목에 되쓰는 방법을 다룹니다.
질량 스펙트럼과 IR 스펙트럼
중심화된 mzML 스캔은 막대로 그려지며 클릭하면 가장 가까운 막대를 선택합니다. 피크 표만 있는 JCAMP-DX 파일도 막대로 그려지며, 대부분의 JCAMP-DX 질량 스펙트럼이 그런 파일입니다. 아래의 부분 블록은 질량 스펙트럼용 디스플레이 옵션을 보여 주며, 파일 자체의 피크 표에서 가장 높은 피크 20개를 제안으로 제공합니다.
instance_display:
  fields:
    - key: spectrum
      type: spectrum
      display_options:
        prepick: {method: file, max_peaks: 20}
mzML 항목은 스캔을 지정하고, JCAMP-DX 복합 파일은 블록을 지정합니다.
{"id": "r7", "spectrum": {"file": "runs/sample1.mzML", "scan": 1043}}
{"id": "c2", "spectrum": {"file": "spectra/compound.jdx", "block": 1}}
투과도 또는 반사도의 IR 스펙트럼에서는 디스플레이가 최솟값을 선택합니다. 잡음이 많은 IR 스펙트럼에는 0.1처럼 더 높은 prominence가 필요합니다.
스펙트럼 데이터
항목 필드는 미디어 디렉터리의 파일 이름이거나 아래 표의 키를 가진 매핑입니다.
| 키 | 의미 |
|---|---|
file 또는 path | media_directory 기준의 스펙트럼 파일 |
scan, index | mzML 실행에서 보여 줄 스펙트럼. index는 실행에서 0부터 시작하는 위치이고, scan은 네이티브 ID의 scan=N 부분입니다. scan이나 index가 없으면 첫 스펙트럼을 보여 줍니다 |
block | 보여 줄 JCAMP-DX 복합 파일의 블록이며 0부터 시작하고 데이터를 담은 블록만 셉니다 |
peaks | prepick 방법 item을 위한 제안 피크이며 숫자 또는 {x, y, label} 매핑 |
x, y | 길이가 같은 두 목록으로 된 인라인 스펙트럼 |
x_units, y_units, kind, title, sticks | 인라인 스펙트럼의 단위, 스펙트럼 종류, 제목, 막대 그리기 |
그 밖의 키는 허용되는 키를 알려 주는 메시지와 함께 거부됩니다. 인라인 NMR 스펙트럼은 아래 줄과 같습니다.
{"id": "s1", "spectrum": {"x": [0.5, 1.0, 1.5], "y": [3, 40, 2], "x_units": "PPM", "kind": "nmr"}}Potato는 JCAMP-DX를 직접 읽으며, 모든 ASDF 압축 형태의 ##XYDATA(DIF Y-check 검증 포함), ##XYPOINTS, ##PEAK TABLE, Bruker와 MestReNova가 쓰는 ##NTUPLES 형태, ##BLOCKS가 있는 복합 파일이 포함됩니다. XYDATA 옆의 피크 표는 파일 자체의 피크 목록이며, prepick 방법 file이 그 목록을 제안으로 제공합니다. 가로축이 없는 FID, 2D NMR, JCAMP-CS 구조는 읽지 않습니다.
CSV 파일은 쉼표, 탭, 세미콜론, 공백으로 구분된 두 열(x, y)을 가집니다. #로 시작하는 줄은 주석이며, 선택적인 헤더 행은 shift (ppm), wavenumber (cm-1), transmittance (%T)처럼 괄호 안 텍스트로 단위를 정합니다. mzML은 DOCTYPE도 엔티티도 쓰지 않으므로 DOCTYPE 또는 엔티티를 선언한 mzML 파일은 파싱 전에 거부됩니다.
옵션
spectrum 디스플레이 옵션 | 기본값 | 의미 |
|---|---|---|
spectrum_type | auto | nmr, ir, raman, uv, ms, other. auto는 JCAMP-DX의 DATA TYPE을 읽거나 x 단위에서 종류를 추론합니다 |
x_reversed | auto | true는 x를 높은 값에서 낮은 값으로 그립니다. auto는 NMR(ppm 또는 Hz)과 IR(cm⁻¹) 축을 뒤집습니다 |
x_label, y_label | 단위에서 | "Chemical shift (ppm)"나 "Wavenumber (cm⁻¹)" 같은 축 제목 |
mode | auto | line 또는 sticks. auto는 피크 표나 중심화된 mzML 스캔을 막대로 그립니다 |
peak_direction | auto | max 또는 min. auto는 투과도와 반사도에 min을 사용합니다 |
integrate | auto | Integrate 모드를 제공합니다. auto는 NMR 선 스펙트럼에서만 Integrate 모드를 켭니다 |
prepick | 꺼짐 | 제안 피크. true 또는 다음 표의 키를 가진 매핑 |
snap | true | 클릭하면 정확한 포인터 위치 대신 포인터에서 9픽셀 이내의 국소 최댓값(또는 최솟값)을 선택합니다 |
max_points | 4000 | 브라우저로 보내는 점의 수이며 200에서 100,000 사이 |
max_file_mb | 50 | 이보다 큰 스펙트럼 파일은 거부됩니다. 최대 500 |
scan, index | 없음 | 모든 항목에서 보여 줄 mzML 스펙트럼. 항목 자체의 scan 또는 index가 우선합니다. 둘 중 하나만 지정합니다 |
block | 없음 | 모든 항목에서 보여 줄 JCAMP-DX 블록 |
height | 380 | 픽셀 또는 CSS 길이로 나타낸 플롯 높이 |
engine | plotly | 유일한 엔진 |
allow_remote | false | 스펙트럼은 서버에서 읽으므로 true는 거부됩니다 |
prepick 키 | 기본값 | 의미 |
|---|---|---|
method | auto | detect는 피크 검출을 실행하고, file은 JCAMP-DX 피크 표를 사용하며, item은 항목의 peaks 목록을 사용하며, model은 학습된 peak-cnn 모델이 항목에 대해 낸 피크를 사용합니다. auto는 item, model, file, detect 순으로 먼저 가능한 것을 사용합니다 |
prominence | 0.05 | detect에서 피크가 주변보다 얼마나 높이 솟아야 하는지를 y 범위의 비율로 나타내며 0보다 크고 1보다 작습니다. 막대에서는 가장 높은 막대에 대한 비율로 나타낸 최소 높이입니다 |
max_peaks | 40 | 가장 두드러진 것을 유지하여 최대 이만큼의 제안이며 1에서 500 사이 |
min_distance | 없음 | detect에서 x 단위로 나타낸 제안 사이의 최소 간격 |
검출은 전체 해상도 스펙트럼에서 prominence 임계값으로 scipy.signal.find_peaks를 실행합니다. 제안된 피크가 주석자를 고착시킬 수 있으므로 제안은 기본적으로 꺼져 있습니다. 주석자가 선택기의 피크를 얼마나 자주 수락하는지 측정하는 연구에는 제안이 켜져 있어야 합니다.
peak_picking 옵션 | 기본값 | 의미 |
|---|---|---|
viewer_field | 필수 | instance_display에 있는 spectrum 필드의 key |
peak_fields | 텍스트 필드 하나, label | 각 피크 옆의 입력이며 {name, type, options, required, placeholder, label}의 목록입니다. []이면 없습니다 |
region_fields | 텍스트 필드 하나, label | 적분한 각 영역에 대한 같은 설정 |
min_peaks | 없음 | 스킴이 필수일 때 이만큼의 피크를 선택할 때까지 항목은 미완료로 남습니다 |
max_peaks | 없음 | 더 많은 피크를 선택하면 메시지와 함께 거부됩니다 |
require_review | false | 스킴이 필수일 때 모든 제안이 수락되거나 거부될 때까지 항목은 미완료로 남습니다 |
allow_manual | true | false이면 피크가 제안에서만 나오며 "Add a peak at"이 제거됩니다 |
instructions | 없음 | 문항 아래의 텍스트 |
label_requirement | 없음 | {required: true}는 스킴을 필수로 만듭니다 |
| 필드 키 | 기본값 | 의미 |
|---|---|---|
name | 필수 | 문자, 숫자, _, -로 이루어진 짧은 식별자. 목록의 문자열 하나는 이름으로 읽습니다 |
type | text, options가 있으면 choice | text 또는 choice |
options | 없음 | choice 필드의 선택지. yes, no, on, off는 따옴표로 감싸야 하며, 그렇지 않으면 YAML이 이 네 단어를 불리언으로 읽습니다 |
required | false | 스킴이 필수인 동안 모든 피크(또는 영역)에서 이 필드를 채워야 합니다 |
placeholder | 없음 | 빈 텍스트 상자의 힌트 텍스트 |
label | 첫 글자를 대문자로 한 이름 | 플롯 아래 표의 열 머리글 |
피크 선택과 적분
플롯 위의 도구 모음에는 모드 세 가지가 있습니다.
| 모드 | 클릭 | 드래그 |
|---|---|---|
| Pick(기본값) | 포인터 아래의 피크를 선택합니다. 선택된 피크를 클릭하면 제거되고, 제안을 클릭하면 제안이 수락됩니다 | 드래그한 상자로 확대합니다 |
| Pan | 없음 | 스펙트럼을 따라 이동합니다 |
Integrate(integrate가 켜져 있을 때) | 포인터 아래의 영역을 제거합니다 | 드래그한 x 범위를 적분합니다 |
플롯에서 더블 클릭하거나 Reset view 버튼을 누르면 다시 축소됩니다. 터치 화면에서는 탭이 클릭처럼 작동합니다.
snap이 켜져 있으면 선 근처를 클릭할 때 그 선의 꼭대기가 선택되므로, 주석자는 다중선의 선들을 분리하려고 확대한 뒤 각 선을 선택합니다. 제안된 피크는 속이 빈 주황색 삼각형으로, 선택된 피크는 피크의 필드 값이 레이블로 붙은 채워진 삼각형으로 그려집니다. 각 영역은 음영이 칠해지고 첫 영역에 대한 상대 적분값이 레이블로 붙으며, 첫 영역은 1.00으로 표시됩니다.
서버는 각 적분을 기준선 보정 없이 영역의 양 끝 사이에 있는 모든 원본 점에 대한 사다리꼴 적분으로 계산합니다. 따라서 다중선보다 넓게 그린 영역은 높게 읽힙니다. 상대 적분값에 고정된 기준이 필요하면 어느 신호를 먼저 적분할지 안내문에 적으세요. integrate: true인 막대 스펙트럼에서 적분은 영역 안의 막대 강도의 합입니다.
플롯 아래에서 스킴은 제안된 피크를 Accept와 Reject 버튼, 그리고 Accept all과 Reject all과 함께 나열합니다. 거부된 제안은 작은 버튼으로 나타나며 그 버튼을 누르면 제안이 복원됩니다. Peaks 표에는 피크당 한 행이 있고, 피크의 위치, 강도, 출처, 필드와 Remove 버튼이 있습니다. Integrals 표에는 영역당 한 행이 있고, 영역의 범위, 적분값, 상대 적분값, 필드가 있습니다. 주석자는 "Add a peak at" 상자에 위치를 입력하고 Enter를 누르며, 제안과 일치하는 위치는 그 제안을 수락합니다. 모든 컨트롤은 버튼이나 양식 필드입니다. 따라서 주석자는 키보드만으로 스펙트럼을 검토할 수 있습니다.
저장되는 답
peak_picking 스킴은 항목당 JSON 객체 하나를 저장합니다.
{"viewer": "spectrum",
 "items": [{"kind": "peak", "x": 2.0399, "y": 3003, "source": "auto", "width": 0.0031,
            "fields": {"assignment": "CH3CO", "multiplicity": "s"}},
           {"kind": "peak", "x": 7.26, "y": 132, "source": "manual"},
           {"kind": "region", "from": 1.969, "to": 2.120, "integral": 15.77,
            "fields": {"protons": "3"}}],
"rejected": [4.1464]}source는 수락한 제안이면 auto, 학습된 피크 모델의 제안을 수락한 것이면 model, 주석자가 추가한 피크이면 manual입니다. width는 검출된 피크의 x 단위 반높이 prominence 전체 폭입니다. rejected는 주석자가 거부한 제안의 위치를 나열합니다. 주석자가 수락도 거부도 하지 않은 제안은 저장되지 않으며, 필수 스킴의 require_review는 모든 제안이 두 목록 중 하나에 들어가도록 보장합니다.
내보내기
peak_table 내보내기는 피크, 영역, 거부된 제안마다 한 행을 씁니다.
python -m potato.export --config config.yaml --format peak_table --output out/내보내기는 peaks.csv와 peaks.jsonl을 쓰며, --option format=csv 또는 --option format=jsonl은 해당하는 파일만 씁니다. JSONL 행은 빈 열을 제외합니다.
| 열 | 내용 |
|---|---|
user_id, instance_id, schema | 주석자, 항목, 스킴 |
kind | peak, region, rejected |
x, y, width | 피크의 위치, 강도, 폭(검출된 피크만). rejected 행은 x만 가집니다 |
from, to, integral, relative | 영역의 범위, 적분값, 같은 답의 첫 영역에 대한 상대 적분값 |
source | 피크는 auto, model, manual 중 하나. 영역은 manual이고 거부된 제안은 auto입니다 |
label | 행의 필드 값을 " / "로 이은 문자열 |
| 필드당 열 하나 | assignment와 multiplicity 등이며, 이름이 위의 열과 같으면 field_ 접두사가 붙습니다 |
여러 주석자가 같은 스펙트럼에서 피크를 선택할 수 있으며, num_annotators_per_item이 그 수를 정합니다. 일반 CSV와 JSONL 내보내기도 답을 스킴당 JSON 셀 하나로 담습니다. Potato의 합의도 지표는 peak_picking 스킴을 다루지 않습니다. 내보낸 뒤 peaks.csv에서 주석자의 피크 목록을 비교하세요(예를 들어 한 항목의 피크를 ppm 또는 cm⁻¹ 허용 오차 안에서 대응시킵니다). 피크 선택기 검토에서는 source: auto 피크 행과 rejected 행의 수가 각 주석자의 수락률을 줍니다. 학습된 모델의 제안은 대신 source: model 피크 행을 세십시오.
예제
python potato/flask_server.py start examples/advanced/spectrum-peak-picking/config.yaml -p 8000이 예제에는 Hz 단위의 DIFDUP 압축 JCAMP-DX인 합성 1H NMR 스펙트럼 두 개(아세트산 에틸과 에탄올)와 CSV인 합성 IR 투과도 스펙트럼 하나가 있습니다. 검출된 제안과 require_review가 켜져 있습니다. 세 스펙트럼은 모두 지어낸 것입니다. 같은 디렉터리의 generate_spectra.py가 파일을 다시 생성합니다.
코딩 에이전트로 연구 설정하기
potato-skill 1.2.0은 Potato 2.13.1을 대상으로 하며 peak_picking과 spectrum을 이름으로 압니다. 이 스킬은 연구 설계 측면을 안내합니다. 주석자에게 무엇을 물을지, 스펙트럼당 몇 명의 주석자가 피크를 선택할지, 훈련과 주의 점검, 내보내기가 여기에 포함됩니다. 이 스킬은 아직 스펙트럼 파일 형식, 디스플레이 옵션, spectra 엑스트라를 문서화하지 않습니다. potato-skill을 설치하고 에이전트에게 연구를 설명한 뒤, 형식과 옵션은 이 페이지의 Markdown 사본을 가리켜 알려 주세요. Markdown 사본은 https://www.potatoannotator.com/docs/annotation-types/spectra.md에 있습니다.
더 읽을거리
- 화학 구조 주석과 OCSR 교정 - 분자의 구조 편집과 원자 선택
- 인스턴스 표시 - 디스플레이 필드를 설정하는 방법
- 내보내기 형식 - Potato의 내보내기 형식과 내보내기 명령
- 과학 모델 - 선택한 피크로
peak-cnn모델 학습시키기 - 애너테이터는 몇 명이 필요한가? - 항목당 주석자 수 정하기
- 생명과학 - 생명과학과 바이오큐레이션을 위한 Potato
구현 세부 사항은 소스 문서를 참고하세요.