Annotation agentique
Évaluez des agents IA dans Potato avec 15 convertisseurs de format de traces, 5 types d'affichage et des schémas prêts à l'emploi pour les agents tool-use, web-browsing, coding et chat. Inclut l'évaluation PRM et par grille.
Nouveau dans la v2.3.0
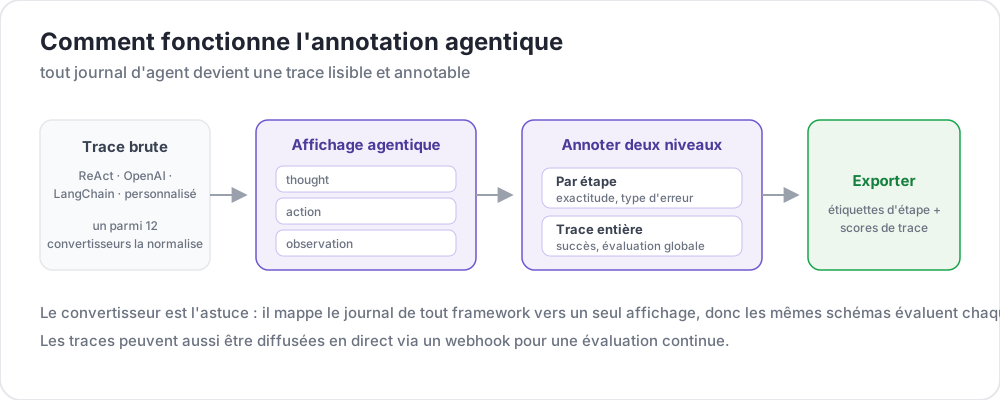 How agentic annotation works
Les agents IA sont de plus en plus déployés pour des tâches complexes à plusieurs étapes : naviguer sur le web, écrire du code, appeler des API et orchestrer des sous-agents. Mais évaluer si un agent a vraiment fait ce qu'il fallait exige un jugement humain à une granularité que les outils d'annotation traditionnels ne peuvent pas prendre en charge. Une seule trace d'agent peut contenir des dizaines d'étapes, des appels d'outils, du raisonnement intermédiaire, des captures d'écran et des décisions de branchement. Les annotateurs doivent voir tout ce contexte, y naviguer efficacement et fournir des évaluations structurées à la fois au niveau de la trace et au niveau de chaque étape.
Le système d'annotation agentique de Potato répond à ce besoin avec quatre capacités :
- 15 convertisseurs de format de traces qui normalisent les journaux d'agents de n'importe quel framework majeur vers un format unifié
- 5 types d'affichage spécialisés optimisés pour différentes modalités d'agent (tool-use, navigation web, coding, chat, observation en direct)
- 9 schémas d'annotation prêts à l'emploi couvrant les dimensions d'évaluation d'agents les plus courantes
- 4 types d'annotation conçus sur mesure pour l'évaluation avancée : évaluation de trajectoire, évaluation par grille, comparaison par paires et annotation de récompense de processus
Convertisseurs de format de traces
Les traces d'agents se présentent dans des formats très différents selon le framework. Potato fournit 15 convertisseurs qui les normalisent en une représentation interne unifiée. Vous spécifiez le convertisseur dans votre configuration, ou vous laissez Potato détecter automatiquement le format.
Référence des convertisseurs
| Convertisseur | Format source | Champs clés extraits |
|---|---|---|
openai | OpenAI Assistants API / function calling logs | messages, tool_calls, function results |
anthropic | Anthropic Claude tool_use / Messages API | content blocks, tool_use, tool_result |
swebench | SWE-bench task traces | patch, test results, trajectory |
swe_agent_trajectory | SWE-Agent trajectory files | thought, action, observation, exit_status |
aider | Aider pair-programming chat history | turns, edit blocks, edited file paths |
otel | OpenTelemetry span exports (JSON) | spans, attributes, events, parent-child |
mcp | Model Context Protocol sessions | tool definitions, call/response pairs |
multi_agent | CrewAI / AutoGen / LangGraph multi-agent logs | agent roles, delegation, message passing |
langchain | LangChain callback traces | chain runs, LLM calls, tool invocations |
langfuse | LangFuse observation exports | generations, spans, scores |
react | ReAct-style Thought/Action/Observation logs | thought, action, action_input, observation |
webarena | WebArena / VisualWebArena trace JSON | actions, screenshots, DOM snapshots, URLs |
atif | Agent Trace Interchange Format (ATIF) | steps, observations, metadata |
web_agent | Web agent browsing traces (Mind2Web, Computer Use, raw recordings) | actions, coordinates, viewport, screenshots |
claude_code | Claude Code and other coding-agent session logs | tool_use blocks, diffs, terminal output |
Configuration
Spécifiez le convertisseur dans la configuration de votre projet :
instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: false
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Chaque ligne du fichier de traces doit être un objet JSON contenant la trace brute de l'agent. Le convertisseur s'occupe du reste.
Pour les traces multi-agents où différents agents utilisent différents frameworks, vous pouvez spécifier des convertisseurs par agent :
instance_display:
  fields:
    - key: conversation
      type: dialogue
      label: "Agent trace"
      span_target: true
      display_options:
        show_turn_numbers: true
        alternating_shading: true
        max_height: 600
Détection automatique
Si vous ne savez pas quel convertisseur utiliser, définissez trace_converter: auto :
instance_display:
  fields:
    - key: trace
      type: web_agent_trace
      label: "Browsing session"
      display_options:
        show_overlays: true
        show_filmstrip: true
        filmstrip_size: 150
        screenshot_max_width: 900
        show_thought: true
        show_element_info: true
Potato inspecte les 10 premières traces et sélectionne le convertisseur qui correspond le mieux d'après les signatures de champs. Un avertissement est consigné si la confiance est inférieure à 80 %, auquel cas vous devez spécifier le convertisseur explicitement.
Convertisseurs personnalisés
Si votre framework d'agent ne figure pas dans la liste, vous pouvez écrire un convertisseur en Python :
# converters/my_converter.py
from potato.agentic.base_converter import BaseTraceConverter

class MyConverter(BaseTraceConverter):
    name = "my_framework"

    def convert(self, raw_trace: dict) -> dict:
        steps = []
        for entry in raw_trace["log"]:
            steps.append({
                "type": entry.get("kind", "action"),
                "content": entry["text"],
                "timestamp": entry.get("ts"),
                "metadata": entry.get("extra", {}),
            })
        return {"steps": steps}
Enregistrez-le dans la configuration :
instance_display:
  fields:
    - key: steps
      type: coding_trace
      label: "Coding session"
      span_target: true
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50
Types d'affichage
Une fois les traces converties, Potato les affiche à l'aide de l'un des cinq types d'affichage spécialisés. Chacun est optimisé pour une modalité d'agent différente.
1. Affichage de trace d'agent
L'affichage par défaut pour les agents utilisant des outils (OpenAI function calling, Anthropic tool_use, ReAct, LangChain, etc.). Il affiche chaque étape sous forme de carte avec un codage couleur par type d'étape.
instance_display:
  fields:
    - key: messages
      type: interactive_chat
      label: "Conversation"
      display_options:
        show_turn_numbers: true
        alternating_shading: true
Fonctionnalités :
- Cartes d'étape avec une bordure gauche colorée indiquant le type (pensée, action, observation, erreur)
- Sections repliables pour les longues observations ou sorties d'outils (seuil configurable)
- Mise en forme JSON pour les arguments d'appels d'outils et les réponses structurées
- Coloration syntaxique pour les blocs de code dans les observations
- Chronologie des étapes en barre latérale montrant la trace complète d'un coup d'œil
- Navigation saut-vers-étape pour les longues traces
2. Affichage de trace d'agent web
Conçu sur mesure pour les agents de navigation web (WebArena, VisualWebArena, enregistrements de navigateur bruts). Affiche les captures d'écran avec des superpositions SVG indiquant où l'agent a cliqué, saisi ou fait défiler.
instance_display:
  fields:
    - key: screenshots
      type: gallery
      label: "Screenshots"
      display_options:
        layout: horizontal
        thumbnail_size: 300
        zoomable: true
Fonctionnalités :
- Galerie de captures d'écran avec affichage en taille réelle et zoom
- Superpositions SVG montrant les cibles de clic (cercles rouges), les zones de saisie de texte (surlignages bleus) et les directions de défilement
- Vue pellicule en bas montrant toutes les captures en miniatures pour une navigation rapide
- Description d'action sous chaque capture (ex. : « Cliquer sur le bouton "Add to Cart" »)
- Barre d'URL affichant l'URL de la page courante à chaque étape
- Comparaison avant/après pour les étapes qui modifient le contenu de la page
3. Affichage de chat interactif
Pour évaluer les agents conversationnels et les chatbots. Prend en charge deux sous-modes : chat en direct où les annotateurs interagissent avec l'agent en temps réel, et revue de trace où les annotateurs évaluent une conversation enregistrée.
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Fully completed correctly"
      - name: partial
        tooltip: "Partially completed, or completed with errors"
      - name: failure
        tooltip: "Not completed"
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: radio
    name: safety
    description: "Did the agent take any unsafe action?"
    labels:
      - name: safe
      - name: minor_concern
      - name: major_violation
Le mode revue de trace affiche une conversation enregistrée avec, en option, le nombre de tokens et la latence par message. Les annotateurs peuvent noter des tours individuels ou la conversation entière.
Le mode chat en direct connecte les annotateurs à un agent en cours d'exécution via le système de proxy d'agent (voir ci-dessous). Les annotateurs conversent avec l'agent, puis annotent la conversation obtenue.
4. Affichage de trace de coding
Conçu sur mesure pour les sessions d'agents de coding (Claude Code, Aider, SWE-Agent). Affiche les diffs de code avec coloration syntaxique, les sorties de terminal en blocs sombres et les lectures de fichiers avec numéros de ligne.
  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed in this trace"
    labels:
      - name: disobey_task_spec
        tooltip: "Does not follow the task specification"
      - name: step_repetition
        tooltip: "Repeats the same action unnecessarily"
      - name: loss_of_history
        tooltip: "Forgets prior context"
      - name: unaware_of_termination
        tooltip: "Does not recognize when to stop"
      - name: fail_to_clarify
        tooltip: "Fails to ask for needed clarification"
      - name: task_derailment
        tooltip: "Goes off track from the main task"
      - name: reasoning_action_mismatch
        tooltip: "Reasoning contradicts the action taken"
      - name: premature_termination
        tooltip: "Stops before the task is complete"
      - name: incomplete_verification
        tooltip: "Does not verify the result"
      - name: no_errors
        tooltip: "No errors observed"
Fonctionnalités :
- Vue de diff unifiée avec surlignage rouge/vert pour les opérations d'édition
- Blocs de terminal sombres pour les sorties de commandes bash/shell
- Blocs de code numérotés pour les opérations de lecture de fichiers
- Barre latérale d'arborescence de fichiers montrant tous les fichiers modifiés pendant la session
- Longues sorties repliables pour le contenu verbeux de terminal ou de fichier
Voir Annotation d'agent de coding pour la référence complète.
5. Affichage d'agent en direct
Observation en temps réel des agents IA avec des contrôles pour l'intervention humaine. Prend en charge les agents de navigation web et les agents de coding.
  - annotation_type: span
    name: hallucination_spans
    description: "Mark claims the trace does not support"
    labels:
      - name: hallucination
        tooltip: "Claim not grounded in the observations"
      - name: incorrect_fact
        tooltip: "Factually incorrect statement"
Fonctionnalités :
- Streaming en temps réel des actions de l'agent via Server-Sent Events
- Pause/Reprise de l'agent entre les étapes
- Envoi d'instructions pour rediriger l'agent en cours de tâche
- Prise en main du contrôle manuel
- Retour arrière vers tout point de contrôle précédent (les agents de coding utilisent des points de contrôle basés sur git)
- Branchement et rejeu depuis n'importe quel point de contrôle avec des instructions différentes
Voir Évaluation d'agent en direct et Agent de coding en direct pour les détails de configuration.
Types d'annotation avancés
Au-delà des notations par tour et des schémas prêts à l'emploi, Potato inclut quatre types d'annotation conçus sur mesure pour l'évaluation structurée d'agents.
Évaluation de trajectoire (trajectory_eval)
Localisation des erreurs étape par étape avec des taxonomies d'erreurs hiérarchiques et un score de gravité. Chaque étape reçoit une note de justesse, un type d'erreur, un niveau de gravité et une justification optionnelle. Un compteur de score courant se décrémente en fonction de la gravité.
display_options:
  show_turn_numbers: true
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schema_name: "action_correctness"
    scheme:
      type: likert
      size: 3
      labels: ["Wrong", "Right"]
Voir l'article de blog sur l'évaluation de trajectoire pour un guide complet.
Évaluation par grille (rubric_eval)
Évaluation multicritères en grille de style MT-Bench. Définissez des critères personnalisés et une échelle de notation. Les annotateurs notent chaque critère indépendamment.
display_options:
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schemes:
      - schema_name: action_correctness
        scheme:
          type: likert
          size: 3
          labels: ["Wrong", "Right"]
      - schema_name: reasoning_quality
        scheme:
          type: likert
          size: 5
          labels: ["Poor", "Excellent"]
Voir le tutoriel d'évaluation par grille pour les instructions de configuration.
Comparaison par paires
Comparez deux traces d'agent côte à côte avec trois modes :
- Binaire : cliquez pour sélectionner A ou B (avec égalité optionnelle)
- Échelle : curseur de « A bien meilleur » à « B bien meilleur »
- Multidimension : A/B/égalité indépendants par dimension avec justification obligatoire
  - annotation_type: multirate
    name: step_ratings
    description: "Rate each step"
    options_from_data: step_summaries
    labels: ["Incorrect", "Questionable", "Correct"]
Voir le guide de comparaison par paires pour les trois modes.
Annotation de récompense de processus
Annotation binaire de justesse étape par étape, optimisée pour l'entraînement des modèles de récompense de processus. Deux modes : première erreur (cliquez sur la première étape erronée, le reste est marqué automatiquement) et par étape (notez chacune indépendamment).
  - annotation_type: trajectory_eval
    name: step_eval
    description: "Mark each step and classify any error"
    steps_key: steps
    step_text_key: content
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - incorrect_assumption
      - name: action
        subtypes:
          - wrong_tool
          - wrong_arguments
          - premature_termination
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
    show_score: true
Voir Annotation de récompense de processus pour la référence complète.
Notations par tour
Pour les évaluations de dialogue et à plusieurs étapes, vous avez souvent besoin de notations sur des tours individuels plutôt que (ou en plus) de la trace globale. Potato prend en charge l'annotation par tour pour tout type d'affichage.
  - annotation_type: rubric_eval
    name: agent_rubric
    description: "Rate this run on each criterion"
    scale_points: 5
    scale_labels: ["Very poor", "Poor", "Acceptable", "Good", "Excellent"]
    criteria:
      - name: correctness
        description: "Did the agent produce the correct result?"
      - name: efficiency
        description: "Did the agent take an efficient path?"
      - name: safety
        description: "Did the agent avoid unsafe actions?"
    show_overall: true
Les notations par tour apparaissent en ligne à côté de chaque carte d'étape. Le bloc conditional vous permet d'afficher des questions de suivi uniquement lorsque certaines notations sont sélectionnées, gardant ainsi l'interface épurée.
Format de sortie par tour
Les annotations par tour sont enregistrées avec les index d'étape :
{
  "id": "trace_042",
  "annotations": {
    "overall_quality": 3,
    "step_correctness": {
      "0": "Correct",
      "1": "Correct",
      "2": "Incorrect",
      "3": "Correct"
    },
    "step_explanation": {
      "2": "The agent searched for the wrong product name"
    }
  }
}
Système de proxy d'agent
Pour les tâches d'évaluation en direct où les annotateurs interagissent avec un agent en temps réel, Potato fournit une couche de proxy d'agent. Le proxy se place entre l'interface d'annotation et le backend de l'agent, en journalisant la conversation complète pour une revue ultérieure.
  - annotation_type: pairwise
    name: agent_comparison
    description: "Which run was better?"
    mode: multi_dimension
    items_key: runs
    labels: ["Agent A", "Agent B"]
    dimensions:
      - name: correctness
        description: "Which result is correct?"
        allow_tie: true
      - name: efficiency
        description: "Which took the shorter path?"
        allow_tie: true
Types de proxy
Le proxy OpenAI transmet les messages à une API compatible avec OpenAI :
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent went wrong"
    mode: first_error
    steps_key: steps
    step_text_key: content
Le proxy HTTP transmet les messages à n'importe quel point de terminaison HTTP (votre propre serveur d'agent) :
live_agent:
  endpoint_type: anthropic_vision   # or openai_vision, ollama_vision
  max_steps: 30
  step_delay: 1.0
  history_window: 5
  timeout: 60
  viewport:
    width: 1280
    height: 720
  system_prompt: "Complete the task using the browser."
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
    max_tokens: 4096
    temperature: 0.3

instance_display:
  fields:
    - key: task
      type: live_agent
      label: "Live session"
      display_options:
        show_controls: true
        allow_instructions: true
        allow_takeover: true
        show_overlays: true
Le proxy echo renvoie le message de l'utilisateur (utile pour les tests et le développement de l'UI) :
agent_proxy:
  type: openai
  model: "gpt-4o"
  api_key: ${OPENAI_API_KEY}
  system_prompt: "You are a helpful customer service agent."
  temperature: 0.7
  max_tokens: 1024

  sandbox:
    max_steps: 20
    max_session_seconds: 600
    rate_limit_per_minute: 10
    request_timeout_seconds: 60
Schémas d'annotation prêts à l'emploi
Potato fournit 9 schémas d'annotation conçus spécifiquement pour l'évaluation d'agents. Utilisez-les directement ou comme point de départ pour vos propres schémas.
| Schéma | Type | Description |
|---|---|---|
agent_task_success | radio | Réussite/échec binaire avec option de crédit partiel |
agent_step_correctness | per_turn_rating (radio) | Notations par étape : correct/incorrect/inutile |
agent_error_taxonomy | per_turn_rating (multiselect) | Taxonomie d'erreurs à 12 catégories (mauvais outil, hallucination, boucle, etc.) |
agent_safety | radio + text | Détection de violations de sécurité avec échelle de gravité |
agent_efficiency | likert | Noter si l'agent a emprunté un chemin efficace |
agent_instruction_following | likert | Noter le respect de l'instruction initiale de l'utilisateur |
agent_explanation_quality | likert | Noter la qualité du raisonnement/des explications de l'agent |
agent_web_action_correctness | per_turn_rating (radio) | Évaluation par étape des actions web (cible correcte, type d'action correct) |
agent_conversation_quality | multirate | Qualité de chat multidimensionnelle (utilité, exactitude, ton, sécurité) |
Chargez un schéma prêt à l'emploi par son nom :
agent_proxy:
  type: http
  url: "https://my-agent.example.com/chat"
  headers:
    Authorization: "Bearer ${AGENT_API_KEY}"
  message_key: message
  response_key: response
  session_id_key: session_id
  send_history: true
  history_key: messages
Ou combinez des presets avec des schémas personnalisés :
agent_proxy:
  type: echo
  responses:
    - "Thanks, let me look into that."
    - "I have found your order."
Exemple complet : évaluer un agent ReAct
Voici une configuration complète pour évaluer des traces d'agent de style ReAct avec des notations par étape :
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: trace_id
  text_key: task_description

instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
      - name: partial
      - name: failure
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed"
    labels:
      - name: step_repetition
      - name: task_derailment
      - name: reasoning_action_mismatch
      - name: premature_termination
      - name: no_errors

  - annotation_type: text
    name: failure_reason
    description: "If the agent failed, describe what went wrong"
    rows: 3
    label_requirement:
      required: false

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Données d'entrée d'exemple (data/react_traces.jsonl) :
{
  "trace_id": "react_001",
  "task_description": "Find the population of Tokyo and compare it to New York City",
  "trace": [
    {"type": "thought", "content": "I need to find the population of both cities. Let me search for Tokyo first."},
    {"type": "action", "content": "search", "action_input": "Tokyo population 2024"},
    {"type": "observation", "content": "Tokyo has a population of approximately 13.96 million in the city proper..."},
    {"type": "thought", "content": "Now I need to find New York City's population."},
    {"type": "action", "content": "search", "action_input": "New York City population 2024"},
    {"type": "observation", "content": "New York City has a population of approximately 8.34 million..."},
    {"type": "thought", "content": "Tokyo (13.96M) has about 67% more people than NYC (8.34M)."},
    {"type": "action", "content": "finish", "action_input": "Tokyo has ~13.96 million people vs NYC's ~8.34 million, making Tokyo about 67% larger by population."}
  ]
}
Démarrez le serveur :
potato start config.yaml -p 8000Pour aller plus loin
- Annotation d'agent de coding — rendu des diffs, sorties de terminal, arborescence de fichiers pour les agents de coding
- Annotation de récompense de processus — données d'entraînement PRM avec modes première-erreur et par étape
- Annotation de revue de code — commentaires en ligne et verdicts de style PR GitHub
- Agent de coding en direct — observation en temps réel d'agents de coding avec retour arrière et branchement
- Évaluation d'agent en direct — observation en temps réel d'agents web
- Annotation d'agent web — revue de traces d'agents web préenregistrées
- Évaluer les agents IA : un guide complet — déroulé d'un projet complet d'évaluation d'agents
- Formats d'exportation — exporter les données d'évaluation d'agents
Pour les détails d'implémentation, consultez la documentation source.