Localisation des erreurs étape par étape : trouver où les agents échouent avec l'évaluation de trajectoire
Utilisez le schéma trajectory_eval de Potato pour localiser les erreurs étape par étape, avec des taxonomies d'erreurs hiérarchiques, un score de gravité et un score courant suivi sur toute la trace d'un agent.
Le problème : savoir qu'un agent a échoué ne suffit pas
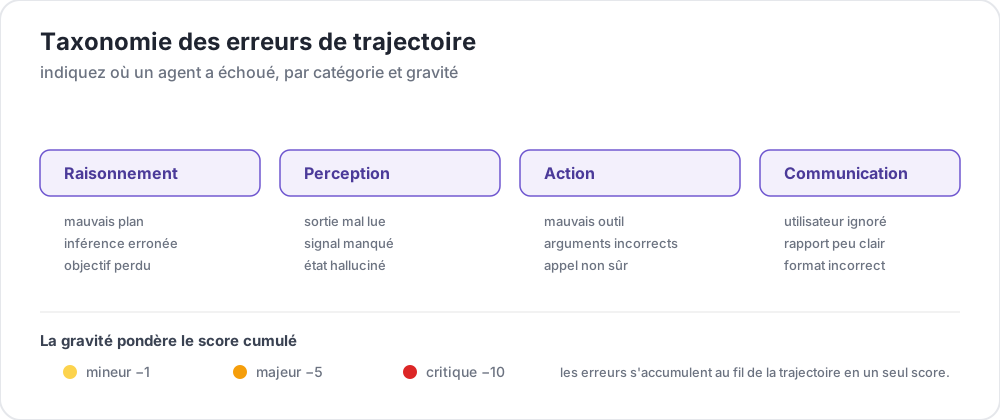 Une taxonomie des erreurs de trajectoire
Vous lancez votre agent sur un banc d'essai. Il obtient 63 % de tâches accomplies. Et maintenant ?
Un score réussite/échec vous apprend que l'agent a échoué sur 37 % des tâches, et rien d'autre. Il ne dit pas où les choses ont dérapé dans la trace, quel type d'erreur l'agent a commis, ni à quel point elle était grave. Était-ce une seule bévue catastrophique à l'étape 2, ou quinze étapes de petites erreurs de raisonnement qui se sont accumulées ? L'agent a-t-il mal utilisé un outil, ou raisonné à partir d'une prémisse fausse ?
Sans localisation des erreurs étape par étape, vous ne pouvez ni diagnostiquer les modes d'échec, ni décider quoi corriger en premier, ni constituer des données d'entraînement pour des modèles de récompense de processus. Vous réglez des hyperparamètres à l'aveugle.
Le schéma d'annotation trajectory_eval de Potato répond à cela. Les annotateurs parcourent chaque étape d'une trace et consignent :
- Justesse : cette étape est-elle correcte ou erronée ?
- Type d'erreur : choisi dans une taxonomie hiérarchique que vous définissez
- Niveau de gravité : mineur, majeur ou critique, avec des poids de score configurables
- Justification : explication en texte libre de l'erreur (optionnel)
- Score courant : un score cumulé qui se décrémente selon la gravité, et vous donne une courbe de qualité par trace
Ce guide couvre l'installation complète : définir votre taxonomie d'erreurs, mener l'annotation et analyser les données recueillies. Pour la référence de configuration du schéma, voir la documentation source.
Vue d'ensemble du schéma trajectory_eval
Le schéma trajectory_eval est conçu pour évaluer les traces d'agents à plusieurs étapes, dans l'ordre. Au lieu d'une seule note de qualité globale, il produit une annotation d'erreur structurée pour chaque étape, si bien que vous obtenez une carte détaillée de l'endroit et de la raison de l'échec de l'agent.
Voici ce que fait l'interface d'annotation à chaque étape :
- L'annotateur voit le contenu de l'étape courante (raisonnement, action, observation, code, etc.)
- Il marque l'étape comme correcte ou erronée
- Si elle est erronée, il choisit un type d'erreur dans la taxonomie hiérarchique
- Il attribue un niveau de gravité (mineur, majeur ou critique)
- Il peut écrire une justification qui explique l'erreur
- Le score courant en haut de l'interface se met à jour tout seul
L'annotateur avance dans la trace une étape à la fois, et construit ainsi un profil d'erreurs complet.
L'interface d'évaluation de trajectoire montre chaque étape avec son score :
 Chaque étape reçoit une note de justesse, un type d'erreur et un niveau de gravité, avec un score courant qui se décrémente selon la gravité
Concevoir une taxonomie d'erreurs hiérarchique
C'est la taxonomie qui rend l'évaluation de trajectoire utile. Bien conçue, elle vous permet d'agréger les erreurs sur l'ensemble des traces et de repérer les motifs d'échec systématiques ; mal conçue, vos étiquettes ne mèneront à rien. Voici la taxonomie dont je partirais, avec quatre catégories de premier niveau.
Erreurs de raisonnement
Elles surviennent quand le raisonnement de l'agent est vicié, même si ce qu'il voit et ce qu'il fait sont par ailleurs corrects.
| Type d'erreur | Description | Exemple |
|---|---|---|
logical_error | Inférence logique invalide | « Puisque A implique B et que B est vrai, A doit être vrai » (affirmation du conséquent) |
incorrect_assumption | Suppose quelque chose que les indices n'étayent pas | Suppose qu'un fichier existe sans vérifier |
over_generalization | Tire une conclusion trop large d'indices limités | « Cette fonction a échoué une fois, donc toute l'API est cassée » |
circular_reasoning | La conclusion sert de prémisse | « La réponse est X parce que X est correct » |
incorrect_calculation | Erreur de calcul mathématique ou logique | Erreur d'indice sur la borne d'une boucle |
Erreurs de perception
Elles surviennent quand l'agent lit mal, interprète mal ou manque une information dans ses observations.
| Type d'erreur | Description | Exemple |
|---|---|---|
missed_element | Ne remarque pas une information pertinente | Passe à côté d'un message d'erreur dans la sortie du terminal |
misidentified_element | Interprète mal ce qu'il voit | Prend une erreur 404 pour une réponse réussie |
hallucinated_element | Fait référence à quelque chose d'absent | Mentionne un paramètre de fonction qui n'existe pas |
outdated_reference | Utilise une information périmée d'une étape précédente | Utilise la valeur d'une variable qui a été écrasée |
Erreurs d'action
Elles surviennent quand l'agent fait la mauvaise action, ou la bonne action de la mauvaise manière.
| Type d'erreur | Description | Exemple |
|---|---|---|
wrong_tool | Choisit un outil inadapté à la tâche | Utilise grep alors qu'il faut find |
wrong_arguments | Bon outil, mais mauvais paramètres | Passe un mauvais chemin de fichier à une commande d'édition |
premature_termination | S'arrête avant que la tâche soit terminée | Rend une réponse après n'avoir trouvé qu'une information partielle |
unnecessary_action | Effectue une action sans valeur ajoutée | Relit un fichier qui vient d'être lu |
destructive_action | Effectue une action qui cause des dégâts | Supprime un fichier sans sauvegarde |
Erreurs de communication
Elles apparaissent dans les réponses de l'agent aux utilisateurs, ou dans la façon dont il raconte son propre travail.
| Type d'erreur | Description | Exemple |
|---|---|---|
unclear_explanation | L'explication est confuse ou ambiguë | Décrit un correctif sans dire ce qui était cassé |
missing_context | Omet un contexte essentiel dans la réponse | Annonce un succès sans mentionner les réserves |
incorrect_summary | Le résumé ne correspond pas aux actions réelles | Affirme avoir modifié 3 fichiers alors que 2 seulement ont changé |
overconfident_claim | Présente l'incertain comme certain | « Cela va régler le problème, c'est sûr » à propos d'un changement non testé |
Niveaux de gravité et poids de score
Chaque erreur reçoit un niveau de gravité. Les poids par défaut sont les suivants :
| Gravité | Poids | Description |
|---|---|---|
minor | -1 | Petits problèmes qui ne font pas dérailler la trace (par ex. action inutile, explication peu claire) |
major | -5 | Erreurs importantes qui gaspillent des efforts ou produisent des résultats partiellement faux (par ex. mauvais outil, supposition erronée) |
critical | -10 | Erreurs qui cassent fondamentalement la trace (par ex. action destructrice, arrêt prématuré avec une mauvaise réponse) |
Le score courant part de 100 et baisse du poids de gravité à chaque erreur. Une trace qui finit à 85 a connu quelques petits problèmes ; une trace qui finit à 40 a connu plusieurs échecs majeurs.
Vous pouvez modifier ces poids dans la configuration :
severities:
  - name: minor
    weight: -1
  - name: major
    weight: -5
  - name: critical
    weight: -10
Configuration YAML complète
Voici un config.yaml complet pour l'évaluation de trajectoire, avec la taxonomie entière :
annotation_task_name: "Agent Trajectory Error Localization"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: "trace_id"
  text_key: "task"

instance_display:
  fields:
    - key: "task"
      type: text
      label: "Task"
    - key: "trace"
      type: agent_trace
      label: "Agent trace"
      display_options:
        show_step_numbers: true
        show_timestamps: false
        step_type_colors:
          thought: "#E8F0FE"
          action: "#FFF3E0"
          observation: "#F1F8E9"
          code: "#F3E5F5"

annotation_instructions: |
  Walk the trace one step at a time. Mark a step incorrect only when it is
  wrong on the information available at that step, not with hindsight. When
  several categories apply, choose the most specific one.

annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_errors
    description: "Mark each step and classify any error"
    steps_key: trace
    step_text_key: content
    correctness_options:
      - correct
      - incorrect
      - partially_correct
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - incorrect_assumption
          - over_generalization
          - circular_reasoning
          - incorrect_calculation
      - name: perception
        subtypes:
          - missed_element
          - misidentified_element
          - hallucinated_element
          - outdated_reference
      - name: action
        subtypes:
          - wrong_tool
          - wrong_arguments
          - premature_termination
          - unnecessary_action
          - destructive_action
      - name: communication
        subtypes:
          - unclear_explanation
          - missing_context
          - incorrect_summary
          - overconfident_claim
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

  - annotation_type: radio
    name: overall_success
    description: "Did the run succeed overall?"
    labels:
      - success
      - partial
      - failure
    sequential_key_binding: true

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Mise en place, étape par étape
1. Préparez vos traces d'agents
Les données de trace se présentent au format JSONL, une trace par ligne. Chaque trace a besoin d'un identifiant, d'une description de tâche et d'une liste d'étapes :
{
  "trace_id": "trace_042",
  "task": "Find the bug in the calculate_discount function and fix it",
  "trace": [
    {
      "type": "thought",
      "content": "I need to look at the calculate_discount function to find the bug. Let me search for it."
    },
    {
      "type": "action",
      "content": "search",
      "action_input": "def calculate_discount"
    },
    {
      "type": "observation",
      "content": "Found in pricing.py line 45:\ndef calculate_discount(price, discount_pct):\n    return price * discount_pct / 100"
    },
    {
      "type": "thought",
      "content": "The function calculates the discount amount but doesn't subtract it from the price. It should return price - (price * discount_pct / 100)."
    },
    {
      "type": "action",
      "content": "edit_file",
      "action_input": "pricing.py:45: return price - (price * discount_pct / 100)"
    },
    {
      "type": "observation",
      "content": "File edited successfully."
    },
    {
      "type": "action",
      "content": "finish",
      "action_input": "Fixed the calculate_discount function. It was returning the discount amount instead of the discounted price."
    }
  ]
}
Si vos traces sont dans un autre format (messages OpenAI, exécutions LangChain, journaux de conversation Claude), utilisez le convertisseur de traces de Potato :
python -m potato.trace_converter \
  --input raw_traces/ \
  --output data/traces.jsonl \
  --input-format react
2. Configurez votre taxonomie
Partez de la taxonomie complète ci-dessus, puis élaguez-la ou étendez-la pour votre agent. Pour un agent de coding, par exemple, vous pourriez ajouter une catégorie code_quality :
error_types:
  - name: code_quality
    subtypes:
      - syntax_error
      - runtime_error
      - logic_bug
      - style_violation
Pour les traces d'agents de coding, l'évaluation affiche les diffs et la sortie du terminal à côté des contrôles de notation :
 CodingTraceDisplay affiche les diffs, les blocs de terminal et les lectures de fichiers à côté des contrôles d'évaluation de trajectoire
3. Lancez le serveur d'annotation
potato start config.yaml -p 8000Ouvrez http://localhost:8000 dans votre navigateur. Vous verrez la première trace avec l'affichage étape par étape.
4. Rédigez des consignes d'annotation
Donnez aux annotateurs des instructions claires. Documentez au minimum :
- Quand marquer une étape comme erronée plutôt que correcte-mais-perfectible
- Comment choisir entre plusieurs catégories d'erreur quand plusieurs s'appliquent (prenez la plus spécifique)
- Quand attribuer chaque niveau de gravité, avec des exemples concrets
- S'il faut évaluer les étapes à partir de l'information disponible à ce moment-là, ou avec le recul
Le déroulé de l'annotation
Quand un annotateur ouvre une trace, la description de la tâche se trouve en haut et la première étape juste en dessous. Le score courant affiche 100 dans le coin supérieur droit.
Pour chaque étape, l'annotateur :
- Lit le contenu de l'étape dans le contexte des étapes précédentes
- Marque la justesse en cliquant sur « Correct » ou « Erroné »
- Si l'étape est erronée, choisit la catégorie d'erreur (par ex. « Erreur de raisonnement »), puis le type précis (par ex. « Supposition erronée »)
- Attribue une gravité : mineure, majeure ou critique
- Écrit une justification (si le champ est activé) : « L'agent suppose que le fichier est dans le répertoire courant sans vérifier, alors que les résultats de recherche montraient qu'il est dans src/utils/ »
- Passe à l'étape suivante en cliquant sur « Étape suivante » ou en appuyant sur la flèche droite
Le score courant se met à jour après chaque erreur. Marquez l'étape 3 comme erreur majeure (-5) et le score passe de 100 à 95. Marquez l'étape 7 comme critique (-10) et il tombe à 85.
À la fin de la trace, l'annotateur donne la note globale succès / partiel / échec, puis soumet.
Analyser les résultats
Charger les données d'annotation
import json
import pandas as pd
from collections import Counter
from pathlib import Path

# Load all annotation files
annotations = []
output_dir = Path("output/")
for f in output_dir.glob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            annotations.append(json.loads(line))

print(f"Loaded {len(annotations)} annotated traces")
Analyse de la distribution des erreurs
# Extract all errors across all traces
errors = []
for ann in annotations:
    for step_ann in ann.get("error_localization", []):
        if step_ann["correctness"] == "incorrect":
            errors.append({
                "trace_id": ann["trace_id"],
                "step_index": step_ann["step_index"],
                "category": step_ann["error_category"],
                "error_type": step_ann["error_type"],
                "severity": step_ann["severity"],
                "rationale": step_ann.get("rationale", ""),
            })

error_df = pd.DataFrame(errors)
print(f"Total errors found: {len(error_df)}")
print()

# Error distribution by category
print("Errors by category:")
print(error_df["category"].value_counts())
print()

# Most common specific error types
print("Top 10 error types:")
print(error_df["error_type"].value_counts().head(10))
print()

# Severity distribution
print("Severity distribution:")
print(error_df["severity"].value_counts())
Analyse de la position des erreurs
Voir où les erreurs tombent dans une trace révèle souvent des motifs systématiques :
import matplotlib.pyplot as plt
import numpy as np

# Normalize step positions to [0, 1] range
for ann in annotations:
    trace_length = len(ann.get("error_localization", []))
    for step_ann in ann["error_localization"]:
        if step_ann["correctness"] == "incorrect":
            step_ann["normalized_position"] = step_ann["step_index"] / max(trace_length - 1, 1)

# Collect normalized positions
positions = [
    step_ann["normalized_position"]
    for ann in annotations
    for step_ann in ann.get("error_localization", [])
    if step_ann["correctness"] == "incorrect"
    and "normalized_position" in step_ann
]

plt.figure(figsize=(10, 4))
plt.hist(positions, bins=20, edgecolor="black", alpha=0.7)
plt.xlabel("Normalized Position in Trace (0 = start, 1 = end)")
plt.ylabel("Error Count")
plt.title("Where Do Agent Errors Occur?")
plt.tight_layout()
plt.savefig("error_position_distribution.png", dpi=150)
print("Saved error_position_distribution.png")
Distribution des scores courants
# Extract final running scores
final_scores = []
for ann in annotations:
    score = 100
    severity_weights = {"minor": -1, "major": -5, "critical": -10}
    for step_ann in ann.get("error_localization", []):
        if step_ann["correctness"] == "incorrect":
            score += severity_weights.get(step_ann["severity"], 0)
    score = max(score, 0)
    final_scores.append({
        "trace_id": ann["trace_id"],
        "final_score": score,
        "overall_success": ann.get("overall_success", "unknown"),
    })

score_df = pd.DataFrame(final_scores)

print("Score statistics:")
print(score_df["final_score"].describe())
print()

# Score distribution by overall success
for label in ["success", "partial", "failure"]:
    subset = score_df[score_df["overall_success"] == label]
    if len(subset) > 0:
        print(f"{label}: mean={subset['final_score'].mean():.1f}, "
              f"median={subset['final_score'].median():.1f}, "
              f"n={len(subset)}")
Les modes d'échec les plus fréquents
# Group errors by category + type for a failure mode analysis
failure_modes = (
    error_df.groupby(["category", "error_type"])
    .agg(
        count=("severity", "size"),
        avg_severity_weight=("severity", lambda x: x.map(
            {"minor": 1, "major": 5, "critical": 10}
        ).mean()),
    )
    .sort_values("count", ascending=False)
)

print("Top failure modes (by frequency):")
print(failure_modes.head(15).to_string())
print()

# Impact-weighted failure modes (frequency x average severity)
failure_modes["impact"] = failure_modes["count"] * failure_modes["avg_severity_weight"]
print("Top failure modes (by impact):")
print(failure_modes.sort_values("impact", ascending=False).head(10).to_string())
Contexte de recherche
La localisation des erreurs étape par étape rejoint plusieurs travaux récents en évaluation d'agents :
TRAIL (Patronus AI, 2025) a annoté 148 traces d'agents issues de GAIA et de SWE-bench Lite selon une taxonomie de plus de 20 types d'erreurs, pour 841 erreurs au total. Ce qu'il faut en retenir, c'est la difficulté de la localisation : le meilleur modèle de raisonnement à long contexte testé atteint 11 % de justesse conjointe sur la catégorie d'erreur et sa position. C'est exactement la tâche que trajectory_eval confie à des annotateurs humains, et c'est pourquoi ces annotations valent leur coût.
AgentRewardBench (McGill NLP, 2025) s'est attaqué aux juges. Le travail rassemble 1 302 trajectoires d'agents web sur cinq benchmarks, fait relire chacune par une personne experte sur le succès, les effets de bord et les répétitions, puis évalue douze juges LLM à l'aune de ces relectures. Aucun juge ne domine sur tous les benchmarks, et les évaluations à base de règles fournies avec les benchmarks sous-estiment la fréquence des réussites. Si vous comptez automatiser une partie de cette taxonomie avec un modèle, c'est ce type de vérification qu'il vous faut.
Les étiquettes de justesse et de gravité par étape produites par trajectory_eval alimentent aussi directement l'entraînement des modèles de récompense de processus : chaque étape annotée est un exemple d'entraînement assorti d'un signal de qualité de référence.
L'article d'Anthropic Demystifying evals for AI agents propose la version opérationnelle du même argument. Notez la transcription et pas seulement le résultat, et employez des correcteurs à base de modèles avec des grilles explicites sur la façon dont l'agent a appelé les outils et parlé à l'utilisateur. Il met aussi en garde contre la notation par rapport à une séquence d'étapes imposée, car les agents trouvent sans cesse des chemins valides que le concepteur de l'évaluation n'avait pas prévus. Gardez-le en tête en appliquant cette taxonomie : une étape est une erreur parce qu'elle était fausse, pas parce qu'elle était inattendue.
Le score courant pondéré par la gravité correspond lui aussi aux signaux de récompense employés en RLHF. Une courbe de score qui chute brutalement à l'étape 5 d'une trace de 20 étapes vous dit exactement où l'agent a besoin de travail, ce qui est bien plus exploitable qu'une unique récompense de fin de trace.
En résumé
Le schéma trajectory_eval fait passer l'évaluation d'agents du contrôle réussite/échec au diagnostic. Avec une taxonomie hiérarchique, un score de gravité et un score courant, vous voyez quelle étape a dérapé, de quel type d'erreur il s'agissait, à quel point elle était grave, et où les erreurs ont tendance à se concentrer d'une trace à l'autre. Les étiquettes au niveau de l'étape servent aussi telles quelles de données d'entraînement pour un modèle de récompense de processus.
Partez de la taxonomie complète de ce guide, puis affinez-la pour votre agent et les motifs d'erreur que vous observez réellement. La meilleure taxonomie est celle qui désigne des corrections que vous pouvez faire.