Comparer des agents IA côte à côte : modes binaire, échelle et multidimension
Mettez en place la comparaison d'agents par paires dans Potato avec trois modes : préférence binaire, échelle continue et jugement multicritère par dimension avec justification obligatoire.
Pourquoi la comparaison par paires pour évaluer des agents
Demander à quelqu'un de noter la trace d'un agent de coding sur une échelle de 1 à 10 produit des données bruitées, parce que chacun calibre cette échelle à sa façon. Le 7 d'un annotateur est le 5 d'un autre. La comparaison par paires contourne le problème. Au lieu de noter les traces isolément, les annotateurs en regardent deux côte à côte et disent laquelle est la meilleure. Ce jugement en tête-à-tête est plus facile à rendre, plus stable d'une personne à l'autre, et c'est exactement ce dont vous avez besoin pour le Direct Preference Optimization (DPO) et le Reinforcement Learning from Human Feedback (RLHF).
C'est l'approche employée pour entraîner les modèles de récompense servant à l'alignement des modèles de langage, et elle se transpose sans peine aux agents de coding : recueillir des préférences humaines entre paires de trajectoires d'agents, entraîner un modèle de récompense dessus, puis se servir de ce modèle pour guider l'entraînement de l'agent ou choisir le meilleur de N candidats au moment de l'inférence.
Potato propose trois modes de comparaison par paires, chacun adapté à un besoin d'évaluation et à un budget de données différents.
L'interface place deux traces côte à côte :
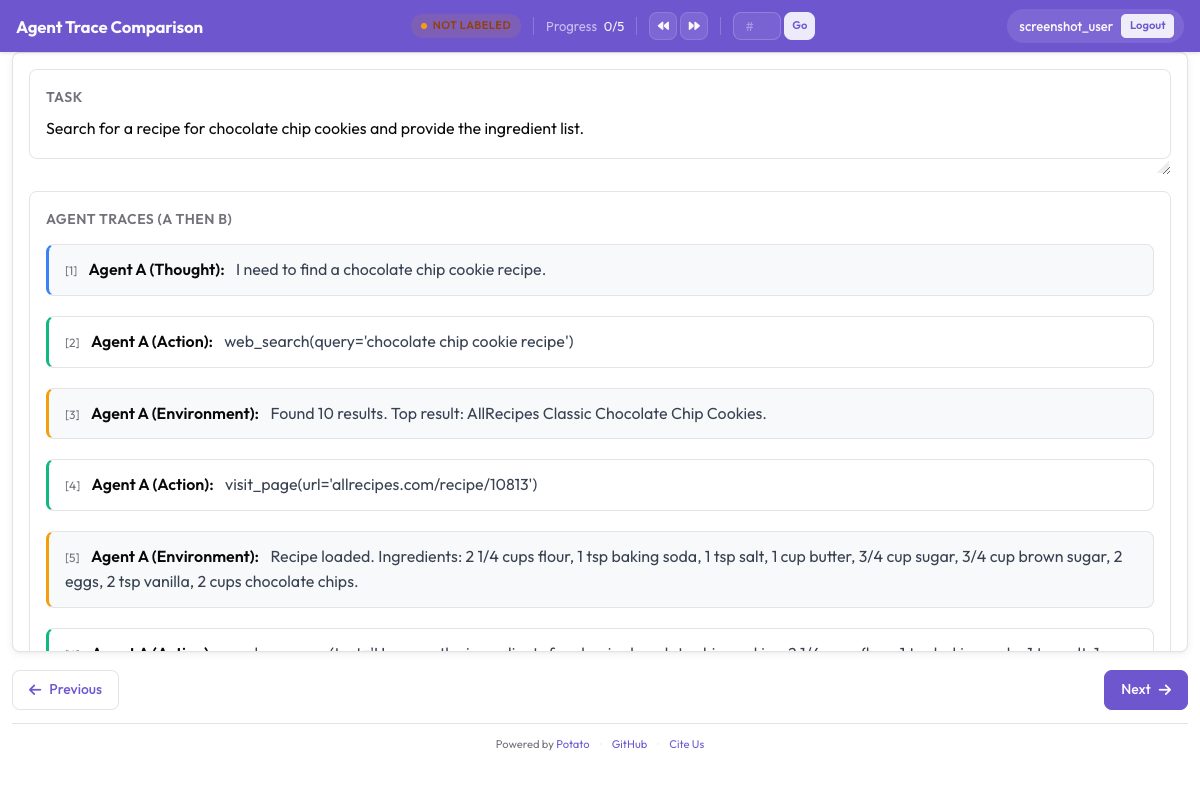 Les annotateurs comparent deux traces d'agent et choisissent la meilleure démarche
Mode 1 : préférence binaire
C'est le mode le plus simple et le plus rapide. L'annotateur voit deux traces côte à côte et clique sur la meilleure. Un bouton d'égalité optionnel couvre les cas où les deux se valent, en bien comme en mal.
Quand utiliser le mode binaire
Choisissez le mode binaire quand il vous faut beaucoup de données de préférence rapidement. Il convient pour entraîner des modèles de récompense simples, calculer des taux de victoire entre agents et construire des classements Elo. En contrepartie, vous perdez la nuance : vous savez quelle trace l'a emporté, mais pas de combien ni sur quels aspects.
Configuration
annotation_task_name: "Agent Comparison - Binary"
task_dir: "."
port: 8000

data_files:
  - "data/paired_traces.jsonl"

item_properties:
  id_key: "id"
  text_key: "task"

instance_display:
  fields:
    - key: "task"
      type: text
      label: "Task"

annotation_schemes:
  - annotation_type: pairwise
    name: preference
    description: "Which agent produced a better solution?"
    mode: binary
    items_key: "responses"
    show_labels: true
    labels:
      - "Agent A"
      - "Agent B"
    allow_tie: true
    tie_label: "Tie (equally good or equally bad)"
    randomize_order: true
    sequential_key_binding: true
    label_requirement:
      required: true

  - annotation_type: radio
    name: confidence
    description: "How confident are you in this judgment?"
    labels:
      - "Very confident"
      - "Somewhat confident"
      - "Not confident"

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Le déroulé de l'annotation
L'annotateur obtient un écran scindé en deux. À gauche, la trace A s'affiche avec le CodingTraceDisplay complet : diffs, blocs de terminal, lectures de fichiers, raisonnement. À droite, la trace B pour la même tâche. Chaque côté défile indépendamment.
La description de la tâche figure au-dessus des deux traces, pour que l'annotateur sache ce que les deux agents cherchaient à faire.
En dessous, trois boutons : « Agent A is better », « Agent B is better » et « Tie ». Avec randomize_order activé, l'attribution des rôles A et B est tirée au sort à chaque élément, ce qui empêche les annotateurs de prendre l'habitude de cliquer toujours à gauche ou toujours à droite.
Pour une évaluation plus fine, l'interface gère aussi plusieurs dimensions :
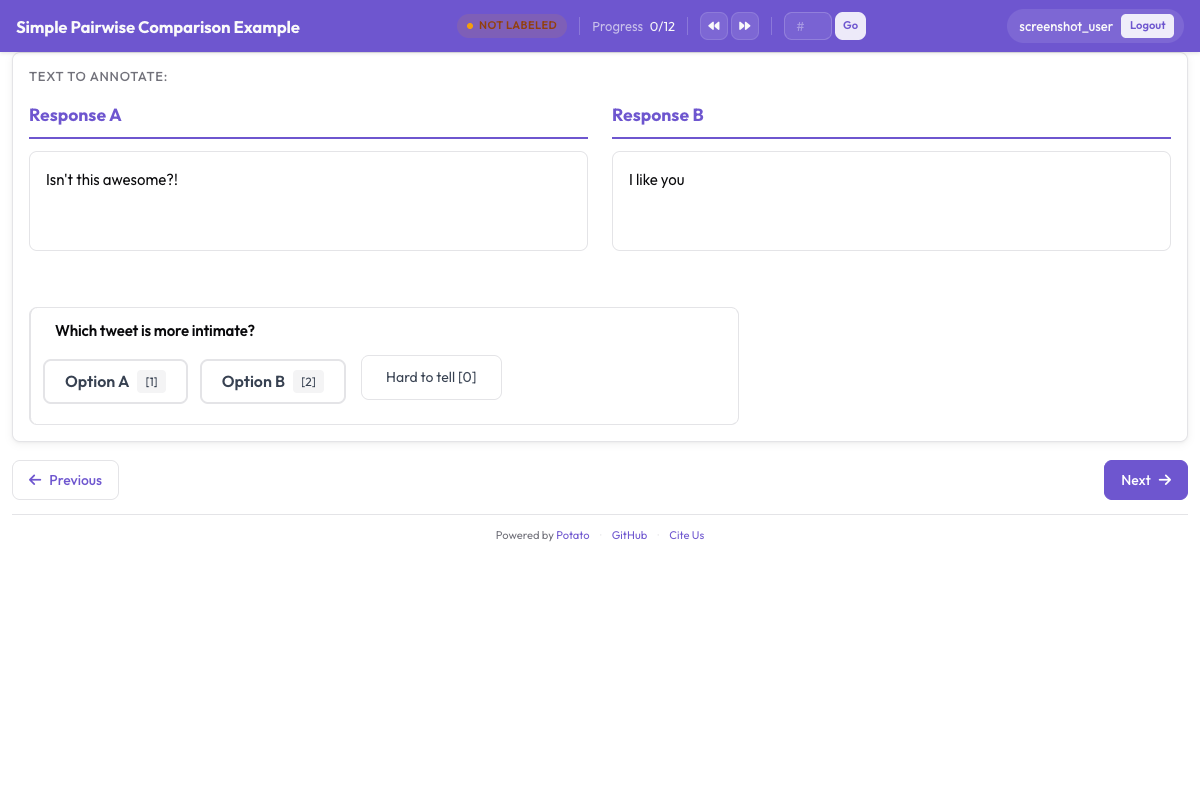 Les modes préférence binaire, échelle continue et multidimension sont disponibles
Mode 2 : échelle continue
Le mode échelle permet à l'annotateur d'indiquer de combien une trace est meilleure, et pas seulement laquelle l'emporte. Au lieu d'un simple clic, il déplace un curseur qui va de « A much better » à gauche à « B much better » à droite, avec « Equal » au centre.
Quand utiliser le mode échelle
Utilisez le mode échelle quand l'intensité de la préférence compte, pas seulement son sens. Un curseur proche d'une extrémité signale un écart de qualité net ; proche du centre, les deux traces se valaient presque. Le DPO et les chaînes de traitement voisines savent pondérer les exemples par cette intensité, en s'appuyant davantage sur les cas tranchés.
Configuration
annotation_schemes:
  - annotation_type: pairwise
    name: preference_scale
    description: "Which agent produced a better solution, and by how much?"
    mode: scale
    items_key: "responses"
    labels:
      - "Agent A"
      - "Agent B"
    scale:
      min: -3
      max: 3
      step: 1
      default: 0
      labels:
        min: "A is much better"
        max: "B is much better"
        center: "Equal"
    label_requirement:
      required: true
Utiliser une échelle à 5 points
Pour annoter plus vite, au prix d'un peu de granularité, descendez à une échelle à 5 points :
annotation_schemes:
  - annotation_type: pairwise
    name: multi_dim_comparison
    description: "Compare the two solutions along each dimension"
    mode: multi_dimension
    items_key: "responses"
    labels:
      - "Agent A"
      - "Agent B"
    dimensions:
      - name: correctness
        description: "Which solution actually fixes the stated problem?"
        allow_tie: true
      - name: efficiency
        description: "Which takes fewer unnecessary steps, file reads, or redundant edits?"
        allow_tie: true
      - name: code_quality
        description: "Which is more readable, better named, and closer to existing patterns?"
        allow_tie: true
      - name: communication
        description: "Which explains its reasoning more clearly and identifies the root cause?"
        allow_tie: true
      - name: robustness
        description: "Which handles edge cases and verifies its changes?"
        allow_tie: true
    justification:
      required: true
      reason_categories:
        - "More correct"
        - "More efficient"
        - "Better written"
        - "Better explained"
      min_rationale_chars: 20
      rationale_placeholder: "Which agent was better here, and why?"
Mode 3 : comparaison multidimension
C'est le mode le plus détaillé. Plutôt qu'une préférence globale, l'annotateur juge les traces sur plusieurs dimensions indépendantes. Chaque dimension reçoit son propre verdict A/B/égalité, et chaque verdict doit être justifié par écrit.
Quand utiliser le mode multidimension
Utilisez-le quand vous voulez savoir non seulement quel agent l'a emporté, mais pourquoi. Une trace peut avoir du code correct et une efficacité déplorable ; une autre être efficace mais passer à côté d'un cas limite. Les données par dimension qui en sortent servent à entraîner des modèles de récompense spécialisés par dimension, ou à remonter un compte rendu détaillé aux personnes qui développent l'agent.
Configuration
attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 10.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5
Préparer les données de traces appariées
Les trois modes prennent des traces appariées en entrée. Chaque ligne du fichier JSONL contient deux traces qui ont tenté la même tâche.
Format des données
{
  "id": "pair_001",
  "task_description": "Fix the IndexError in process_batch() when the input list is empty",
  "repo": "myorg/myproject",
  "trace_a": {
    "agent": "claude_code",
    "model": "claude-sonnet-4-20250514",
    "structured_turns": [
      {
        "step_idx": 0,
        "type": "file_read",
        "path": "src/batch.py",
        "content": "def process_batch(items):\n    result = items[0]\n    ...",
        "start_line": 10,
        "end_line": 25
      },
      {
        "step_idx": 1,
        "type": "file_edit",
        "path": "src/batch.py",
        "diff": "--- a/src/batch.py\n+++ b/src/batch.py\n@@ -10,3 +10,5 @@\n def process_batch(items):\n+    if not items:\n+        return []\n     result = items[0]\n"
      },
      {
        "step_idx": 2,
        "type": "bash_command",
        "command": "python -m pytest tests/test_batch.py -v",
        "output": "PASSED",
        "exit_code": 0
      }
    ]
  },
  "trace_b": {
    "agent": "swe_agent",
    "model": "gpt-4o",
    "structured_turns": [
      {
        "step_idx": 0,
        "type": "bash_command",
        "command": "find . -name '*.py' | xargs grep 'process_batch'",
        "output": "src/batch.py:def process_batch(items):\ntests/test_batch.py:    process_batch([])",
        "exit_code": 0
      },
      {
        "step_idx": 1,
        "type": "file_read",
        "path": "src/batch.py",
        "content": "def process_batch(items):\n    result = items[0]\n    ...",
        "start_line": 1,
        "end_line": 50
      },
      {
        "step_idx": 2,
        "type": "file_edit",
        "path": "src/batch.py",
        "diff": "--- a/src/batch.py\n+++ b/src/batch.py\n@@ -10,3 +10,6 @@\n def process_batch(items):\n+    if items is None or len(items) == 0:\n+        logger.warning('Empty input to process_batch')\n+        return []\n     result = items[0]\n"
      },
      {
        "step_idx": 3,
        "type": "bash_command",
        "command": "python -m pytest tests/ -v",
        "output": "PASSED (12 tests)",
        "exit_code": 0
      }
    ]
  }
}
Constituer des paires à partir de traces individuelles
Si vous disposez de traces individuelles portant toutes sur les mêmes tâches, l'utilitaire d'appariement les assemble :
# Generate all possible pairs for each task
potato pair-traces \
  --input ./data/individual_traces.jsonl \
  --output ./data/paired_traces.jsonl \
  --pair_by "task_id" \
  --strategy "all_pairs"

# Or sample a fixed number of pairs per task
potato pair-traces \
  --input ./data/individual_traces.jsonl \
  --output ./data/paired_traces.jsonl \
  --pair_by "task_id" \
  --strategy "sample" \
  --pairs_per_task 3
Exporter les données de comparaison
Paires de préférence DPO/RLHF
Le principal format d'export des comparaisons par paires est celui des paires de préférence pour l'entraînement DPO ou RLHF :
potato export \
  --format dpo_preferences \
  --project ./output/ \
  --output ./training_data/preferences.jsonl
En mode binaire, la sortie est simple :
{
  "prompt": "Fix the IndexError in process_batch() when the input list is empty",
  "chosen": {"agent": "claude_code", "trace_id": "trace_a_001", "steps": [...]},
  "rejected": {"agent": "swe_agent", "trace_id": "trace_b_001", "steps": [...]},
  "annotator": "judge1",
  "confidence": "high"
}
Le mode échelle ajoute l'intensité de la préférence :
{
  "prompt": "Fix the IndexError in process_batch()",
  "chosen": {"agent": "claude_code", "trace_id": "trace_a_001"},
  "rejected": {"agent": "swe_agent", "trace_id": "trace_b_001"},
  "preference_strength": 0.83,
  "scale_value": 2,
  "justification": "Agent A found and fixed the bug in fewer steps with cleaner code"
}
Le mode multidimension transporte les préférences par dimension :
{
  "prompt": "Fix the IndexError in process_batch()",
  "chosen": {"agent": "claude_code", "trace_id": "trace_a_001"},
  "rejected": {"agent": "swe_agent", "trace_id": "trace_b_001"},
  "overall_preference": "A",
  "dimensions": {
    "correctness": {"preference": "Tie", "justification": "Both correctly fix the bug"},
    "efficiency": {"preference": "A", "justification": "A solves it in 3 steps vs 4"},
    "code_quality": {"preference": "B", "justification": "B adds logging and handles None"},
    "communication": {"preference": "A", "justification": "A's reasoning is more focused"},
    "robustness": {"preference": "B", "justification": "B runs full test suite, not just one file"}
  },
  "weighted_score_a": 0.55,
  "weighted_score_b": 0.45
}
Analyse : taux de victoire, scores Elo et détail par dimension
Calculer les taux de victoire
import json
from collections import defaultdict

with open("training_data/preferences.jsonl") as f:
    prefs = [json.loads(line) for line in f]

wins = defaultdict(lambda: {"wins": 0, "losses": 0, "ties": 0})

for pref in prefs:
    agent_chosen = pref["chosen"]["agent"]
    agent_rejected = pref["rejected"]["agent"]

    if agent_chosen == agent_rejected:
        continue  # Skip self-comparisons

    if pref.get("overall_preference") == "Tie":
        wins[agent_chosen]["ties"] += 1
        wins[agent_rejected]["ties"] += 1
    else:
        wins[agent_chosen]["wins"] += 1
        wins[agent_rejected]["losses"] += 1

print("Agent Win Rates:")
print("-" * 55)
for agent, record in sorted(wins.items()):
    total = record["wins"] + record["losses"] + record["ties"]
    win_rate = (record["wins"] + 0.5 * record["ties"]) / total * 100
    print(f"  {agent:<20} {win_rate:5.1f}%  "
          f"(W:{record['wins']} L:{record['losses']} T:{record['ties']})")
Calculer les scores Elo
import json
import math
from collections import defaultdict

def compute_elo(preferences, k=32, initial_rating=1500):
    """Compute Elo ratings from pairwise preferences."""
    ratings = defaultdict(lambda: initial_rating)

    for pref in preferences:
        agent_a = pref["chosen"]["agent"]
        agent_b = pref["rejected"]["agent"]

        ra = ratings[agent_a]
        rb = ratings[agent_b]

        # Expected scores
        ea = 1.0 / (1.0 + math.pow(10, (rb - ra) / 400))
        eb = 1.0 / (1.0 + math.pow(10, (ra - rb) / 400))

        overall = pref.get("overall_preference", "A")
        if overall == "Tie":
            sa, sb = 0.5, 0.5
        else:
            # "chosen" is the winner
            sa, sb = 1.0, 0.0

        ratings[agent_a] = ra + k * (sa - ea)
        ratings[agent_b] = rb + k * (sb - eb)

    return dict(ratings)

with open("training_data/preferences.jsonl") as f:
    prefs = [json.loads(line) for line in f]

ratings = compute_elo(prefs)

print("Elo Ratings:")
print("-" * 35)
for agent, rating in sorted(ratings.items(), key=lambda x: -x[1]):
    print(f"  {agent:<20} {rating:.0f}")
Détail par dimension
Pour les comparaisons multidimension, regardez sur quelles dimensions chaque agent se distingue :
import json
from collections import defaultdict

with open("training_data/preferences.jsonl") as f:
    prefs = [json.loads(line) for line in f]

# Only process multi-dimension annotations
multi_dim = [p for p in prefs if "dimensions" in p]

dim_wins = defaultdict(lambda: defaultdict(lambda: {"A": 0, "B": 0, "Tie": 0}))

for pref in multi_dim:
    agent_a = pref["chosen"]["agent"]
    agent_b = pref["rejected"]["agent"]
    pair_key = f"{agent_a} vs {agent_b}"

    for dim_name, dim_data in pref["dimensions"].items():
        dim_wins[dim_name][pair_key][dim_data["preference"]] += 1

print("Per-Dimension Win Rates:")
print("=" * 60)
for dim_name, matchups in sorted(dim_wins.items()):
    print(f"\n  {dim_name.upper()}")
    print(f"  {'-' * 50}")
    for pair, counts in matchups.items():
        total = counts["A"] + counts["B"] + counts["Tie"]
        a_rate = (counts["A"] + 0.5 * counts["Tie"]) / total * 100
        print(f"    {pair}: A={a_rate:.0f}% B={100-a_rate:.0f}%  "
              f"(A:{counts['A']} B:{counts['B']} Tie:{counts['Tie']})")
Ce qui marche en pratique
Choisir un mode
Le mode binaire s'impose quand vous voulez des milliers de préférences rapidement, un modèle de récompense généraliste ou un classement. Comptez environ 1 à 2 minutes par comparaison.
Le mode échelle se justifie quand l'intensité de la préférence alimente votre chaîne d'entraînement. Le DPO avec pondération par marge tient compte de la différence entre une préférence forte (curseur à l'extrémité) et une préférence faible (curseur près du centre). Comptez 2 à 3 minutes par comparaison.
Le mode multidimension vaut le temps supplémentaire quand vous devez savoir où les agents sont forts et où ils sont faibles, quand vous entraînez des modèles de récompense par dimension, ou quand vous devez un rapport détaillé aux développeurs de l'agent. Comptez 4 à 6 minutes par comparaison.
Combien de comparaisons il vous faut
Pour des taux de victoire fiables, recueillez au moins 100 comparaisons par paire d'agents. Pour des scores Elo sur cinq agents ou plus, 200 à 300 comparaisons au total suffisent à stabiliser le classement. Pour des modèles de récompense DPO, visez 1 000 paires de préférence ou plus, couvrant aussi bien des tâches faciles que difficiles.
Randomiser l'ordre
Mettez toujours randomize_order: true. Le biais de position, c'est-à-dire la tendance à préférer la trace qui apparaît à gauche ou dans le premier onglet, est bien documenté dans les études d'évaluation humaine. Associez cette randomisation au contrôle attention_checks.type: "duplicate_reversed" pour repérer ceux qui se contentent de cliquer toujours du même côté.
Gérer les égalités
En mode binaire, autorisez les égalités mais surveillez leur taux. S'il dépasse 30 %, les agents sont sans doute trop proches pour un verdict binaire et vous devriez passer au mode échelle ou multidimension. En mode échelle, l'égalité n'est que le point central. En mode multidimension, les égalités sur des dimensions isolées sont attendues et porteuses d'information.
Masquer l'identité des agents
Gardez show_agent_identity: false sauf raison sérieuse d'afficher l'information. Si les annotateurs savent quel agent a produit une trace, ils ont tendance à favoriser celui qu'ils s'attendent déjà à trouver meilleur.
Combiner les modes
Pour une évaluation complète, passez d'abord en mode binaire sur un grand ensemble de paires afin d'obtenir un classement d'ensemble, puis en mode multidimension sur un sous-ensemble stratifié plus petit pour le détail diagnostique. Les comparaisons binaires alimentent l'entraînement du modèle de récompense ; les comparaisons multidimension vous disent où concentrer les améliorations de l'agent.
Pour la référence de configuration de ces modes, voir la documentation source. Pour un parcours plus large de l'évaluation d'agents de bout en bout, commencez par le guide d'évaluation des agents.