Évaluer les agents IA : annotation humaine des traces d'agents
Comment mettre en place dans Potato l'évaluation humaine des sorties d'agents IA, de l'import des traces et de la conception de schémas par trace et par étape jusqu'à l'analyse des résultats exportés.
Convertissez les traces d'agents avec python -m potato.trace_converter, affichez-les dans un champ d'affichage agent_trace et recueillez un verdict au niveau de la trace en même temps qu'un jugement trajectory_eval par étape. C'est le jugement par étape qui situe l'étape où l'exécution a déraillé.
Un taux de réussite vous dit à quelle fréquence un agent termine la tâche, et rien sur la raison des échecs. Deux agents avec le même taux de réussite de 62 % peuvent échouer pour des raisons complètement différentes, l'un parce qu'il choisit le mauvais outil, l'autre parce qu'il raisonne correctement sur une mauvaise récupération, et la correction n'est pas la même dans les deux cas. L'évaluation humaine au niveau de l'étape les distingue, parce que l'annotateur indique quelle étape a cassé et de quel type de casse il s'agit.
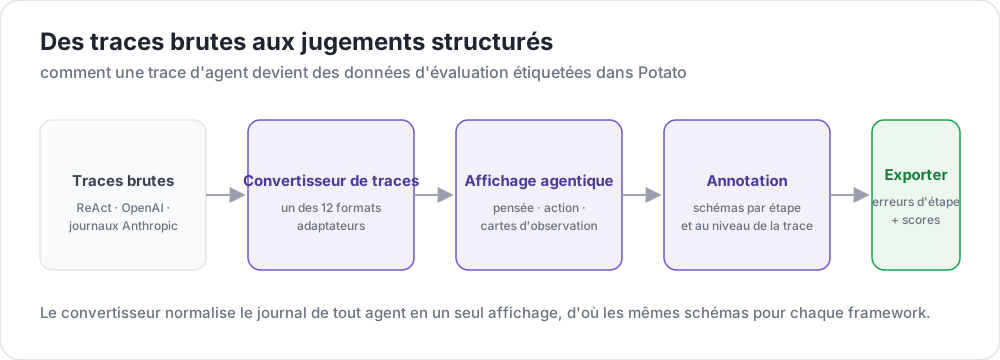 Des traces brutes aux jugements structurés
Ce guide construit le pipeline pour un agent de type ReAct qui répond à des questions en cherchant sur le web. Les configurations sont vérifiées avec Potato 2.9.1 :
pip install --upgrade potato-annotationÉtape 1 : convertir les traces
Potato enregistre 15 convertisseurs de traces, et la CLI les liste avec leur description :
python -m potato.trace_converter --list-formatsLa liste comprend react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code et aider. Les exports d'exécutions LangSmith passent par langchain, et les logs CrewAI, AutoGen et LangGraph passent par multi_agent.
Le convertisseur react lit une trace dont les étapes portent les clés thought, action et observation :
{
  "id": "trace_001",
  "task": "What is the capital of Australia and what is its population?",
  "steps": [
    {"thought": "I need the capital of Australia and then its population.",
     "action": "search('capital of Australia')",
     "observation": "Canberra is the capital city of Australia."},
    {"thought": "Now I need Canberra's population.",
     "action": "search('Canberra population 2025')",
     "observation": "Canberra has a population of approximately 467,000 as of 2025."},
    {"thought": "I have both pieces of information.",
     "action": "finish('Canberra, approximately 467,000')"}
  ],
  "metadata": {"agent": "GPT-4", "tokens": 2340}
}
Une seule commande convertit le fichier :
python -m potato.trace_converter \
  --input raw_traces.json \
  --input-format react \
  --output data/traces.jsonl
Passez --auto-detect à la place de --input-format quand vous ne savez pas quel convertisseur convient, et le registre en choisit un d'après les signatures des champs. Indiquez le format explicitement dès que vous le connaissez, car la détection prend le premier convertisseur qui correspond et plusieurs formats se recoupent dans les champs qu'ils contiennent.
Tous les convertisseurs écrivent la même forme canonique, et c'est ce qui permet à une seule configuration de fonctionner d'un framework à l'autre. Chaque ligne contient id, task_description et conversation, une liste de tours avec un speaker et un text. Un convertisseur qui en dispose écrit aussi agent_name, metadata_table et screenshots :
{
  "id": "trace_001",
  "task_description": "What is the capital of Australia and what is its population?",
  "agent_name": "GPT-4",
  "metadata_table": [{"Property": "Steps", "Value": "3"},
                     {"Property": "tokens", "Value": "2340"}],
  "conversation": [
    {"speaker": "Agent (Thought)", "text": "I need the capital of Australia and then its population."},
    {"speaker": "Agent (Action)", "text": "search('capital of Australia')"},
    {"speaker": "Environment", "text": "Canberra is the capital city of Australia."}
  ]
}
Étape 2 : afficher la trace
L'affichage agent_trace présente chaque tour sous forme de carte, avec une couleur selon le type d'étape, pour que l'annotateur lise l'exécution plutôt qu'un bloc de JSON :

instance_display décide de ce qui figure sur la page et dans quel ordre. La description de la tâche est en haut, parce que l'annotateur doit savoir ce qu'on a demandé à l'agent avant qu'une étape ait un sens, et la table des métadonnées se trouve en dessous dans un champ tableur compact :
instance_display:
  layout:
    direction: vertical
    gap: 16px

  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120

    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Réduire les observations empêche les longs résultats de recherche de repousser le reste de la trace hors de l'écran, car une trace qui contient une douzaine de résultats de recherche complets se résume surtout à faire défiler, et l'annotateur perd le fil de l'endroit où il se trouve dans l'exécution. Mettre span_target: true sur le même champ permet à un schéma de spans de marquer les mots exacts d'une affirmation hallucinée dans un tour, ce qui est un relevé plus fin que marquer toute l'étape comme fausse.
Étape 3 : le jugement au niveau de la trace
Trois questions couvrent la trace dans son ensemble. La réussite de la tâche est le chiffre principal, l'exactitude de la réponse distingue une bonne réponse obtenue par un mauvais chemin d'une mauvaise réponse, et l'efficacité est ce qui sépare deux agents qui réussissent tous les deux :
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
        tooltip: "Fully completed correctly"
      - name: "Partial success"
        tooltip: "Completed with errors or omissions"
      - name: "Failure"
        tooltip: "Not completed"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3
« Cannot determine » a sa place. Sans cette option, un annotateur qui n'a aucun moyen de vérifier la réponse devine ou la marque incorrecte, et les deux choix ajoutent du bruit au chiffre qui compte le plus pour vous.
Étape 4 : le jugement par étape
trajectory_eval affiche chaque étape sous forme de carte avec ses propres contrôles, et regroupe l'étiquette d'exactitude, la taxonomie d'erreurs et la gravité dans un seul schéma au lieu de trois. Faites pointer steps_key vers le champ qui contient les étapes, conversation pour une trace convertie, et step_text_key vers la clé de chaque étape à afficher :
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options:
      - correct
      - partially_correct
      - incorrect
      - unnecessary
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - factual_error
          - planning_error
      - name: execution
        subtypes:
          - wrong_tool
          - wrong_args
          - api_error
      - name: termination
        subtypes:
          - premature_stop
          - redundant_step
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100
Les poids de gravité transforment une liste d'étapes marquées en un seul nombre comparable par trace, et il vaut mieux modifier les valeurs par défaut que les accepter telles quelles. Un poids indique à quel point une erreur critique est plus grave qu'une erreur mineure pour votre tâche, et dans une évaluation de sécurité ce rapport est bien plus élevé que dans une tâche de recherche.
Séparer unnecessary de incorrect est l'autre décision à prendre délibérément. Une étape inutile coûte des tokens et du temps sans introduire d'erreur, et fusionner les deux masque la différence entre un agent qui tâtonne et un agent qui se trompe.
Étape 5 : la configuration complète
Tout ce qui précède, dans un seul fichier :
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."
output_annotation_dir: "output/"

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: task_description

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120
    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
      - name: "Partial success"
      - name: "Failure"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3

  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options: [correct, partially_correct, incorrect, unnecessary]
    error_types:
      - name: reasoning
        subtypes: [logical_error, factual_error, planning_error]
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
      - name: termination
        subtypes: [premature_stop, redundant_step]
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

export_annotation_format: jsonl
Démarrez le serveur et ouvrez http://localhost:8000 :
potato start config.yaml -p 8000À quoi ressemble la session d'annotation
La page affiche la tâche, la table d'informations de la trace et les cartes d'étapes, avec les contrôles par étape attachés à chaque carte et les schémas au niveau de la trace sous la trace. L'ordre dans lequel les annotateurs travaillent compte plus qu'il n'y paraît. Noter d'abord les étapes puis la trace garde le verdict global ancré dans ce que l'exécution a réellement fait, alors que noter d'abord la réussite tend à colorer chacun des jugements d'étape qui suivent.
Trois habitudes méritent d'être écrites dans les consignes des annotateurs. Développer les observations réduites plutôt que de se fier à la ligne de résumé, car un résultat de recherche mal lu est la source la plus fréquente d'une mauvaise réponse qui a l'air bien raisonnée. Vérifier la réponse finale par rapport à la vérité terrain avant de noter la réussite de la tâche, quand le jeu de données en a une. Utiliser la chronologie des étapes pour revenir à une étape quand une étape ultérieure révèle que la précédente était déjà fausse.
Étape 6 : exporter et analyser
L'exportateur JSONL écrit annotations.jsonl, avec un enregistrement par instance et par annotateur :
python -m potato.export --config config.yaml --format jsonl --output ./export/Chaque enregistrement contient instance_id, user_id, labels, spans et links, et les réponses aux schémas se trouvent sous labels, indexées par nom de schéma :
import json
import pandas as pd

records = [json.loads(line) for line in open("export/annotations.jsonl")]

df = pd.DataFrame([
    {"trace": r["instance_id"], "annotator": r["user_id"], **r["labels"]}
    for r in records
])

print(df["task_success"].value_counts())
Au-delà de quelques centaines de traces, exportez plutôt en Parquet et interrogez le fichier sur place. L'export Parquet écrit annotations.parquet avec instance_id, user_id et une colonne par schéma d'annotation, de sorte que le nom du schéma est une colonne et non une valeur :
python -m potato.export --config config.yaml --format parquet --output ./export/import duckdb
print(duckdb.sql("""
SELECT task_success, COUNT(*) AS n
FROM 'export/annotations.parquet'
GROUP BY task_success
ORDER BY n DESC
"""))Ce sont les jugements par étape qu'il faut lire en premier. Compter les sous-types d'erreurs sur l'ensemble des traces vous dit si l'agent a une défaillance systématique ou une longue traîne de défaillances sans lien entre elles, et seule la première justifie une correction ciblée.
Étape 7 : plus d'annotateurs et une phase de qualification
L'évaluation d'agents est assez subjective pour qu'une seule note par trace soit une mesure sans barre d'erreur. Trois annotateurs par trace vous donnent un chiffre d'accord, et l'attribution aléatoire évite que le recouvrement se concentre sur les traces qui se trouvent en tête du fichier :
num_annotators_per_item: 3
assignment_strategy: random
Une phase de qualification repère les annotateurs qui n'ont pas compris la taxonomie d'erreurs avant qu'ils ne passent une journée à l'appliquer de manière incohérente. Le bloc de formation les fait travailler sur des traces à réponse connue jusqu'à ce qu'ils réussissent :
training:
  enabled: true
  data_file: "data/training_traces.jsonl"
  passing_criteria:
    min_correct: 4
  allow_retry: true
  failure_action: "repeat_training"
Autres frameworks d'agents
L'affichage et les schémas restent les mêmes d'un framework à l'autre, et seul le convertisseur change. Les traces OpenAI Chat Completions et les messages Anthropic avec des blocs tool_use ont chacun leur convertisseur, et les logs multi-agents de CrewAI, AutoGen et LangGraph en partagent un :
python -m potato.trace_converter --input runs.json --input-format openai --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format anthropic --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format multi_agent --output data/traces.jsonl
Les agents de programmation ont besoin d'un autre affichage, parce qu'un diff lu comme une chaîne JSON est impossible à relire. L'affichage coding_trace présente des diffs unifiés avec une arborescence de fichiers et réduit les longues sorties du terminal :

instance_display:
  fields:
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
Les agents de navigation web ont besoin des captures d'écran, des superpositions d'actions et d'une pellicule pour les parcourir :
instance_display:
  fields:
    - key: steps
      type: web_agent_trace
      label: "Agent Browsing Trace"
      display_options:
        show_overlays: true
        show_filmstrip: true
        show_thought: true
        screenshot_max_width: 900
Annoter les agents de navigation web présente le format des superpositions et le mode de création qui enregistre de nouvelles traces.
Pour les détails d'implémentation derrière tout cela, consultez le guide d'évaluation des agents et la documentation des traces d'agents. Si vous préparez votre première évaluation, convertissez dix traces, lancez la configuration ci-dessus et annotez-les vous-même avant de rédiger les consignes, car la taxonomie d'erreurs dont vous avez besoin n'est généralement pas celle que vous auriez écrite à l'avance.
Pour aller plus loin
- Documentation de l'annotation agentique
- Annoter les agents de navigation web
- Mode solo, pour combiner l'annotation agentique avec une évaluation collaborative entre humains et LLM
- Best-Worst Scaling, pour classer des sorties d'agents de manière comparative
- Export Parquet, pour l'analyse à grande échelle