Phase de formation
Créez des phases de formation et de qualification dans Potato avec des questions d'exercice, des réponses étalons et des seuils de réussite pour certifier les annotateurs avant la tâche principale.
Potato 2.0 propose une phase de formation facultative qui permet de qualifier les annotateurs avant qu'ils n'abordent la tâche d'annotation principale. Les annotateurs répondent à des questions d'exercice dont la bonne réponse est connue et reçoivent un retour sur leurs résultats.
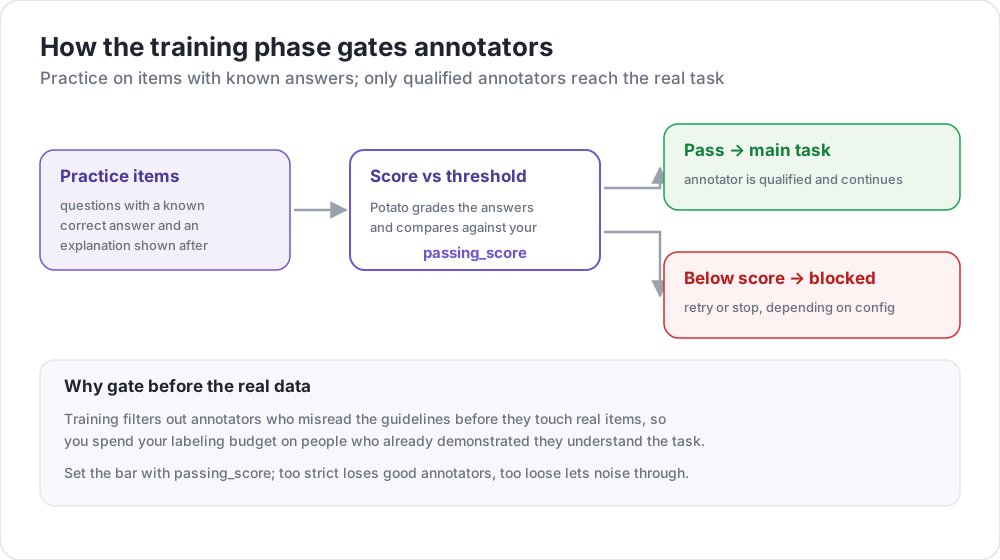 Comment la phase de formation filtre les annotateurs
Cas d'usage
- Vérifier que les annotateurs ont compris la tâche
- Écarter les annotateurs peu fiables
- Proposer un exercice guidé avant les vraies annotations
- Recueillir des mesures de qualité de référence
- Enseigner les consignes d'annotation par l'exemple
Fonctionnement
- Les annotateurs répondent à une série de questions de formation
- Ils reçoivent un retour immédiat sur chaque réponse
- La progression est suivie par rapport aux critères de réussite
- Seuls les annotateurs qui réussissent accèdent à la tâche principale
Configuration
Configuration de base
training:
  enabled: true
  data_file: "data/training_data.json"
  annotation_schemes: ["sentiment"]
  passing_criteria:
    min_correct: 3
    require_all_correct: false
  allow_retry: true
  failure_action: "repeat_training"
Configuration complète
phases:
  order: [consent, instructions, training, annotation]

  consent:
    type: consent
    file: surveyflow/consent.json

  instructions:
    type: instructions
    file: surveyflow/instructions.html

  training:
    type: training
    file: data/training_data.json
Critères de réussite
Vous pouvez définir différents critères pour valider la phase de formation :
Nombre minimal de bonnes réponses
passing_criteria:
  min_correct: 3
L'annotateur doit répondre correctement à au moins 8 questions sur 10.
Toutes les réponses correctes
passing_criteria:
  require_all_correct: true
L'annotateur doit répondre correctement à toutes les questions pour réussir.
Nombre maximal d'erreurs
passing_criteria:
  max_mistakes: 5
L'annotateur est disqualifié après 3 erreurs au total.
Nombre maximal d'erreurs par question
passing_criteria:
  max_mistakes_per_question: 2
L'annotateur est disqualifié après 2 erreurs sur une même question.
Critères combinés
passing_criteria:
  min_correct: 3
  max_mistakes: 5
  max_mistakes_per_question: 2
Il faut 8 bonnes réponses ET ne pas se tromper plus de 3 fois sur une même question.
Format des données de formation
Les données de formation doivent contenir les bonnes réponses et, éventuellement, des explications :
[
  {
    "id": "train_1",
    "text": "I absolutely love this product! Best purchase ever!",
    "correct_answers": {
      "sentiment": "Positive"
    },
    "explanation": "This text expresses strong positive sentiment with words like 'love' and 'best'."
  },
  {
    "id": "train_2",
    "text": "This is the worst service I've ever experienced.",
    "correct_answers": {
      "sentiment": "Negative"
    },
    "explanation": "The words 'worst' and the overall complaint indicate negative sentiment."
  },
  {
    "id": "train_3",
    "text": "The package arrived on time.",
    "correct_answers": {
      "sentiment": "Neutral"
    },
    "explanation": "This is a factual statement without emotional indicators."
  }
]
Formation sur plusieurs schémas
Pour les tâches comportant plusieurs schémas d'annotation :
{
  "id": "train_1",
  "text": "Apple announced new iPhone features yesterday.",
  "correct_answers": {
    "sentiment": "Neutral",
    "topic": "Technology"
  },
  "explanation": {
    "sentiment": "This is a factual news statement.",
    "topic": "The text discusses Apple and iPhone, which are tech topics."
  }
}
Expérience utilisateur
Déroulement de la formation
- L'utilisateur voit un indicateur « Phase de formation »
- La question s'affiche avec le formulaire d'annotation
- L'utilisateur soumet sa réponse
- Le retour est affiché immédiatement :
- Bonne réponse : coche verte, passage à la suivante
- Mauvaise réponse : croix rouge, explication affichée, possibilité de réessayer
Affichage du retour
Quand un annotateur se trompe :
- La bonne réponse est mise en évidence
- L'explication fournie est affichée
- Un bouton pour réessayer apparaît (si les nouvelles tentatives sont activées)
- La progression vers les critères de réussite est affichée
Suivi côté administration
Suivez les résultats de la formation dans le tableau de bord d'administration :
- Taux d'achèvement
- Nombre moyen de bonnes réponses
- Taux de réussite et d'échec
- Temps passé sur la formation
- Justesse par question
Accès via les points de terminaison de l'API /admin :
GET /api/admin/training/stats
GET /api/admin/training/user/{user_id}
Exemple : formation à l'analyse de sentiment
annotation_task_name: "Sentiment Analysis"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment of this review?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

training:
  enabled: true
  data_file: "data/training_data.json"
  annotation_schemes: ["sentiment"]
  passing_criteria:
    min_correct: 3
    require_all_correct: false
  allow_retry: true
  failure_action: "repeat_training"

phases:
  order: [training, annotation]
  training:
    type: training
    file: "data/training_data.json"

output_annotation_dir: "output/"
export_annotation_format: "jsonl"

user_config:
  allow_all_users: true
Exemple : formation à la reconnaissance d'entités nommées
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - Person
      - Organization
      - Location
      - Date

training:
  enabled: true
  data_file: "data/ner_training.json"
  annotation_schemes: ["entities"]
  passing_criteria:
    min_correct: 2
  allow_retry: true
Données de formation pour l'annotation d'empans :
{
  "id": "train_1",
  "text": "Tim Cook announced that Apple will open a new store in New York on March 15.",
  "correct_answers": {
    "entities": [
      {"start": 0, "end": 8, "label": "Person"},
      {"start": 24, "end": 29, "label": "Organization"},
      {"start": 54, "end": 62, "label": "Location"},
      {"start": 66, "end": 74, "label": "Date"}
    ]
  },
  "explanation": "Tim Cook is a Person, Apple is an Organization, New York is a Location, and March 15 is a Date."
}
Bonnes pratiques
1. Commencer simple
Commencez par des exemples francs avant d'introduire les cas limites :
[
  {"text": "I love this!", "correct_answers": {"sentiment": "Positive"}},
  {"text": "I hate this!", "correct_answers": {"sentiment": "Negative"}},
  {"text": "It arrived yesterday.", "correct_answers": {"sentiment": "Neutral"}}
]
2. Couvrir toutes les étiquettes
Veillez à ce que la formation contienne des exemples de chaque étiquette possible :
[
  {"correct_answers": {"sentiment": "Positive"}},
  {"correct_answers": {"sentiment": "Negative"}},
  {"correct_answers": {"sentiment": "Neutral"}}
]
3. Rédiger des explications claires
Les explications doivent enseigner les consignes d'annotation :
{
  "explanation": "While this text mentions a problem, the overall tone is constructive and the reviewer expresses satisfaction with the resolution. This makes it Positive rather than Negative."
}
4. Fixer des critères raisonnables
N'exigez pas la perfection sans raison :
passing_criteria:
  require_all_correct: true
5. Inclure des cas limites
Ajoutez des exemples délicats pour préparer les annotateurs :
{
  "text": "Not bad at all, I guess it could be worse.",
  "correct_answers": {"sentiment": "Neutral"},
  "explanation": "Despite negative words like 'not bad' and 'worse', this is actually a lukewarm endorsement - neutral rather than positive or negative."
}
Intégration aux flux de travail
La formation s'intègre aux flux de travail multi-phases :
passing_criteria:
  min_correct: 3
  max_mistakes_per_question: 2
Performances
- Les données de formation sont chargées au démarrage
- La progression est conservée en mémoire, par session
- L'impact sur les performances de l'annotation principale est négligeable
- Pour une formation complexe, envisagez de la répartir sur plusieurs phases
Pour aller plus loin
- Contrôle de la qualité - Contrôles d'attention et étalons
- Attribution par catégorie - Acheminer les éléments selon l'expertise des annotateurs
- Flux de travail multi-phases - Flux de travail d'annotation complexes
Pour les détails d'implémentation, consultez la documentation source.