Apprentissage actif
Réordonnez la file d'annotation de Potato selon l'incertitude du modèle, avec cinq stratégies de sélection, des classifieurs sklearn, la gestion du démarrage à froid et la persistance des modèles entre redémarrages.
L'apprentissage actif réordonne la file d'annotation pour que les annotateurs voient les instances dont un modèle est le moins sûr, au lieu de parcourir le corpus dans l'ordre où il est arrivé.
Fonctionnement
- Collecter un premier ensemble d'annotations
- Entraîner un classifieur sur ce qui a été étiqueté jusqu'ici
- Évaluer l'incertitude sur le vivier non étiqueté
- Réordonner la file pour placer les instances les plus incertaines en tête
- Annoter les instances prioritaires
- Réentraîner périodiquement à mesure que les annotations s'accumulent
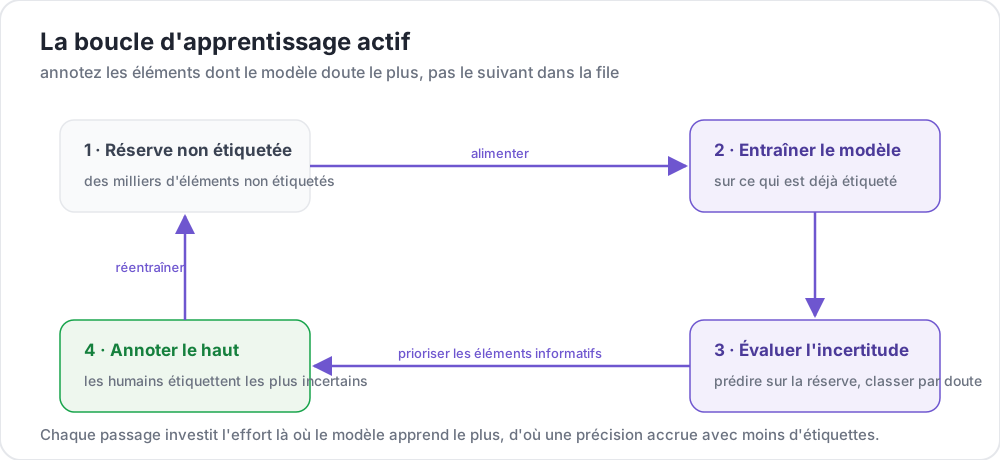 Consacrer l'effort d'annotation là où le modèle apprend le plus
Configuration
Configuration de base
active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000
min_instances_for_training vaut 10 par défaut et update_frequency vaut 5. Ces deux valeurs sont assez basses pour mériter d'être relevées sur un vrai projet, car réentraîner toutes les cinq annotations dépense du calcul sur un modèle qui a à peine changé.
Configuration complète
active_learning:
  enabled: true

  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000

  # How disagreement between annotators resolves into one training label
  resolution_strategy: majority_vote

  # Fraction of the queue left in random order, so the model does not
  # only ever see what it already found interesting
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
Les blocs imbriqués classifier, vectorizer et model_persistence sont la forme documentée, et celle que reconnaît potato validate --strict. Leurs sous-clés sont name et hyperparameters pour les deux premiers, et enabled, save_directory et retention_count pour le troisième. Un bloc qui utilise d'autres noms de sous-clés est ignoré sans avertissement, et l'exécution revient silencieusement aux valeurs par défaut.
Stratégies de sélection
| Stratégie | Description |
|---|---|
uncertainty | Instances sur lesquelles le modèle est le moins confiant. Valeur par défaut |
diversity | Instances les moins semblables à ce qui a déjà été annoté |
badge | Batch Active learning by Diverse Gradient Embeddings |
bald | Bayesian Active Learning by Disagreement |
hybrid | Combinaison pondérée de l'incertitude et de la diversité |
active_learning:
  query_strategy: uncertainty
Un nom de stratégie non reconnu revient à uncertainty avec un avertissement au lieu de faire échouer le démarrage. Consultez donc le journal si une stratégie semble n'avoir aucun effet.
Réglage de hybrid et de BALD
hybrid pondère par défaut l'incertitude à 70 % et la diversité à 30 % :
active_learning:
  query_strategy: hybrid
  hybrid_weights:
    uncertainty: 0.7
    diversity: 0.3
bald entraîne un petit ensemble de modèles et classe les instances selon le désaccord au sein de cet ensemble :
active_learning:
  query_strategy: bald
  bald_params:
    n_estimators: 5
    bootstrap_fraction: 0.8
Classifieurs
Les classifieurs se désignent par leur chemin d'import sklearn. La valeur par défaut est sklearn.linear_model.LogisticRegression.
| Classifieur | Chemin | Convient à | Vitesse |
|---|---|---|---|
| Régression logistique | sklearn.linear_model.LogisticRegression | La plupart des tâches sur du texte | Rapide |
| Forêt aléatoire | sklearn.ensemble.RandomForestClassifier | Motifs non linéaires | Moyenne |
| SVC | sklearn.svm.SVC | Petits jeux de données | Lente |
| Multinomial NB | sklearn.naive_bayes.MultinomialNB | Classification de texte simple | Très rapide |
La régression logistique, point de départ recommandé :
active_learning:
  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000
La forêt aléatoire, quand la frontière de décision est loin d'être linéaire :
active_learning:
  classifier:
    name: sklearn.ensemble.RandomForestClassifier
    hyperparameters:
      n_estimators: 100
      max_depth: 10
Un SVC doit être configuré pour produire des probabilités, puisque le score d'incertitude en dépend :
active_learning:
  classifier:
    name: sklearn.svm.SVC
    hyperparameters:
      kernel: rbf
      probability: true
Naive Bayes, quand la vitesse compte davantage que le dernier point de justesse :
active_learning:
  classifier:
    name: sklearn.naive_bayes.MultinomialNB
    hyperparameters:
      alpha: 1.0
calibrate_probabilities est activé par défaut. C'est important, car l'échantillonnage par incertitude classe selon la probabilité prédite, et un classifieur non calibré classe les éléments sur lesquels il se trompe avec assurance comme s'ils étaient réglés.
Vectoriseurs
La valeur par défaut est sklearn.feature_extraction.text.TfidfVectorizer.
TF-IDF, traits pondérés :
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]
      stop_words: english
Simples comptages :
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.CountVectorizer
    hyperparameters:
      max_features: 3000
      ngram_range: [1, 1]
Hachage, pour un vocabulaire trop grand pour tenir en mémoire :
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.HashingVectorizer
    hyperparameters:
      n_features: 10000
ngram_range s'écrit comme une liste YAML et est converti en tuple, la forme qu'attend sklearn. [1, 2] est donc correct ici et ne demande aucune syntaxe particulière.
Démarrage à froid
Tant qu'aucun modèle n'existe, il n'y a rien sur quoi être incertain, donc le premier lot est choisi sans modèle :
active_learning:
  cold_start_strategy: random
  cold_start_batch_size: 20
Sélection assistée par LLM
Un LLM peut évaluer les instances pendant la période de démarrage à froid ou en parallèle du classifieur :
active_learning:
  enabled: true
  schema_names:
    - sentiment

  llm:
    enabled: true
    endpoint_type: vllm
    base_url: http://localhost:8000/v1
    model: meta-llama/Llama-3.2-3B-Instruct
    confidence_method: verbalized
confidence_method détermine comment le score de confiance est obtenu. Ce choix compte, car c'est ce score qui pilote la sélection :
| Méthode | Fonctionnement | Compromis |
|---|---|---|
verbalized | Le modèle indique lui-même sa confiance sur une échelle de 1 à 10 | Universel, mais peu fiable avec certains modèles |
logprobs | Calculé à partir des log-probabilités des tokens | Le mieux calibré, exige un endpoint qui renvoie les logprobs |
consistency | La même instance est soumise plusieurs fois et notée selon l'accord entre les réponses | Fonctionne partout, au prix de N appels par instance |
logprobs revient à la confiance verbalisée quand l'endpoint ne renvoie pas de log-probabilités.
Persistance des modèles
Les modèles entraînés peuvent survivre à un redémarrage au lieu d'être reconstruits de zéro :
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
retention_count vaut 2 par défaut et plafonne le nombre de modèles enregistrés conservés.
La persistance en base de données n'est plus configurable. Les clés database_enabled et database_config ont été supprimées, car la couche qu'elles pilotaient était une coquille vide qui journalisait un succès sans rien stocker. L'historique des exécutions est désormais toujours enregistré et ne demande aucune configuration, et les deux clés sont ignorées si une configuration les contient encore.
Plusieurs schémas
schema_names liste les schémas dont les annotations entraînent le modèle. S'il n'est pas défini, il prend par défaut les schémas étiquetables du projet :
annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels: [Positive, Negative, Neutral]

  - annotation_type: radio
    name: topic
    description: "What is the topic?"
    labels: [Politics, Sports, Tech, Entertainment]

active_learning:
  enabled: true
  schema_names:
    - sentiment
    - topic
Configuration complète
annotation_task_name: "Sentiment Analysis with Active Learning"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 30
  update_frequency: 50
  max_instances_to_reorder: 500
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5

output_annotation_dir: "output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Combiner avec le support IA
L'apprentissage actif décide de ce qui s'affiche ensuite. Le support IA aide l'annotateur sur ce qui est à l'écran. Les deux sont indépendants et se combinent :
active_learning:
  enabled: true
  schema_names:
    - sentiment
  min_instances_for_training: 30

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true
Interprétez le résultat avec prudence. Si le modèle suggère une étiquette que l'annotateur accepte, et qu'un modèle de la même famille a choisi l'instance, l'accord mesuré à la fin est en partie le modèle en accord avec lui-même.
Suivi
Le tableau de bord d'administration indique la justesse du modèle, le nombre de cycles d'entraînement, la distribution de l'incertitude et le nombre d'instances restantes. Pour y accéder, il faut la clé d'administration ou un rôle doté de view_admin_dashboard.
Bonnes pratiques
Recueillir d'abord une base
On ne peut rien entraîner sur un ensemble vide, et un modèle entraîné sur vingt annotations réordonne surtout du bruit :
active_learning:
  min_instances_for_training: 50
Surveiller l'équilibre des classes
L'échantillonnage par incertitude se concentre sur la frontière de décision, ce qui éloigne la distribution des étiquettes de celle du corpus. C'est sans conséquence pour entraîner un modèle, mais trompeur si vous présentez l'échantillon annoté comme une description des données. random_sample_percent garde une partie de la file sans biais précisément pour cette raison.
Ne pas réentraîner trop souvent
active_learning:
  update_frequency: 100
Conserver les modèles entre redémarrages
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
Dépannage
L'entraînement ne démarre jamais
Vérifiez que les annotations ont atteint min_instances_for_training et que chaque classe a au moins un exemple. Un ensemble d'entraînement à une seule classe ne permet pas d'ajuster un classifieur.
Le réordonnancement semble sans effet
Cherchez dans le journal une query_strategy inconnue, qui revient silencieusement à l'incertitude. Vérifiez enabled: true, et que schema_names nomme des schémas qui existent réellement.
Lenteur avec un gros vivier
Réduisez max_instances_to_reorder, augmentez update_frequency, ou passez à HashingVectorizer pour un très grand vocabulaire.
Pour aller plus loin
- Support IA - Assistance par LLM pendant l'annotation
- Attribution des tâches - Les autres stratégies d'attribution
- Tableau de bord d'administration - Suivre la boucle d'entraînement
- Ordonnancement par diversité - Ordonnancement fondé sur des embeddings, sans classifieur
Pour les détails d'implémentation, consultez la documentation source.