Truth Serum
把意外流行打分用到標註上。每個標籤後面多問一個小問題,就能讓 Potato 在難題上勝過多數投票,全程不需要任何黃金標籤。
v2.7.0 新增
多數投票偏偏在標註最難的地方失效:一群人自信地答錯,而知情的少數人是對的。Truth Serum 在每次給出標籤之後追加一個小問題。
你選的是 Sarcastic。你覺得有多大比例的其他標註者會和你選一樣的標籤?
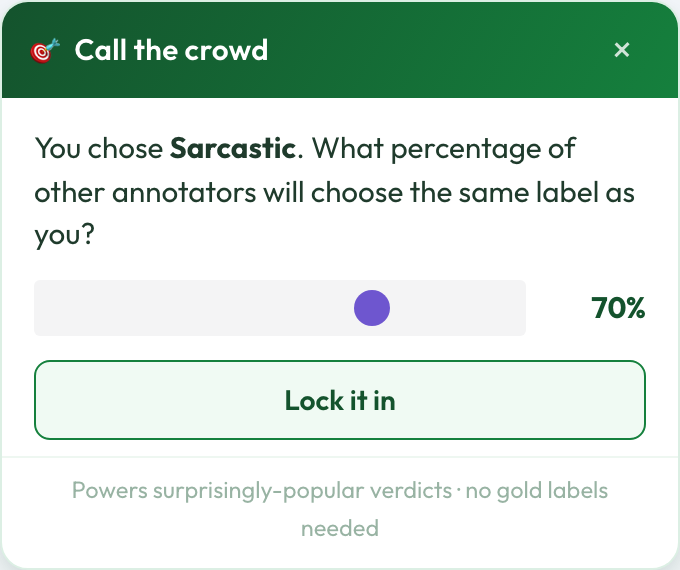
一個滑塊,一次點選。這些預測支撐起意外流行(surprisingly popular)原則(Prelec 2004;Prelec、Seung 與 McCoy 2017,Nature):實際流行度超出預測流行度最多的那個標籤,就是當前能拿到的對真相的最佳估計,而且計算它不需要任何黃金標籤。
背後的直覺是,持有正確少數派觀點的人通常知道自己是少數派,所以他們的答案最後會比所有人預測的都更流行。
據我們所知,Potato 是第一個提供同伴預測打分的標註工具。
你能得到什麼
- 在難題上勝過多數投票的條目判定。 儀表板上的“多數可能出錯的地方”佇列會列出所有意外流行標籤與多數標籤不一致的實例。優先審這些,或者把它們送去裁定。
- 標註者校準分數。 每位標註者預測的一致度,和他們實際從同伴那裡得到的一致度差了多遠。過度自信和校準不良的標註者不需要任何黃金題目就會浮出水面。
- SP 對齊度。 每位標註者的標籤與意外流行判定一致的頻率,這是“是否真的知情”而非“是否只是隨大流”的一個代理指標。
配置
yaml
truth_serum:
  enabled: true
  schema: sarcasm            # scheme to collect predictions for (default: first radio)
  min_annotators: 3          # predictions per item before a verdict is computed
# question: "What percentage of other annotators will choose the same label as you?"| 選項 | 預設值 | 說明 |
|---|---|---|
enabled | false | 總開關。 |
schema | 第一個 radio 方案 | 哪個方案的標籤會被要求預測流行度。 |
question | 見上 | 顯示在滑塊上方的提問。 |
min_annotators | 3 | 計算判定前每個條目所需的最少預測數(下限為 2)。 |
方法說明
在論文裡引用 Truth Serum 之前,請先讀這幾條。
- 這是簡化的自答預測變體。每位標註者只預測自己所選標籤的流行度,而不是給出所有標籤上的完整分佈。一個標籤的預測流行度是其支持者預測值的均值,它的意外度是
actual % − predicted %,SP 判定就是被投過票的標籤中意外度最高的那個。 - 只有在預測數達到
min_annotators或以上時才會算判定。小樣本的判定噪聲很大;3 是下限而不是推薦值,5 以上更好。 - 校準誤差是拿每個預測去比對該條目上其他標註者之間的一致度,把標註者自己排除在外。
- 標註者可以改。每個實例上最後一對 (標籤, 預測) 生效。
資料與 API
預測持久化到 {output_annotation_dir}/truth_serum/predictions.jsonl(只追加;每位標註者在每個實例上以最後一條記錄為準)。
| 端點 | 方法 | 鑑權 | 用途 |
|---|---|---|---|
/truth_serum/api/predict | POST | session | 記錄標籤 + 預測百分比 |
/truth_serum/api/mine | GET | session | 該標註者的預測(用於恢復控制元件狀態) |
/truth_serum/dashboard | GET | admin | 判定 + 校準儀表板 |
/truth_serum/api/stats | GET | admin | 儀表板聚合資料 |
/truth_serum/api/export | GET | admin | 完整 JSON 匯出(判定 + 原始預測) |