心理測量學引擎
把項目反應理論用到標註上。每個標籤拿到的不再是一個光禿禿的多數票,而是一個後驗機率加一段置信區間,而且模型既不需要黃金標籤,也不需要 LLM。
v2.7.0 新增
Potato 可以把你的標註研究當成它本來的樣子來對待:一件測量工具。心理測量層會在標註不斷進來的過程中即時擬合一個項目反應理論(IRT)模型,同時估計每個條目真實標籤的機率、每位標註者帶標準誤的能力、每個條目的難度,以及一個按條目給出的區分度診斷量,用來標出可能的標註手冊問題。
它不需要黃金標籤,也不涉及 LLM。這個模型是 GLAD 的多分類推廣(Whitehill et al. 2009),全部資訊都從一致性的模式本身自舉出來,就像一場標準化考試不需要誰來宣佈,也能學出哪些題目難。擬合是確定性的,在標註研究這個規模上只需毫秒級時間。
配置
# Adaptive routing is opt-in via the standard assignment strategy key.
# Omit this line to keep your existing strategy and use psychometrics
# as a pure analytics layer.
assignment_strategy: psychometric

# Give items a redundancy target so early-stopped items translate into
# concrete saved judgments on the dashboard.
num_annotators_per_item: 4

psychometrics:
  enabled: true
  schema: sarcasm            # scheme to model; default: first radio/likert scheme
  refit_interval: 5          # refit after this many new labels (fits are ~ms)
  min_observations: 20       # cold-start gate before adaptive routing engages
  min_annotators_per_item: 2 # never early-stop an item below this many annotators
  confidence_threshold: 0.95 # posterior at which an item counts as resolved
  cost_per_judgment: 0.08    # optional: expresses savings in currency
discrimination_flag_threshold: -0.2 # codebook-bug flag sensitivity支援的方案是單選的分類方案:radio 和 likert(likert 的各檔被當作名義類別處理)。多選方案不建模。
帶誤差棒的標籤
匯出裡寫的不再是 sarcastic (2 of 3 votes),而是 sarcastic, p = 0.94 [0.88 – 0.97]。這個機率是模型後驗,權衡的是誰投的票,而不只是投了多少票;區間則是在能力估計上做 ±1 標準誤的敏感性帶。
到了下游,你可以用軟標籤訓練、把評測集篩成高置信度的條目,或者把低機率條目當作真正有歧義的樣本而不是噪聲。互補的做法是直接從標註者那裡收集分佈,見軟標籤標註。
標註者能力,如實呈現
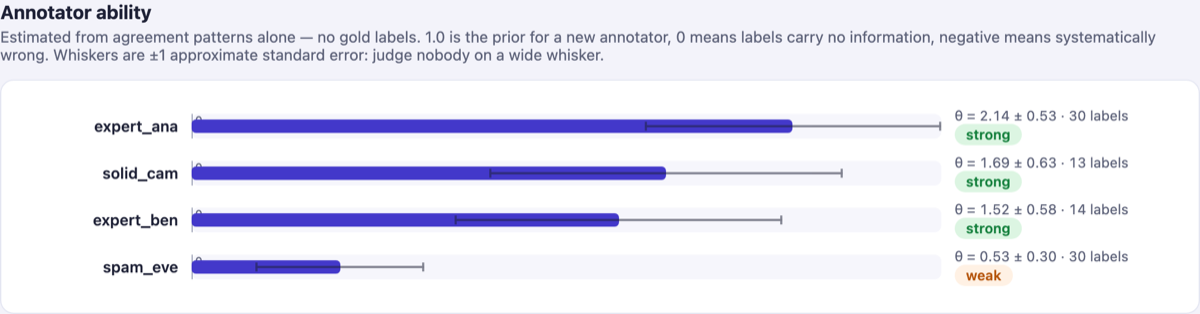
能力 θ 是從一致性模式估計出來的。1.0 是新標註者的先驗值,0 表示他們的標籤不攜帶任何資訊,負值表示系統性地做錯。每個估計值都帶標準誤:只標了 12 條的標註者,誤差線就很寬,儀表板會照實顯示。
不要根據一根很寬的誤差線做人事決定。這些標準誤是近似的(眾數處的 Fisher 資訊量),並且按其構造方式會略偏樂觀。
標註手冊問題檢測器
條目難度是和能力聯合估計出來的,但更有用的訊號是區分度:在每個條目上,標註者能力與答案正確性之間的相關。
當區分度明顯為負,也就是最好的標註者恰恰是那些不同意多數意見的人,那麼在這個條目上出問題的通常是指南本身有錯或有歧義,而不是標註者。儀表板會把這些條目集中列在“可能的標註手冊問題”下面。先把說明改好,再回頭看。團隊通常會去多人協作房間裡解決它們。
自適應路由
設了 assignment_strategy: psychometric 之後,當標註者來要活兒時,剩餘條目會按這位標註者標註這個條目所能帶來的一步期望資訊增益精確排序。不確定性高的條目優先給能力高的標註者;後驗已經超過 confidence_threshold(且至少有 min_annotators_per_item 位標註者)的條目則不再消耗預算。相對於固定的每條目 N 人設計,省下來的判斷會被統計到儀表板上,如果設了 cost_per_judgment 還會折算成錢。
兩點執行上的注意:
- 冷啟動。 在標籤數達到
min_observations之前,分配會退回隨機,因為模型需要標註者之間有重疊才能把能力和難度分開。這個階段儀表板上會顯示一個預熱進度條。 - 批次。 分配發生在使用者佇列補貨的時候。佇列越短,排序就越新鮮;每人一次取很大一批會稀釋自適應的效果。
花錢之前先做功效分析
每個標註項目都在猜“每個條目要幾位標註者”。研究設計器用一次帶隨機種子的蒙特卡洛模擬來回答:
python -m potato.psychometrics.design --items 500 --accuracy 0.75 \
--classes 3 --target-ci 0.10 --cost 0.08ann/item alpha 95% interval width majority acc judgments cost
2 0.392 [ 0.330, 0.439] 0.109 0.751 1000 80.00
3 0.388 [ 0.338, 0.431] 0.093 0.864 1500 120.00 <- recommended
推薦值是讓 Krippendorff's α 的 95% 區間窄於 --target-ci 的最小冗餘度,也就是仍能給出一個站得住腳的精確一致性估計的最便宜設計。--accuracy 這個輸入最好用一次小規模試標來測。同樣的分析也可以在儀表板上做,或者通過管理員 API(GET /psychometrics/api/design)呼叫。
你也可以用標註功效計算器在瀏覽器裡互動式地跑一遍。
端點
所有端點都需要管理員許可權(RBAC VIEW_ADMIN_DASHBOARD;除錯模式和共享的管理員 API key 也能通過)。
| 端點 | 用途 |
|---|---|
GET /psychometrics/dashboard | 即時儀表板 |
GET /psychometrics/api/stats | 儀表板聚合資料(會強制重新擬合) |
GET /psychometrics/api/export | 增強匯出:後驗、區間、能力值 |
GET /psychometrics/api/design | 功效分析 |
它和 MACE 的關係
Potato 同時還提供 MACE,用來在事後分析中估計標註者能力和預測標籤。兩者是同一支文獻裡的表親,但乾的活不一樣。
| MACE | 心理測量學 | |
|---|---|---|
| 標註者模型 | “知道”還是“猜” 的二元能力 | 帶標準誤的連續能力值 |
| 條目模型 | 無 | 難度 + 區分度(標註手冊問題標記) |
| 何時執行 | 每 N 條標註後的批次分析 | 即時,就在分配迴圈裡 |
| 是否驅動分配 | 否 | 是,通過資訊增益路由和提前停止 |
| 標籤上的不確定性 | 熵 | 後驗機率 + 敏感性區間 |
| 研究開始前的規劃 | 無 | 蒙特卡洛功效分析 |
想在任意分類方案上快速看一眼能力,用 MACE(它還支援 multiselect)。想要顧及難度、並且在研究進行當中就發揮作用的測量,用心理測量學。
問題排查
- 儀表板一直顯示“預熱中”。 模型至少需要兩種不同的標籤,以及有重疊的標註者。只有一位標註者或標籤完全一致時,擬合按定義就是退化的。加標註者,或者調低
min_observations。 - 設了
assignment_strategy: psychometric,但路由看起來是隨機的。 那是冷啟動時的回退。看一下預熱進度條和min_observations。 - 所有能力值都接近 1.0,誤差線還很寬。 重疊還不夠。隨著標註者積累起共同標註的條目,能力值會逐漸分開。
/psychometrics/...返回 404。 配置裡缺了psychometrics.enabled: true這個塊。
延伸閱讀
- Truth Serum —— 同伴預測打分,另一種不需要黃金標籤的品質訊號
- 任務分配策略
- 標註者間一致性
- 你需要多少位標註者?
- 原始碼文件