評審誰來評:把人和模型的推理並排放
LLM 評審的可信度,取決於你用來驗證它的那批人工標籤。把人的思維過程和模型的思維過程放在同一條資料上並排比較,並用帶置信區間的標籤來檢驗你的評審。
做大規模 LLM 評測的人,最後都會用 LLM 來當評審;而所有人最後都會問,這個評審能不能信。通常的答案是拿人工標籤來對照。可這個對照的品質取決於人工標籤本身,而當標註者彼此意見不一、又沒人記錄分歧有多大時,"評審與人類一致"就是一個很弱的結論。
Potato 2.7 圍繞一個想法組織起來:標註工具應當測量一個判斷是怎麼做出來的,而不只是把結果記下來。這一點對兩種評審都成立。
驗證評審時的問題出在哪
標準流程本身是合理的。你有一批大到無法手工標註的資料,於是用提示詞讓模型去打分。在信任這些分數之前,你抽一個樣本交給人工標註,再測量評審與人工之間的一致性。如果 Cohen's κ 足夠高,就可以上線。
薄弱環節在最後一步。那個 κ 是把你的評審與某一個人工標籤作比較,而這個標籤通常是兩三位標註者的多數投票結果。多數投票是一個沒有誤差範圍的點估計。無論三個人是當即一致,還是兩人在長時間爭論後壓過了第三人,它給出的"諷刺"都帶著完全相同的確定性。
所以當你報告評審與人類的一致性達到 κ = 0.71 時,你是在報告與一個自身不確定性從未被測量過的數字之間的一致性。如果人工標籤在困難樣本上接近拋硬幣,那麼這些樣本上的 κ 測的主要是噪聲,再怎麼調提示詞也推不動它。
我們此前寫過評審校準和評審與人類的對齊的機制。2.7 補上的是另一半:讓這場比較中的人類那一側也帶上自己的不確定性。
先給人工標籤配上誤差範圍
心理測量引擎會在你的人工標註上擬合一個項目反應理論模型,把每個標籤報告為帶區間的後驗(sarcastic, p = 0.94 [0.88 – 0.97]),衡量的是誰投了票,而不只是有多少人投票。
Truth Serum 再加上同伴預測評分,把那些群體雖然自信、但很可能判錯的樣本標記出來。
這樣一來,評審對比的形態就變了。你不再只能說
評審在 71% 的樣本上與多數標籤一致
而是可以說
在人工標籤明確的樣本上(p > 0.9),評審與人類後驗的一致率為 94%;在不明確的樣本上為 52%。而後者佔全部樣本的 18%。
第二種說法是可以據以行動的,第一種不是。它告訴你評審在簡單樣本上沒問題、在困難樣本上不可靠,同時告訴你困難樣本佔多大比例。它還意味著,在真正有歧義的樣本上可能根本不存在供評審去符合的真值,在那裡追求更高的 κ 就是在追噪聲。
這正是評審—人類對齊面板的用途,也是人類過程類功能和智慧體評測類功能出現在同一個版本、而不是分成兩個版本的原因。
同一條資料上的兩條思維鏈
比較的另一半是推理過程本身。
Think-Aloud 模式記錄人是如何推理到一個標籤的。標註者一邊工作一邊講述;語音轉文字在本地執行;轉寫稿逐字儲存、不做摘要,因為對出聲思考記錄做轉述,恰恰會毀掉你想採集的東西。
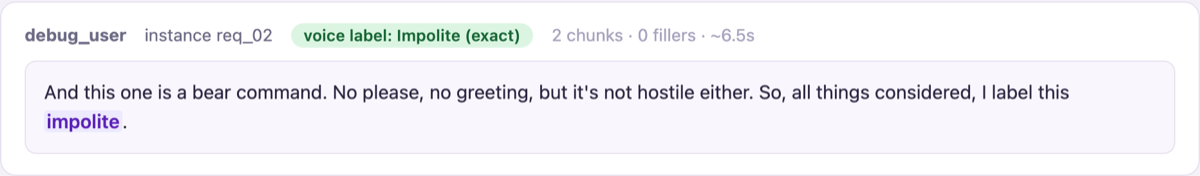 逐字記錄的人類思維鏈
過程獎勵標註記錄模型是如何推理的。模型的思維鏈被切分成步驟,每一步給出好/壞/中性的獎勵訊號,這就是過程獎勵模型的訓練訊號。
annotation_schemes:
  - annotation_type: process_reward
    name: cot_review
    description: "Rate each step of the model's reasoning."
    steps_key: reasoning_steps
同一條資料,兩條思維鏈,並排擺著。
這樣對比能看出什麼
最直接的用途是找出模型與人推理方式不同的地方。
只看最終答案的評分,無法區分"因為正確的理由得出正確答案的模型"和"因為錯誤的理由得出正確答案的模型"。在一個諷刺識別任務裡,人可能會說:"關鍵在那句 'thanks so much'。沒人會為遲到兩天這麼用力地道謝。" 而模型可能只因為文本里有一個感嘆號就落到同一個標籤上。兩者都會被判為正確,但只有一個能泛化。
標籤看不出這一點,推理過程可以,這就是把兩者都採集下來值得費這個事的原因。
第二個用途是訓練資料。人的推理與模型的推理出現分歧的那些步驟,幾乎按定義就是過程獎勵資料集中訊號最強的步驟。它們正是模型的過程出了錯、而輸出卻看不出來的地方。
一個限制。 Potato 提供兩種採集介面並把它們並排展示,但它不會自動計算人類思維鏈與模型思維鏈之間的相似度指標,我們也刻意沒有做這樣一個指標。"這兩條推理軌跡是一致的"究竟意味著什麼,仍是一個開放的研究問題;我們自己編一個數出來會比沒有數更糟,因為它看上去很權威,實際上說明不了什麼。你拿到的是成對的軌跡,指標由你來定義。
把它們串起來
2.7 中一條站得住腳的評測流水線大致是這樣的。
- 先用人工標註一個樣本,並開啟心理測量。每個標籤都會得到一個後驗和一個區間。有歧義的樣本會被識別為有歧義,而不是被悄悄誤標。
- 執行 Truth Serum,抓出那些群體自信但很可能判錯的樣本。
- 修訂標註指南,重點是碼本缺陷檢測器標出負區分度的地方;最好在規範化協作房間裡做,這樣你能一邊收斂一邊看著一致性變化。
- 用這批標籤校準評審,並按人類置信度分層報告對齊情況,而不是給出單一的數字。
- 在評審與人類判斷不一致的樣本上,檢查推理而不只是結論。
每一步都用 YAML 配置、自託管、免費。第 1 到 3 步完全不需要 LLM。
這些都不足以讓一個 LLM 評審本身變得可信。它們讓可信這個主張變得可以核驗:一個帶區間的結論,對照同樣帶區間的人工標籤,落在難度可被描述的樣本上。這個標準比"我們的評審與人類價值觀對齊"要低,但更有用。
延伸閱讀
- 評審—人類對齊與評審校準
- 帶誤差範圍的標籤——支撐這一切的 IRT 層
- 沒有黃金標籤時的品質控制
- 過程獎勵模型
- Think-Aloud 模式
- Potato 2.7——完整版本說明