評判員 ↔ 人工標註的一致性
衡量 LLM 評判員與你的人工黃金標籤的契合程度。Potato 在已標註的實例上執行評判員,計算 Cohen's kappa、混淆矩陣和分歧清單,並在你最佳化評分細則時持續跟蹤一致性。
評判員一致性用於衡量並調校 LLM 評判員與你的人工黃金標籤之間的契合程度。 Potato 在標註員已經標註過的實例上執行一個可配置的 LLM-as-a-judge,計算 Cohen's κ、混淆矩陣和分歧清單,並在你修改評判細則時跟蹤 κ 的變化。開啟內聯模式後,標註過程中評判員的結論會顯示在人工標籤旁邊,並附帶即時的 κ。
這就是 LangSmith Align Evals、Evidently 等工具所採用的標準「把評判員對齊到大約 100–200 個黃金標籤」迴圈:收集人工標籤、執行評判員、檢查分歧、最佳化細則,並反覆執行直到一致性足夠高。
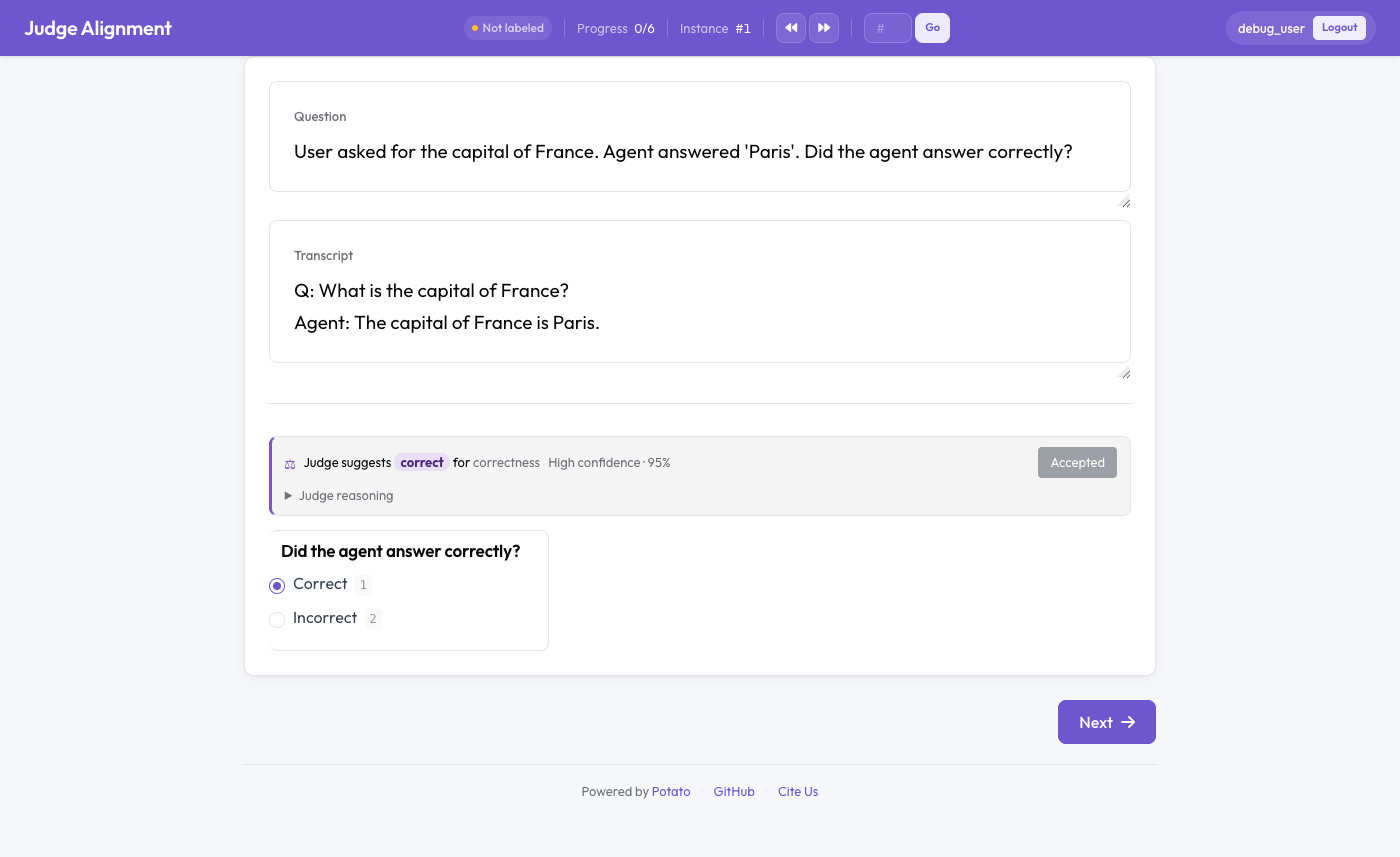 LLM 評判員的結論顯示在人工標註旁邊,並附帶即時 kappa
配置
# The judge uses Potato's standard AI endpoint machinery.
ai_support:
  enabled: true
  endpoint_type: "ollama"        # ollama (local) | openai | anthropic | vllm | ...
  ai_config:
    model: "llama3.2"
    temperature: 0.0
    # openai/anthropic: add api_key: "<key>"

judge_alignment:
  enabled: true
  schemas:
    correctness:                 # per annotation-scheme rubric (editable)
      rubric: >
        Label 'correct' only if the agent's answer is factually right and fully
        satisfies the request; otherwise 'incorrect'.
  few_shot:
    enabled: false               # seed the judge prompt with gold examples
    max_examples: 4              # drawn from high-agreement human labels
    min_agreement: 0.8
  inline:
    enabled: true                # show the judge verdict beside the human label
    schemas: [correctness]
compute_on_demand: false # call the judge live when no cached verdict exists適用範圍是單選類別方案(radio、select、likert)。如果設定了 judge_alignment.schemas,則只會評判這些方案;否則會評判所有類別方案。
執行評判員
從管理員 API 執行評判員。預測結果會按提示詞版本快取,因此重複執行的成本很低:
# Generate or refresh judge verdicts over human-annotated instances
curl -X POST localhost:8000/admin/api/judge-alignment/run \
  -H "X-API-Key: <admin-key>" \
  -H "Content-Type: application/json" \
  -d '{"max_per_schema": 200}'
要進行校準,可以傳入經過修改的評判細則。這會建立一個新的提示詞版本,從而讓你能夠在不同輪次之間對比 κ:
curl -X POST localhost:8000/admin/api/judge-alignment/run \
  -H "X-API-Key: <admin-key>" -H "Content-Type: application/json" \
  -d '{"rubrics": {"correctness": "Stricter rubric text..."}}'
一致性報告
GET /admin/judge-alignment                      # JSON
GET /admin/judge-alignment?format=html          # rendered page
GET /admin/judge-alignment?prompt_version=v_abc123
請傳送 X-API-Key 請求頭。對於每個方案,報告會顯示:
- Cohen's κ,附帶 Landis–Koch 解釋、一致率以及參與對比的實例數量。
- 一個混淆矩陣(行是人工黃金標籤,列是評判員)。
- 一個分歧表,包含實例、人工標籤、評判員標籤、置信度以及評判員的推理過程。
- 提示詞版本歷史,顯示每個版本的平均 κ,從而讓校準進展一目瞭然。
人工黃金標籤是各標註員對每個實例投票的多數結果。
內聯模式
啟用 inline.enabled 後,每個標註頁面都會顯示該實例對應的評判員快取結論——包括其標籤、置信度和可展開的推理過程——同時顯示該任務的即時 κ。點選「接受」會自動填入匹配的選項。每次人工儲存都會記錄一次人工↔評判員的對比,從而納入即時一致性的計算。設定 compute_on_demand: true 可在沒有快取結論時即時呼叫評判員;否則建議預先批次執行,這樣速度更快。
注意事項與限制
- 本版本的校準是手動進行的:修改細則並重新執行。自動化的提示詞最佳化不在範圍之內。
- 適用範圍是單選類別方案。跨度(span)和自由文本的評判屬於未來工作。
- 在大約 100–200 個已標註實例的集中黃金集上執行評判員,可獲得更穩定的 κ。
相關內容
如需瞭解實現細節,請參閱源文件。