不用黃金標籤的品質控制
黃金標準造起來貴、會洩露,而且只能測到你當初想得到要埋的那些條目。另有兩條路,同伴預測打分和反事實邊界探針,一個埋點都不用,就能揪出不認真的標註者和有問題的指南。
檢查標註品質的標準做法,是埋進一些你早就知道答案的條目,看誰做錯。這招管用,但造起來貴,只能測到你當初想得到要埋的那些情形,而且老練的標註者會學會認出埋點。有兩種技術能讓你在完全沒有黃金條目的情況下拿到品質訊號:同伴預測打分,讓標註者預測別人會怎麼答;以及反事實探查,問一個標籤在小幅改動之後還成不成立。 這兩樣 Potato 都有,分別叫 Truth Serum 和邊界實驗室。
黃金標準與注意力檢查是“我怎麼知道標註者有沒有在認真做”這個問題的預設答案,它們也配得上這個位置。但它們有三項實打實的成本。
你得先把它們造出來,這意味著專家的時間要花在標註一些你本來就懂的條目上。它們只覆蓋你預想到的失效模式。而在任何跑得久一點的任務上,標註者最終都會認出它們。一條被反覆使用的黃金條目,就是一條不再測量任何東西的黃金條目。
下面兩種技術把這三點都繞開了,而且都不需要 LLM。
同伴預測:問問別人會怎麼答
標註者選完標籤之後,Truth Serum 會再問一件事:
你選的是 Sarcastic。你覺得有多大比例的其他標註者會和你選一樣的標籤?
一個滑塊,一次點選。就這麼一個額外的數字,乾的活出人意料地多。
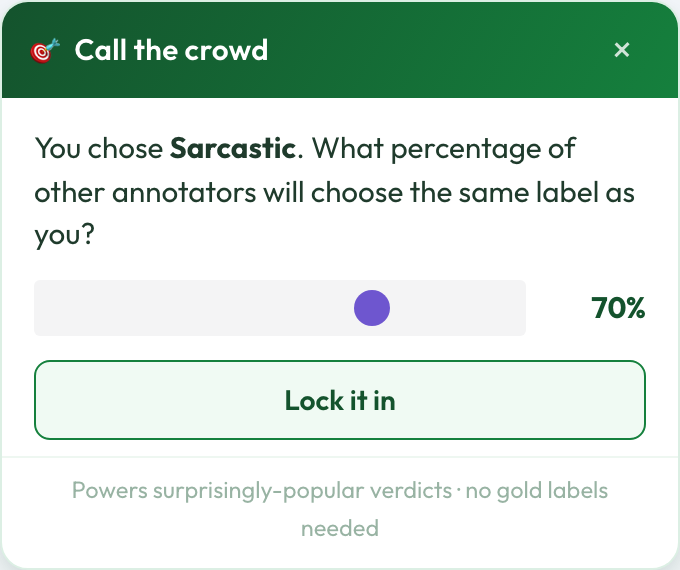 Truth Serum 的預測卡片
這個預測為什麼有資訊量
方法來自意外流行(surprisingly popular)原則(Prelec、Seung 與 McCoy 2017,Nature;建立在 Prelec 的貝葉斯真話血清之上,2004)。它的主張是:對真相的最佳估計不是最流行的那個答案,而是比人們預測的還要流行的那個答案。
推理是這樣的。持有正確少數派觀點的人,通常知道自己是少數派。他們看得出為什麼大多數人會答得不一樣,你讓他們預測的時候他們也會照實說。反過來,抱著某種常見誤解的人,往往會假定所有人都跟自己想的一樣。所以當一個答案的實際流行度超過了它自己被預測的流行度,這個差值就是證據:選它的人知道一些大眾不知道的東西。
多數投票失效得最厲害的地方,恰恰是自信的多數人錯了、知情的少數人對了。意外流行打分就是為這種情形造的。
truth_serum:
  enabled: true
  schema: sarcasm
  min_annotators: 5
據我們所知,Potato 是第一個提供同伴預測打分的標註工具。
你能拿到什麼
三樣東西,沒有一樣需要標準答案。
一份“多數可能出錯的地方”佇列。 所有意外流行標籤與多數標籤不一致的條目。這些才是值得專家花時間看的條目,而且數量通常遠比你擔心的少。
每位標註者的校準分數。 每個人預測的一致度,和他們實際拿到的一致度差了多遠。一個人如果總預測 90% 的其他人會同意自己,實際卻總只拿到 55%,這就透露了他的自我認知水平。而你不用埋任何東西就學到了這一點。
SP 對齊度。 每位標註者的標籤與意外流行判定一致的頻率,這是“是否真的知情”而非“是否只是隨大流”的一個粗略代理指標。
引用它之前先看一條提醒:這是簡化的自答預測變體,每位標註者只預測自己所選標籤的流行度,而不是給出所有標籤上的完整分佈。另外 min_annotators: 3 是下限,不是推薦值。到五個以上,判定才不再那麼嘈雜。
反事實探針:問這個標籤扛不扛得住一次改動
Truth Serum 找的是多數人做錯的條目。邊界實驗室找的是另一樣東西:你的標註手冊在哪裡有歧義,以及哪些標註者其實沒在讀。
標籤一提交,Potato 就展示對文本的一處最小改動,問這個標籤還成不成立。
你說的是 Polite。這處改動之後它還成立嗎?
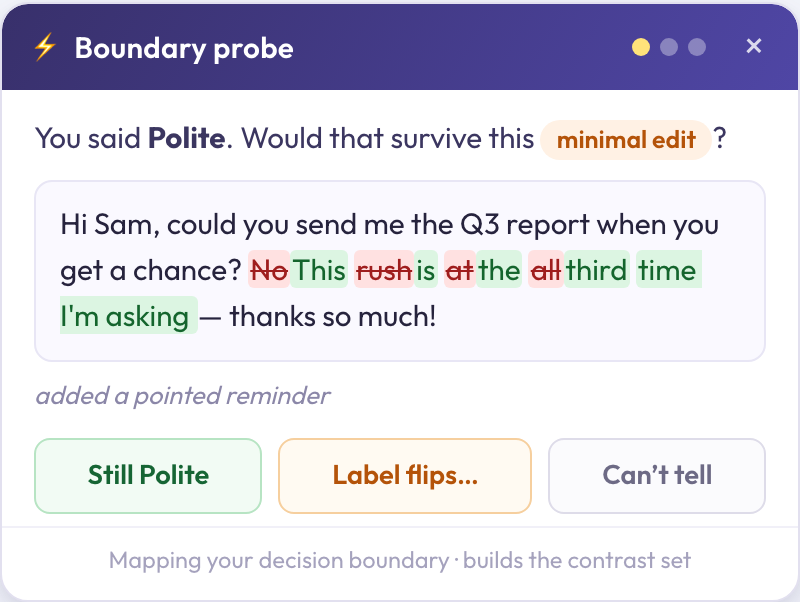 一個邊界實驗室探針
回答只需一次點選。但因為你問了這一句,普通的標註流程現在能產出三樣純標籤匯出拿不到的東西。
對比集,順帶就有了
每個回答過的探針都是一對帶標籤的 (原文, 反事實) 資料。這就是對比集:一種被證明能提升模型魯棒性的反事實增強資料(Gardner et al. 2020,Evaluating Models' Local Decision Boundaries via Contrast Sets;Kaushik et al. 2020)。
構建對比集通常是一項單獨且昂貴的標註工作。在這裡,它從你本來就要做的標註裡掉出來。
boundary_probing:
  enabled: true
  schema: politeness
  probes_per_item: 3
  include_invariance: true
  sources: [precomputed, llm, rules]
sources 列表是一條回退鏈。你可以隨資料提供人工整理好的反事實樣本,用 LLM 生成它們,或者讓基於規則的那一層用否定翻轉、程度詞替換、禮貌標記之類的詞彙變換造出來。最後這一層就是邊界實驗室在完全不配置 LLM 的情況下也能工作的原因,也是這個功能在沒人設 API key 時會優雅降級而不是直接罷工的原因。
無形的品質控制
有些探針是不變性探針:保持語義的改寫。“會前把幻燈片發給我”(Send me the slides before the meeting)變成“在會議開始前,把幻燈片發給我”(Before the meeting, send me the slides)。
一致的標註者絕不會在這類探針上翻轉。翻轉的人要麼沒在仔細讀,要麼對這個標籤的含義沒有穩定的理解。不管是哪種你都想知道,而你不用埋一條假條目就知道了。這個探針和普通工作完全無法區分,因為它就是普通工作。
儀表板會把不變性探針保持率低於 60% 的標註者標出來。
邊界理由
標籤真的發生翻轉時,標註者要說出是什麼越過了那條線:“please 讓這條命令變得柔和了。”這些理由累積起來,就成了一張地圖,精確指出你的指南在哪裡說得不夠清楚,而這正是寫出更好指南的輸入。
儀表板還會報告按標籤的邊界敏感度:針對每個標籤的最小改動中,實際發生翻轉的比例。翻轉率 90% 的標籤處在刀刃上,多半需要一個更清楚的定義。10% 的標籤則很穩健。
該用哪一個?
它們回答的是不同的問題,而且可以疊加使用。
| Truth Serum | 邊界實驗室 | |
|---|---|---|
| 找出什麼 | 多數人可能做錯的條目 | 有歧義的指南;不認真的標註者 |
| 標註者的成本 | 每條一個滑塊 | 每個探針一次點選 |
| 產出什麼 | 更好的判定、校準分數 | 對比集、邊界理由 |
| 需要 LLM 嗎 | 不需要 | 不需要(有基於規則的層) |
如果你擔心的是*“在難題上共識標籤可能是錯的”,先上 Truth Serum。如果是“我覺得我的標註手冊不夠精確,也不確定大家都在認真讀”*,先上邊界實驗室。
這兩者都不能替代心理測量學,後者告訴你每個標籤該有多少信心、哪些標註者該加多少權重。三者合在一起,你得到的研究是品質被持續測量而不是抽查的,而且所有測量都不依賴一份你得先造出來的標準答案。
延伸閱讀
- Truth Serum 與邊界實驗室 —— 完整配置
- 帶誤差棒的標籤 —— IRT 後驗與標註手冊問題檢測器
- 黃金標準與注意力檢查 —— 經典做法,以及它什麼時候仍然是對的選擇
- 品質控制
- 撰寫有效的標註指南