帶誤差棒的標籤:把項目反應理論用到標註上
多數投票把標註者告訴你的東西丟掉了大半。項目反應理論給每個標籤一個後驗機率和一段置信區間,估計標註者能力和條目難度,還能找出壞掉的標註手冊條目,既不需要黃金標籤,也不需要 LLM。
多數投票把每位標註者都當成同樣可靠,把每個條目都當成同樣難,而且它報出來的是一個計數而不是一個機率。項目反應理論(IRT)把這兩條假設都扔掉:它只從一致性的模式本身估計每位標註者的能力和每個條目的難度,然後把每個標籤報成一個帶置信區間的後驗機率。它不需要黃金標籤,也不需要 LLM。 在 Potato 裡這就是心理測量學引擎,而且它隨著標註進來即時執行。
三位標註者標了同一個條目。兩個說 sarcastic,一個說 sincere。多數投票判它是 sarcastic,然後翻篇,而你的資料集記下這個結果時的置信度,跟三個人全都一致的條目一模一樣。
這是在扔掉資訊。那個持異議的人可能是你最可靠的標註者。這個條目也可能是所有人都覺得難的。這兩件事在計數里都活不下來。
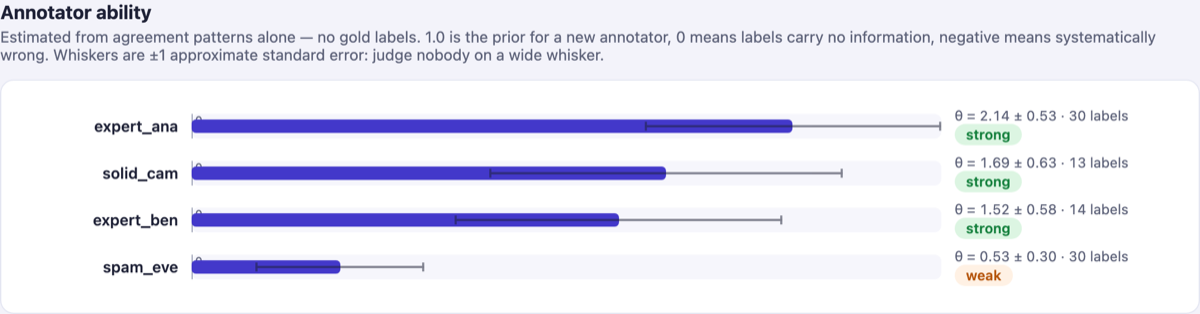 帶置信區間的標註者能力
什麼是項目反應理論?
項目反應理論來自心理測量學,最初是為標準化考試打分而造的。它的洞察是,一場考試同時告訴你兩件事:每個考生有多強,以及每道題有多難。你可以只憑作答模式把兩者聯合估計出來,因為它們互相約束。厲害的學生做錯的題就是難題。能做對難題的學生就是厲害的學生。
標註的形狀是一樣的。標註者是考生,條目是題目,而沒有人手裡有標準答案。
Potato 擬合的是 GLAD 的多分類推廣(Whitehill et al. 2009),它同時估計三樣東西:
- 每個條目的真實標籤,形式是一個機率分佈
- 每位標註者的能力(θ),帶標準誤
- 每個條目的難度,以及一個按條目給出的區分度診斷量
擬合是確定性的,在標註研究這個規模上只需毫秒級時間,所以它可以持續執行,而不必作為事後的批處理作業。
開啟它
psychometrics:
  enabled: true
  schema: sarcasm
  confidence_threshold: 0.95
  min_annotators_per_item: 2
光是這樣就能給你分析層。你的匯出會從這樣:
sarcastic (2 of 3 votes)
變成這樣:
sarcastic p = 0.94 [0.88 – 0.97]
這個機率是模型後驗,它權衡的是誰投的票,而不只是投了多少票。區間則是在能力估計上的一條敏感性帶。
到了下游,這個數字很值。你可以用軟標籤訓練,把評測集篩成置信度高於某個下限的條目,或者把低機率條目當成真正有歧義的樣本,而不是悄悄被標錯的樣本。分歧不再是需要被平均掉的噪聲,這一點值得和分歧是訊號,不是噪聲一起讀。
標註者能力,如實呈現
能力是從一致性模式估計出來的。1.0 是新標註者的先驗值,0 表示這位標註者的標籤不攜帶任何資訊,負值表示系統性地做錯。
每個估計值都帶標準誤,而這件事比點估計本身更重要。只標了 12 條的標註者,誤差線很寬,儀表板也就畫得很寬。不要根據一根很寬的誤差線做人事決定。 這些標準誤是近似的(眾數處的 Fisher 資訊量),並且按其構造方式會略偏樂觀。它們存在是為了攔住你過度解讀一個數字,而不是為了給開除誰背書。
如果你只想在任意分類方案上快速看一眼能力,MACE 是它那位年長的表親,至今仍是一個好工具。區別在於 MACE 是批次分析,而心理測量學坐在分配迴圈裡,在研究進行當中就對它起作用。
標註手冊問題檢測器
這是讓人意外的那部分。
除了難度,模型還估計區分度:在某個給定條目上,標註者能力與“同意共識”之間是否相關。正常情況下是相關的。能力強的標註者更常和最終答案一致,這大致就是“能力強”的意思。
當區分度強烈地轉為負,就說明有問題了。你最好的那批標註者在這個條目上系統性地不同意多數意見。最可能的解釋不是他們突然變差了,而是指南對這種情形有歧義或者乾脆寫錯了,而認真的標註者正是注意到這一點的人。
Potato 把這些條目集中列在“可能的標註手冊問題”下面。它們通常是整個研究裡價值最高的條目,因為每一條都是工具本身的缺陷,而不是某個人的缺陷。先把指南改好,再重新標。標準對齊房間是團隊一起把它們過一遍的好地方。
把標註預算花在能買到東西的地方
固定冗餘度,也就是“永遠每條三位標註者”的規矩,在所有人都同意的條目和把團隊劈成兩半的條目上花的錢一樣多。這是反的。
assignment_strategy: psychometric
num_annotators_per_item: 4
psychometrics:
  enabled: true
  confidence_threshold: 0.95
  cost_per_judgment: 0.08
這樣一來,當標註者來要活兒時,Potato 會按這位具體標註者標註這個具體條目的期望資訊增益,給剩餘條目排序。後驗已經越過 confidence_threshold 的條目乾脆不再發出去。儀表板會統計你因此不必購買的判斷數,如果設了 cost_per_judgment 還會折算成錢。
開啟它之前有兩點值得知道:
- 冷啟動。 在標籤數夠多之前,分配會退回隨機。模型需要標註者之間有重疊才能把能力和難度分開,它也不會假裝自己能。這個階段儀表板上顯示的是一個預熱進度條。
- 批次。 佇列越短,排序就越新鮮。一次給每位標註者塞 200 個條目會稀釋自適應的效果,因為排序是在那些標籤裡大部分還不存在的時候算出來的。
花錢之前先定好冗餘度
每個項目都在猜的問題是:每個條目需要幾位標註者。研究設計器不猜,而是用一次蒙特卡洛模擬來回答:
python -m potato.psychometrics.design --items 500 --accuracy 0.75 \
--classes 3 --target-ci 0.10 --cost 0.08ann/item alpha 95% interval width majority acc judgments cost
2 0.392 [ 0.330, 0.439] 0.109 0.751 1000 80.00
3 0.388 [ 0.338, 0.431] 0.093 0.864 1500 120.00 <- recommended
推薦值是讓 Krippendorff's α 的 95% 區間仍窄於你目標的最便宜的冗餘度。--accuracy 這個輸入應該用一次小規模試標來測,而不是靠猜。
同樣的計算也能在瀏覽器裡跑,如果你不想為了回答這個問題而裝任何東西的話。
它做不到什麼
IRT 不是魔法。幾條實話實說的限制:
- 它建模的是單選的分類方案,
radio和likert。多選不建模。 - 它需要標註者之間有重疊。如果每個條目都由不同的人來標,就沒有一致性結構可學,模型會告訴你它還在預熱。
- 只有一位標註者,或者到處都是完全一致的標籤時,擬合按設計就是退化的。這是正確行為,不是 bug。
它給你的回報是:一個每個標籤都自帶不確定性的資料集,一支你瞭解的標註者隊伍,以及一份你的標註手冊在哪裡壞掉的清單。
延伸閱讀
- 心理測量學引擎 —— 完整配置參考
- Truth Serum —— 另一種不用黃金標籤給品質打分的辦法
- 你需要多少位標註者?
- 聚合眾包標籤 —— Dawid–Skene 及其親戚
- 標註者間一致性