你能信任你的 LLM 評審嗎?把 LLM-as-Judge 與人類校準對齊
用 LLM 給模型輸出打分很容易,難的是判斷它是否可信。本文帶你走一遍 Potato 2.6 的盲測人類校準流程:k 次取樣投票、Cohen 與 Fleiss kappa,以及期望校準誤差。
用大型語言模型給其他模型的輸出打分,已經成了評測中的預設做法。你寫一份評分細則,讓 GPT-4o 或 Claude 給上千條回覆打分,然後讀出一個準確率數字。這種方式快、便宜,而且能擴充套件到任何人工團隊都無法手動標註的規模。
但它也悄悄假設了你最需要核實的那件事:評審和人類意見一致。一個把 LLM 當評審的系統,如果自信地犯錯,就會產出一份看起來乾淨、實則建在流沙之上的排行榜。在你信任評審的裁決之前,你必須先衡量它在多大程度上跟得上人類的判斷。這個衡量步驟就是校準,而 Potato 2.6 為此加入了一套工作流。
本文介紹 Judge Calibration(評審校準):它如何對模型取樣、如何讓人類環節保持客觀,以及報告到底告訴了你什麼。參考文件列出了完整的選項清單。
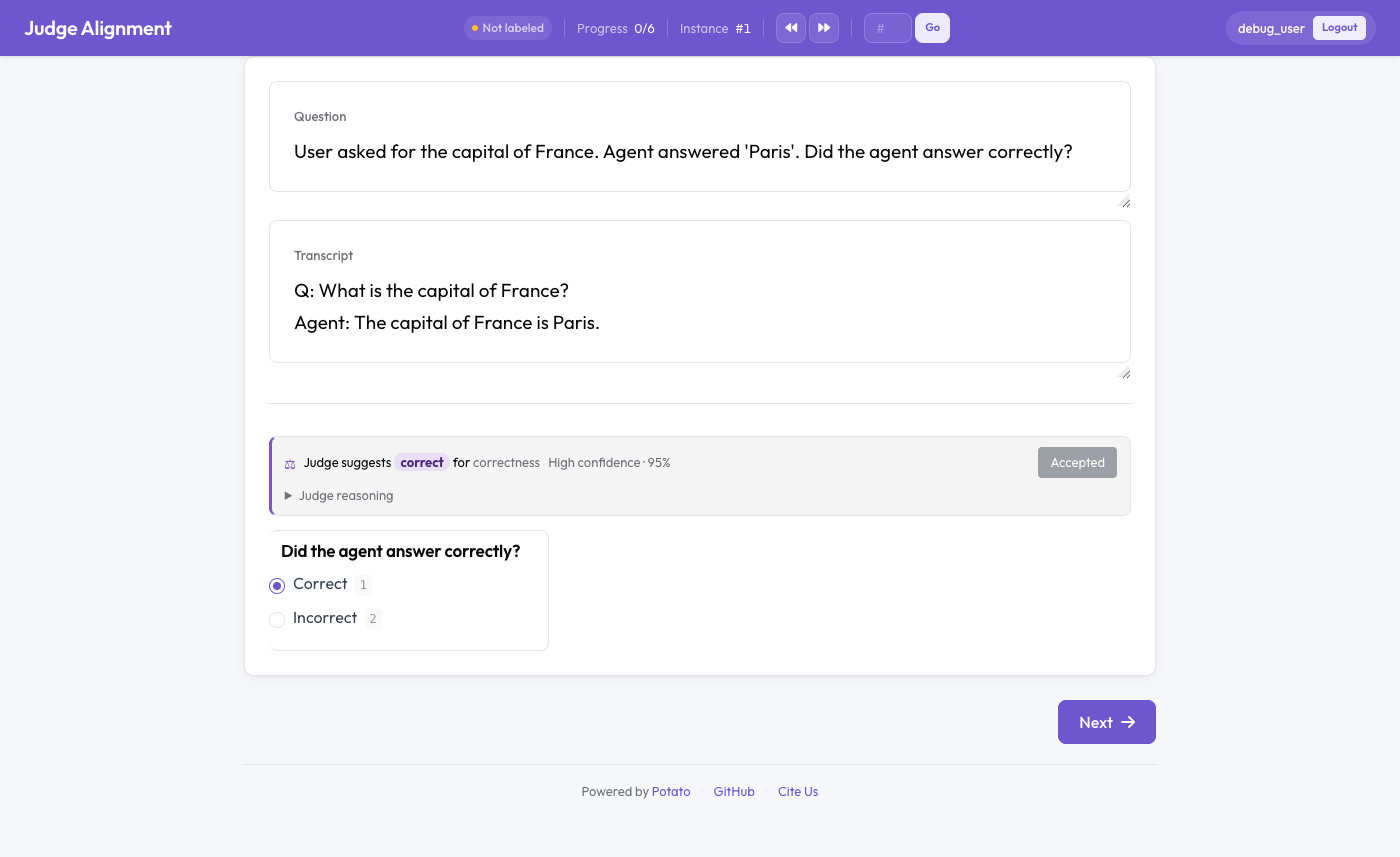 Potato 中的內聯評審校準
問題的形態
評審可能以兩種不同的方式出錯,而你想把這兩種都抓住。
第一種是分歧:評審把一個細心的人會判為"錯誤"的東西判為"正確"。這正是準確率和一致性指標所衡量的。
第二種是置信度失真:評審說自己有 95% 的把握,實際上只有 60% 的時候是對的。一個評審可以有不錯的準確率,卻嚴重失校;一旦你開始用它的置信度來分配工作或設定閾值,這個問題就會立刻顯現。這正是校準誤差所衡量的。
Potato 的校準流程就是為了同時暴露這兩種問題而設計的。
工作原理
整個工作流以一個簡短的狀態機執行:
 The five states of a calibration run
 Accurate is not the same as calibrated
生成階段(Generating)。 每個模型對每個條目被查詢 k 次。這 k 個樣本中出現最多的標籤是模型的預測,而與該標籤一致的樣本比例就是模型的置信度。取樣 k 次而非一次,正是讓你獲得一個經驗性的置信度訊號,而不是模型對自身臆造出來的一個數字。這些結果會進入一個專門的儲存區,永遠不會寫入標註資料。
人類校準(Human calibration)。 Potato 抽取條目的隨機樣本或分層樣本,並將它們分配給一名或多名人類,由他們通過正常的標註介面進行標註,全程看不到模型的答案。
報告(Report)。 指標在模型標註和人類標註的重疊部分上計算,然後寫入磁碟。
這裡的盲測是關鍵所在。由於模型標註存放在獨立的儲存區,永遠不會注入到介面中,人類即便無意之間也不會被它們錨定。盲測是結構性的,而不是靠請標註者"別看"來實現的。
 Potato 如何用盲測人類標註來校準評審
配置
一次評審校準就是一個配置塊。你寫好評審提示詞、列出模型,並設定每個模型取樣多少次:
judge_calibration:
  enabled: true
  prompt: |                       # supports {text}, {labels}, {description}
    You are an impartial expert annotator. Classify the sentiment as exactly
    one of: positive, negative, neutral.
  models:
    - endpoint_type: openai        # openai | anthropic | ollama | vllm | gemini | ...
      model: gpt-4o-mini
      api_key: ${OPENAI_API_KEY}
      temperature: 0.7             # must be > 0 so the k samples vary
    - endpoint_type: ollama
      model: llama3.1:8b
      base_url: http://localhost:11434
      temperature: 0.7
  k_samples: 5                     # samples per model per item
  max_items: 1000                  # cap on items the LLMs label (null = all)
  sampling:
    strategy: stratified           # random | stratified | all
    sample_size: 200               # how many items humans blind-label
    seed: 42
  human:
    num_raters: 1                  # 1 = solo researcher; N adds human-human IAA
    gold: single                   # single | majority
  schemas: [sentiment]
  output:
    dir: judge_calibration_output
Warning: 請設定
temperature > 0。當k_samples > 1而溫度為 0 時,所有樣本完全相同,置信度會被固定在 1.0,校準報告也就毫無意義。Potato 在檢測到這種組合時會發出啟動警告。
你可以列出不止一個模型並把它們並排校準,這是在廉價的本地評審和昂貴的託管評審之間做選擇的自然方式。
沒有 API key 時如何試用
捆綁的示例使用本地的 Ollama 模型,所以你可以完全離線地跑通整個流程。啟動 Ollama、拉取模型,然後執行:
ollama pull llama3.2:3b
python potato/flask_server.py start examples/ai-assisted/judge-calibration/config.yaml -p 8000 --debug
開啟 http://localhost:8000/judge_calibration/admin 進行配置和執行,在 /annotate 處盲測標註樣本,然後構建報告並在 /judge_calibration/report 閱讀它。
報告告訴你什麼
這份報告的目的是用你能寫進方法部分的數字來回答"我該信任這個評審嗎?":
- 每個模型相對人類金標準的準確率、精確率、召回率、F1。
- Cohen's κ,分別按 人↔模型、模型↔模型、人↔人 三類配對拆分,讓你看清評審與人類的一致程度是否能趕上人類彼此之間的一致程度。
- 跨所有評分者的 Fleiss' κ 與 Krippendorff's α。
- 期望校準誤差(ECE)、可靠性分箱,以及 Brier 分數:針對置信度失真這一失效模式的答案。
- 每個模型的混淆矩陣,它通常道出了真正的故事:一個在簡單類別上表現良好、卻在某個困難區分上崩潰的評審。
所有指標都在重疊部分上計算:模型和人類都標註過的條目,並限定在校準樣本之內。輸出落在 output.dir 下,包括 llm_labels.jsonl、report.json,以及一份可讀的 report.html。
它能處理什麼
校準在大多數評審使用的分類型方案上得到完全支援,並延伸到更難的類型:
| 類型 | 狀態 | 指標 |
|---|---|---|
radio / select | 已支援 | 準確率、P/R/F1、Cohen/Fleiss κ、Krippendorff α、ECE、混淆矩陣 |
likert | 已支援 | 以上各項,外加 MAE 和序數 Krippendorff α |
multiselect | 已支援 | 各標籤 P/R/F1、平均 Jaccard、精確匹配準確率、校準 |
span | 實驗性 | IoU 匹配的 P/R/F1、平均 IoU、span-F1、span 級校準 |
Span 校準會把評審在 k 個樣本中給出的字元偏移區間聚類,並按交併比(intersection-over-union)與金標準匹配;其數值應視為方向性參考,而非精確結果。
校準與對齊之別
Potato 還附帶了第二個與本文相關、容易混淆的工作流。Judge Alignment(評審對齊)將單個評審與一份已有的人類金標準集校準,在標註過程中內聯展示其裁決,並圍繞著不斷迭代評分細則、直到一致性上升而構建。
經驗法則是:當你正在審查候選評審、想要一個盲測的經驗置信度數字時,選校準;當你已經確定了某一個評審、想針對固定的金標準集調整其評分細則時,選對齊。兩者在閉環(Closing the Loop)中一併介紹。
LLM 評審不會消失;要評測的東西太多,能手動評測的人太少。校準的意義不是用人類取代評審,而是用一個數字精確地知道:在需要人類介入之前,評審到底能被信任到什麼程度。
Judge Calibration 文件涵蓋了每一個選項,標註者間一致性指南則深入解釋了 kappa 和 alpha 這些指標。