標註 ASR 轉寫稿:一個完整實例
從一個 Whisper 輸出目錄一路走到帶標籤的說話人話輪:怎麼選標註單元、怎麼處理說話人分離、怎麼寫配置、怎麼把任務跑起來,以及怎麼在匯出時保住時間對齊。
這篇文章把一個項目從頭走到尾:40 段錄下來的研究訪談,已經用 Whisper 轉寫過,需要按主題編碼,還要標出誰說了什麼。它是那兩篇參考指南的具體版本,每個決定都真的做了,而不是描述了一遍。
如果你要的是逐格式的細節,那部分在轉寫格式裡。
 檢查你保留了什麼、決定誰來標說話人、寫好配置、帶著時間戳匯出
第 0 步:先看看你手裡到底有什麼
別的都先放一邊,先弄清楚這個目錄裡是什麼。這一步花十秒鐘,能省你一天:
potato transcripts ./whisper_out --dry-runScanned 40 file(s):
interview_01.json Whisper JSON 42 turns 891.4s undiarized
interview_02.json Whisper JSON 51 turns 1120.8s undiarized
interview_03.txt plain text 1 turns 0.0s undiarized
...
40 item(s), 1683 turn(s).
從裡面能讀出兩件事。所有檔案都沒做說話人分離,所以這份語料裡沒有任何東西知道說話的是誰。另外 interview_03.txt 被當成了一個時長為零的話輪,因為 Whisper 出來的 .txt 裡只有文字,別的什麼都沒有。裡面根本沒有時間資訊可以找回來。
第三個檔案要麼得把對應的 .json 找出來,要麼把音訊重跑一遍。下游沒有任何環節能補救它。
第 1 步:先定標註單元,再定標籤
單元這個問題對你的一致性數字的影響,比標籤集大得多。
Whisper 的分段大致是話語級的,它在停頓處斷開,而不是在任何語法邊界上斷開。對訪談編碼來說這通常就是對的單元:受訪者的一次回答會分成好幾段進來,把每段單獨編碼,得到的記錄比把整段回答一起編碼要細。
會出問題的是影片平臺的自動字幕,那裡的字幕行邊界落在字幕框填滿的地方。讓標註者在這樣的字幕行上給“每個句子”打分,產生的分歧是關於句子邊界在哪,而不是關於你想測的那個東西。如果這就是你的輸入,請看如何標註 YouTube 字幕。
這裡的分段可以直接用,所以單元就是話輪。
第 2 步:決定由誰來分配說話人
Whisper 不做說話人分離。有三個選項,而且這是一個真正的決定,不是走過場:
用 WhisperX 重跑一遍。 自動、快,但在重疊說話上錯得夠頻繁,反正總得有人來核一遍。
whisperx interview_01.mp3 --model medium --diarize --output_format json用一個開了說話人分離的雲端 API。 Deepgram 加 diarize=true、AssemblyAI 加 speaker_labels、AWS Transcribe,或者 Rev.ai。這四種 Potato 都能原生讀。
讓標註者一邊聽一邊分配說話人。 對 40 段雙人訪談來說,我們會選這個。兩個角色分明的說話人對人來說是最容易的情形,對模型卻不一定,而且標註者本來就在聽音訊。
我們選第三個。沒做說話人分離的話輪會顯示為 Unassigned 並帶一個選擇器,分配結果和標註一起儲存。
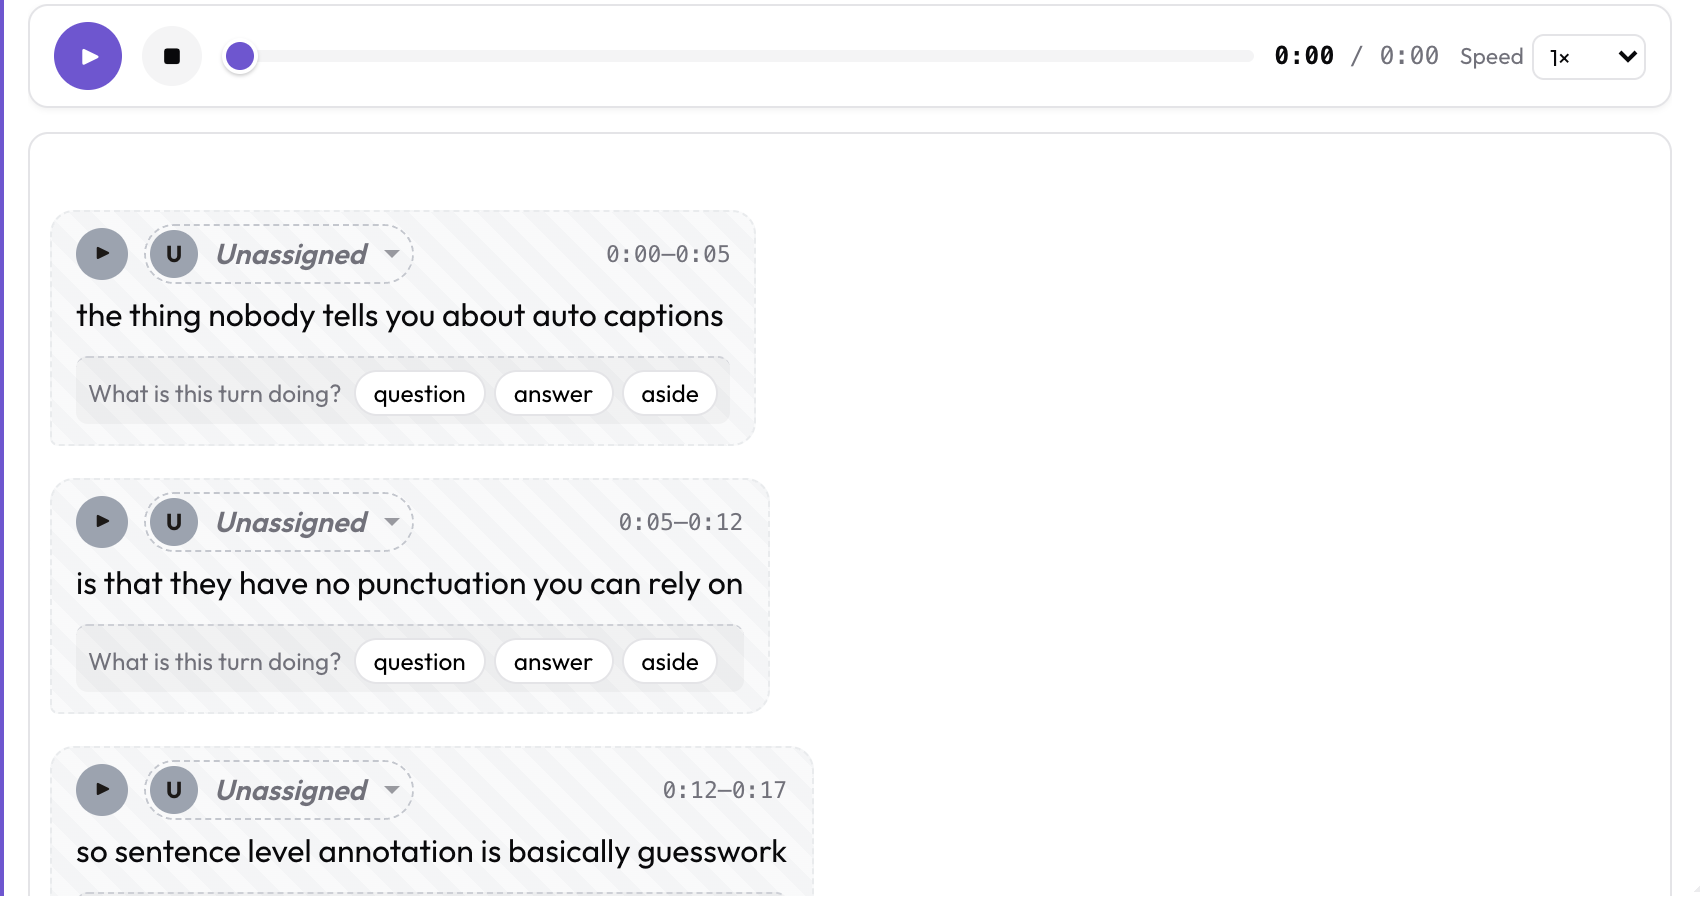 未做說話人分離的話輪以 Unassigned 到達,每條上都有一個選擇器
第 3 步:造資料檔案
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.json轉寫稿按檔名主幹和音訊配對,所以 interview_01.json 會找到 interview_01.mp3。Whisper 那種重複的 interview_01.mp3.json 命名也處理了,條目 id 出來就是 interview_01。
結果是:
{
  "id": "interview_01",
  "conversation": {
    "audio": "audio/interview_01.mp3",
    "turns": [
      {"turn_id": "t0", "speaker": null, "start": 0.0, "end": 6.5,
       "text": "So I want to start with how the team was structured."}
    ]
  }
}
如果你更願意把轉寫稿保持成檔案,這一步完全可以跳過。資料檔案可以直接指向它們,Potato 會在渲染時讀取並歸一化:
{"id": "interview_01", "conversation": {"audio": "audio/interview_01.mp3",
                                        "transcript": "whisper_out/interview_01.json"}}
第 4 步:寫配置
annotation_task_name: "Interview Coding"
task_dir: .
data_files:
  - data/interviews.json

item_properties:
  id_key: id
  text_key: conversation

instance_display:
  fields:
    - key: conversation
      type: audio_dialogue
      label: "Interview"
      span_target: true
      display_options:
        show_timestamps: true
        scroll_height: 520px
        allow_speaker_assignment: auto
        speakers:
          - id: interviewer
            name: "Interviewer"
            color: "#7c3aed"
            side: left
          - id: participant
            name: "Participant"
            color: "#059669"
            side: right

annotation_schemes:
  - annotation_type: radio
    name: turn_topic
    description: "What is this turn about?"
    labels: [structure, workload, tooling, morale, other]

  - annotation_type: span
    name: quotes
    description: "Highlight anything quotable in the writeup"
    labels:
      - name: quotable
        key_value: "q"
這裡有三處在幹活。
說話人名冊在還沒有人分配過任何一個話輪之前,就給這兩個角色定好了穩定的名字、顏色和左右位置。沒有它,說話人也還是會拿到顏色,但那是每份轉寫稿各自確定性地分配的,不是全語料一致的。
turn_level: true 配上 turn_binding,把主題問題掛到每一個話輪上,而不是掛到整場訪談上。這才是讓話輪在實際操作中成為標註單元的東西。
span_target: true 加上 span 方案,讓一段高亮可以跨越話輪邊界,當值得引用的段落橫跨一個問題和它的回答時,這一點很重要。說話人被重新分配時,偏移量保持穩定。
跑起來:
python potato/flask_server.py start config.yaml -p 8000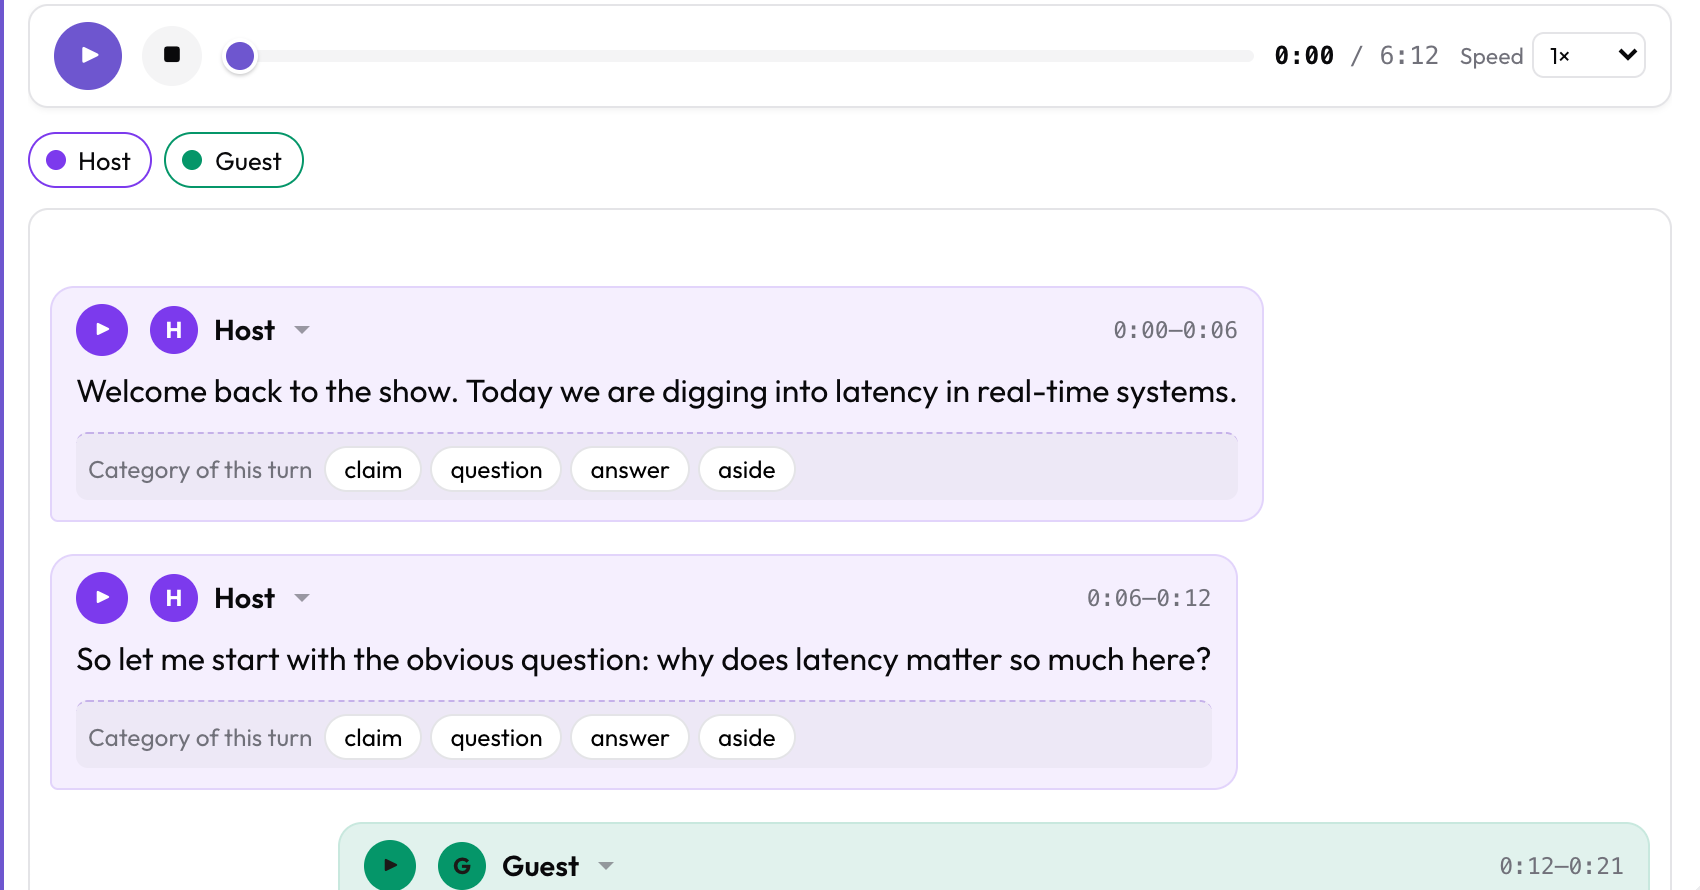 每個話輪都有一個只播放這一輪的播放按鈕,以及它自己的標註問題
每個氣泡上都有一個播放按鈕,只播這一個話輪然後停下。實際用起來,這是標註者會主動提起的功能:拿某一句去核對音訊,不再是一場拖進度條的苦差事。
第 5 步:在對的東西上看一致性
每場訪談兩位標註者,於是你有兩種一致性要看。
主題標籤是話輪層面上普通的分類一致性。因為話輪 id 是確定性的,同一個檔案永遠產生同樣的 id,兩位標註者的標籤不需要任何對齊步驟就能對上。
說話人分配值得單獨看。如果兩位標註者在 15% 的話輪上對“誰在說話”有分歧,那是關於音訊本身的一個訊號,也意味著自動說話人分離至少會以同樣的頻率出錯,而且不會告訴你。
一致性指標見標註者間一致性,高亮部分見跨度與結構化輸出的一致性,後者需要不同的處理方式,因為標註者除了選標籤還要選邊界。
第 6 步:匯出
標準的 JSON、JSONL 和 CSV 照常可用。如果你想讓時間對齊一路活到語音分析工具裡,就把分層標註匯出成 ELAN 或 Praat 格式:
python -m potato.export --config config.yaml --format eaf --output ./out/
python -m potato.export --config config.yaml --format textgrid --output ./out/
兩者都能雙向往返,因為 Potato 也能把 EAF 和 TextGrid 當輸入讀。在這裡標註,在 ELAN 裡精修,再把結果讀回來。
會出問題的四件事
有人留的是 .txt。 沒有時間資訊,找不回來,只能重跑。--dry-run 會在你在它上面搭起任何東西之前就抓住它。
時間差了 1000 倍。 上游某個環節把秒和毫秒混了。Whisper 和 Deepgram 輸出的是浮點秒;AssemblyAI、whisper.cpp 的偏移量,以及 Whisper 的 TSV 輸出的是整數毫秒。
在字幕行輸入上套句子級方案。 上面講過了,也是這四件裡代價最高的一件,因為你要等到算一致性的時候才會發現。
信任了沒人核過的說話人分離。 一處分離錯誤會傳染到掛在那個話輪上的每一個標籤,而當你回頭找原因時,它看起來像是標註者分歧。
延伸閱讀
- 如何標註 Whisper 轉寫文本
- 如何標註 YouTube 字幕
- 轉寫格式
- Transcript Format Ingestion,一個把六種格式並排展示的可執行示例設計
- Potato 2.7.1:轉寫稿本來就有了