Potato 2.7.1:轉寫稿本來就有了
Potato 2.7.1 直接讀取 21 種轉寫和字幕格式,可以從媒體檔案旁邊的並列檔案里加載它們,還附帶一個轉換器,把一整個 ASR 輸出目錄變成可以直接標註的資料檔案。
幾乎沒有人是帶著一堆裸音訊、別的什麼都沒有來找標註工具的。他們帶來的是轉寫稿。有人把 Whisper 跑在了一整個訪談目錄上。有人從一百場會議報告裡扒下了字幕。有人接手了一批 TextGrid,來自一個 2019 年就結束的田野調查項目。
然後工具讓他們去寫一個轉換指令碼。
Potato 2.7.1 要做的就是把這一步去掉。它直接讀取 21 種轉寫和字幕格式,可以從躺在媒體檔案旁邊的檔案里加載它們,而不要求你把所有內容都粘進一個數據檔案裡;如果你最後確實想要一個數據檔案,它也帶了一個轉換器。
 Potato 2.7.1
進來 21 種格式,出去一個模型
從 6 種漲上來的。完整清單在轉寫格式頁面,粗略說是:九種 ASR 輸出(Whisper JSON、WhisperX 及其他帶說話人分離的 JSON、whisper.cpp、Whisper TSV、AWS Transcribe、Deepgram、AssemblyAI、Rev.ai、SPoRC),六種字幕格式(SubRip、WebVTT、SubStation Alpha、TTML 和 DFXP、YouTube json3、YouTube srv1/srv2/srv3),三種來自強制對齊領域的格式(NIST CTM、Praat TextGrid、ELAN EAF),再加三種通用形狀,留給完全來自別處的資料。
對齊類格式是我們最高興的一項補充。匯出到 EAF 和 TextGrid 本來就有,所以分層標註現在可以雙向往返:把已有的對齊拿進來,在 Potato 裡改好,再送回 ELAN 或 Praat。
識別是按資料的形狀來做的,而不是按副檔名,這意味著一個叫 captions.txt 的 WebVTT 檔案照樣能被解析成 WebVTT,也意味著同一份轉寫稿無論是內聯的還是從磁碟讀的,都不用改配置。
只要來源提供,詞級時間戳和分段置信度都會被保留。像 CTM、Deepgram、AssemblyAI 這些天然是詞級的格式,會按說話人變化加一個停頓閾值分組成話輪。
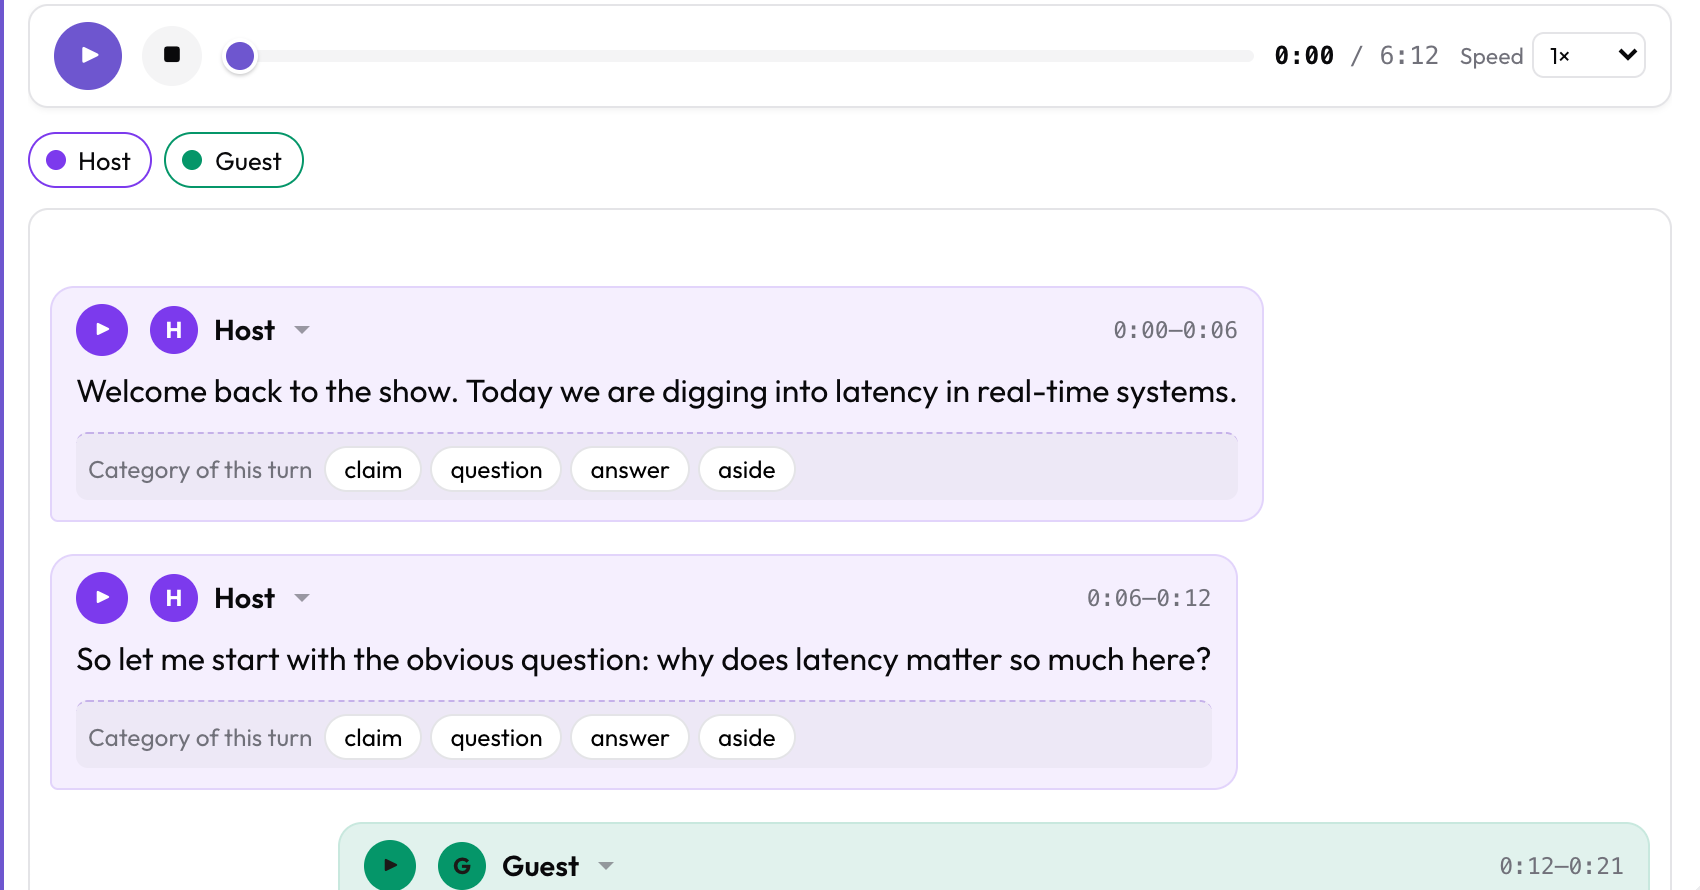 不管進來的是什麼格式,出來的都是這個
並列檔案
你的 ASR 工具已經把檔案按一個合理的佈局寫好了:媒體在這兒,轉寫稿就在它旁邊。沒有什麼好理由逼你把這套結構壓平成一坨資料,所以現在你可以直接指過去:
{"id": "int_001", "conversation": {"audio": "media/int_001.mp3",
                                   "transcript": "media/int_001.srt"}}
路徑相對 task_dir 解析,並和其他所有配置路徑一樣要過同一套目錄穿越校驗。如果你的資料裡確實存著一行內聯轉寫稿、而它碰巧長得像檔名,用 transcript_is_path: false 可以把這套啟發式關掉。
實際的好處是你的轉寫稿依然是檔案。你可以 diff 它們、重新生成它們、把它們交給別人,而不是讓一份副本化石般封在某個 JSON 數組裡。
給另一種情況準備的轉換器
有時候你確實想要一個數據檔案。potato transcripts 會 glob 一個目錄,按檔名主幹把每份轉寫稿和它的媒體配對,從檔名推出條目 id,然後把結果寫出來:
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.json--dry-run 什麼都不寫,只告訴你它找到了什麼,而當一份轉寫稿渲染成一整塊分不開的東西時,這也是第一個該跑的命令:
Scanned 3 file(s):
  interview_01.json      Whisper JSON      42 turns    891.4s  undiarized
  interview_02.json      WhisperX JSON     51 turns   1120.8s  2 speaker(s): SPEAKER_00, SPEAKER_01
  interview_03.json      Whisper JSON      38 turns    754.2s  undiarized

3 item(s), 131 turn(s).
某個檔案被報成 plain text,幾乎總是因為一個 Whisper 的 .txt 混進了 .json 輸出裡。.txt 里根本沒有任何時間資訊,不重跑模型就找不回來。我們收到的“為什麼我的轉寫稿看起來不對”的反饋裡,大部分都是這一條造成的。
--emit-config 會在資料檔案旁邊列印一份配套的 config.yaml。
四個方案共用一套詞彙
audio_dialogue、speech_transcript、voice_interaction 和 tiered_annotation 過去各自用自己的方式解析轉寫資料、各自接受不同的格式子集,而沒有人說得清為什麼。它們現在共用一個歸一化器,所以任何一個接受的格式,四個都接受。
已有配置不受影響。每個方案都保留了舊的解析邏輯作為回退,之前能用的每一種轉寫形狀現在還是逐位元組能用。
tiered_annotation 還多了一個可選的轉寫播種功能。把 transcript_field 指向你的轉寫稿,就會有一層帶著預填內容出現,於是標註者是在修正一份已有的對齊,而不是從零開始重新切分語音:
  - annotation_type: tiered_annotation
    name: tiers
    source_field: audio_url
    media_type: audio
    tiers:
      - name: utterance
        labels:
          - name: speech
            color: "#7c3aed"
播種出來的區間在標註者真正編輯之前不會被儲存,所以沒人動過的種子永遠不會被誤記成人工成果。
Potato 仍然不做的事
它不做轉寫,也不做說話人分離。ASR 跑在上游。Potato 讀的是你的流水線產出的東西。
這一點會被反覆問到,因為 Potato 確實會跑一個本地 Whisper 模型,用在 Think-Aloud 模式裡,那是用來錄標註者一邊幹活一邊說話的。那是一個面向你的標註者的採集功能,不是面向你的語料。兩回事,同一個詞。
詞級置信度在來源提供時會被解析並保留在資料模型裡,但目前還沒有檢視它的介面。
還有一些格式根本沒有解析器:SAMI、MicroDVD、SubViewer、Transcriber .trs、EXMARaLDA、CHAT/CHILDES、單獨的 RTTM,以及 Montreal Forced Aligner 或 Gentle 的原生輸出。這些請先自行轉換。我們把這份清單公開出來,是因為一份什麼都不排除的“支援格式列表”並不值幾個錢。
文件
- 轉寫格式 —— 每種格式及其識別規則、歸一化的話輪模型、並列檔案規則、配置鍵,以及按真實症狀編排的排查指南
- 如何標註 Whisper 轉寫文本 —— 該保留哪個輸出檔案,以及為什麼說話人分離是一個單獨的決定
- 如何標註 YouTube 字幕 ——
yt-dlp,以及自動生成的字幕能支援和不能支援什麼 - Transcript Format Ingestion —— 一個把六種格式並排展示的可執行示例設計
升級
pip install --upgrade potato-annotation==2.7.1你不需要改任何配置。Potato 以前接受的每一種轉寫形狀,現在還是照樣接受。