面向 AI 編碼智慧體的 GitHub PR 風格程式碼評審
在 Potato 中搭建 GitHub PR 風格的程式碼評審標註:diff 內聯評論、檔案級品質評分,以及對編碼智慧體產出的通過或打回結論。
為什麼要做程式碼評審標註
大多數編碼智慧體基準把評估壓縮成一個二元問題:測試過了沒有?SWE-bench 報告 issue 的解決率,HumanEval 報告 pass@k。這些指標拿來排榜有用,但對理解程式碼品質沒什麼幫助。
一個智慧體可以通過全部測試,同時寫出沒人願意維護的程式碼:帶安全漏洞的、跑得慢的,或者風格和整個程式碼庫對著幹的。就算測試全綠,人類評審也會在那個 PR 上要求修改。如果你想要的是能被人真正合並的程式碼,就得去評審程式碼本身,而不只是跑測試。
Potato 的 code_review 標註方案把 GitHub PR 評審的體驗搬進了標註工具。標註者看到帶語法高亮的 unified diff,點選 diff 行新增內聯評論,在若干品質維度上給檔案打分,最後給出 approve、request changes 或 comment 的結論——和評審一個真實的 pull request 一樣。完整的方案參考見編碼智慧體標註文件和智慧體評估指南。
這是 Potato 裡的程式碼評審介面,展示了內聯 diff 評論和檔案級評分:
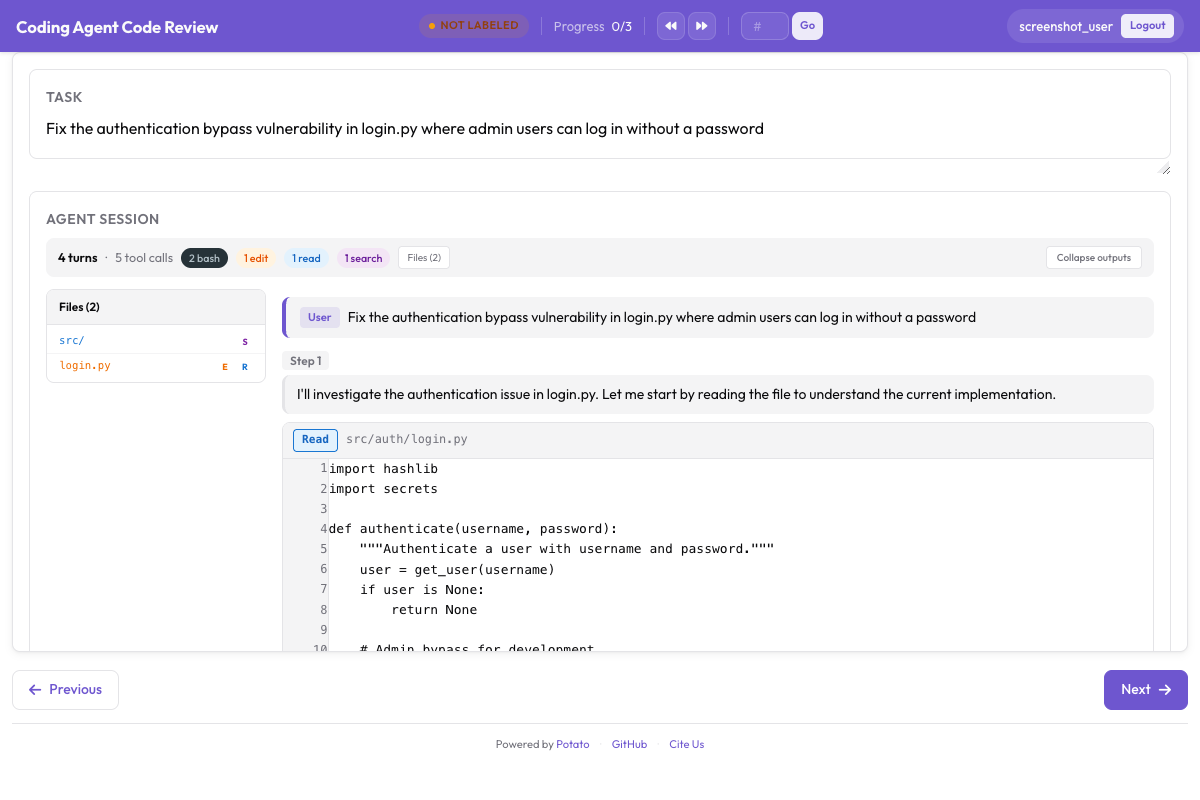 Potato 的程式碼評審介面,包含內聯 diff 評論和檔案級品質評分
程式碼評審方案概覽
code_review 方案分三層:
- 內聯 diff 評論:標註者點選 diff 中的任意一行,附上一條帶分類的評論(bug、風格、效能、安全、邏輯、建議、疑問)
- 檔案級評分:每個被修改的檔案都單獨獲得正確性(1-5)和程式碼品質(1-5)兩項評分
- 總體結論:標註者給出最終判斷——通過、要求修改,或只留評論
這套流程和真實的程式碼評審對應,開發者用起來不會彆扭,而它產出的結構化資料可以直接對接程式碼評審模型的訓練。
CodingTraceDisplay:diff 是怎麼渲染的
CodingTraceDisplay 元件把編碼智慧體的 trace 渲染成一串工具呼叫及其輸出,並對檔案編輯做了專門處理。當智慧體編輯檔案時,介面顯示 unified diff,其中包含:
- 紅色行:被刪除的行(字首
-) - 綠色行:新增的行(字首
+) - 灰色行:上下文行(未改動)
- 行號:行號槽中同時給出舊行號和新行號
- 語法高亮:根據副檔名做語言感知的高亮
- 點選評論:點選任意一行會開啟一個錨定到該行的評論表單
diff 由智慧體的編輯操作自動算出。如果智慧體用的是搜尋替換類工具,Potato 會重建改動前後的狀態並生成 unified diff。
對於一條 trace 中修改了多個檔案的智慧體(現實中的 bug 修復很常見),每個檔案有自己的可摺疊 diff 區塊,類似 GitHub PR 的 “Files changed” 標籤頁。
CodingTraceDisplay 渲染程式碼改動時帶有正確的語法高亮:
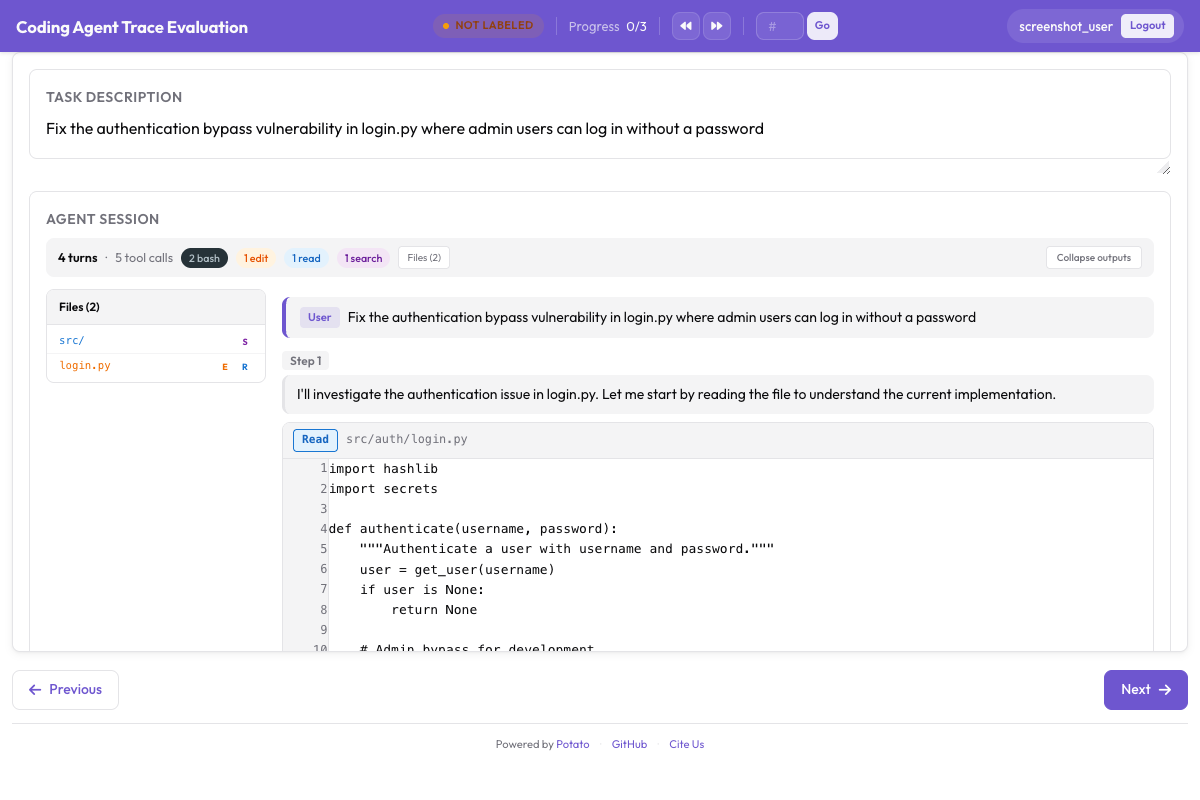 CodingTraceDisplay 渲染帶語法高亮的 unified diff 和檔案樹側邊欄
評論分類
標註者點選 diff 行新增評論時,需要選一個分類:
| 分類 | 顏色 | 說明 | 示例 |
|---|---|---|---|
bug | 紅色 | 程式碼存在功能性錯誤 | “如果 user 是 None,這裡會拋 NullPointerException” |
style | 藍色 | 程式碼風格或約定問題 | “本項目函式用 snake_case,不是 camelCase” |
performance | 橙色 | 程式碼效率低 | “這是在迴圈裡查資料庫,應該用批次查詢” |
security | 紫色 | 安全漏洞 | “使用者輸入沒有做淨化就直接拼進了 SQL 查詢” |
logic | 黃色 | 邏輯問題,未必立刻導致失敗 | “這個條件應該是 >= 而不是 >,邊界上差一” |
suggestion | 綠色 | 改進建議,不算錯誤 | “這裡可以考慮用 context manager,資源處理更乾淨” |
question | 灰色 | 需要澄清 | “為什麼加了這個 import?看起來並沒有被用到” |
每條評論還有一個自由文本正文,標註者在這裡詳細說明問題,就像寫真實的 PR 評論一樣。
檔案級評分
看完某個檔案的 diff 之後,標註者從兩個維度給它打分:
正確性(1-5):
- 1:不能工作,還引入了新 bug
- 2:部分可用,存在明顯問題
- 3:主路徑可用,但漏掉了邊界情況
- 4:基本正確,只有小問題
- 5:完全正確,邊界情況也處理得當
程式碼品質(1-5):
- 1:無法維護,毫無結構
- 2:品質差,風格或設計問題嚴重
- 3:可以接受,遵循了基本約定
- 4:品質好,乾淨可讀
- 5:優秀,寫法地道,文件齊全
結論選項
看完所有檔案後,標註者從三種結論中選一個:
- Approve:程式碼可以原樣合併,或者只需要無關緊要的小改動
- Request Changes:合併之前需要做實質性修改
- Comment Only:只給反饋,不做合併決定
這三項與 GitHub 的三種 PR 評審狀態一一對應。
分步搭建
第 1 步:轉換編碼智慧體 trace
編碼智慧體的 trace 格式五花八門。下面是三種常見智慧體的例子。
從 Claude Code(JSON 匯出):
python -m potato.trace_converter \
  --input claude_code_sessions/ \
  --output data/code_traces.jsonl \
  --input-format claude_code
從 Aider(聊天記錄):
python -m potato.trace_converter \
  --input aider_logs/ \
  --output data/code_traces.jsonl \
  --input-format aider
從 SWE-Agent(trajectories 目錄):
python -m potato.trace_converter \
  --input swe_agent_trajectories/ \
  --output data/code_traces.jsonl \
  --input-format swe_agent_trajectory
轉換器輸出一種標準化的 JSONL 格式。每一行是一條 trace,包含任務、智慧體的各個步驟,以及檔案 diff:
{
  "trace_id": "swe_bench_123",
  "task": "Fix the TypeError in django/db/models/query.py when calling .values() on an empty QuerySet",
  "repo": "django/django",
  "base_commit": "a1b2c3d",
  "steps": [
    {
      "type": "thought",
      "content": "Let me look at the QuerySet.values() method to understand the TypeError."
    },
    {
      "type": "action",
      "tool": "search",
      "input": "def values",
      "file": "django/db/models/query.py"
    },
    {
      "type": "observation",
      "content": "Found at line 234: def values(self, *fields):\n    ..."
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "django/db/models/query.py",
      "old_content": "    def values(self, *fields):\n        clone = self._clone()\n        clone.query.set_values(fields)",
      "new_content": "    def values(self, *fields):\n        clone = self._clone()\n        if not fields and not self.query.values_select:\n            return clone\n        clone.query.set_values(fields)"
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "tests/queries/test_values.py",
      "old_content": "class ValuesTests(TestCase):",
      "new_content": "class ValuesTests(TestCase):\n    def test_empty_queryset_values(self):\n        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n        qs = Author.objects.none()\n        result = list(qs.values())\n        self.assertEqual(result, [])"
    }
  ],
  "files_changed": [
    {
      "path": "django/db/models/query.py",
      "diff": "--- a/django/db/models/query.py\n+++ b/django/db/models/query.py\n@@ -234,6 +234,8 @@\n     def values(self, *fields):\n         clone = self._clone()\n+        if not fields and not self.query.values_select:\n+            return clone\n         clone.query.set_values(fields)"
    },
    {
      "path": "tests/queries/test_values.py",
      "diff": "--- a/tests/queries/test_values.py\n+++ b/tests/queries/test_values.py\n@@ -1,4 +1,10 @@\n class ValuesTests(TestCase):\n+    def test_empty_queryset_values(self):\n+        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n+        qs = Author.objects.none()\n+        result = list(qs.values())\n+        self.assertEqual(result, [])"
    }
  ]
}
第 2 步:配置程式碼評審方案
建立你的 config.yaml:
annotation_task_name: "Coding Agent Code Review"

data_files:
  - "data/code_traces.jsonl"

item_properties:
  id_key: "trace_id"
  text_key: "task"

# Display coding agent traces with diff rendering
display:
  type: "coding_trace"
  trace_key: "steps"
  diff_key: "files_changed"
  syntax_highlighting: true
  show_line_numbers: true
  collapse_large_diffs: true
  max_uncollapsed_lines: 200

annotation_schemes:
  - annotation_type: "code_review"

    # Inline comment categories

    # File-level ratings

    # Overall verdict

# Annotator settings
annotator_config:
  allow_back_navigation: true

# Output settings
output:
  path: "output/"
  format: "jsonl"
第 3 步:啟動標註服務
potato start config.yaml -p 8000開啟 http://localhost:8000。你會看到第一條編碼智慧體 trace,包括任務描述、智慧體的推理步驟,以及帶語法高亮的檔案 diff。
第 4 步:標註者的工作流
典型的評審流程是這樣的:
- 讀任務:搞清楚智慧體被要求做什麼(比如“修復 django/db/models/query.py 中的 TypeError”)
- 看 trace:翻一遍智慧體的推理步驟,理解它的思路
- 逐個檔案看 diff:
- 讀帶語法高亮的 diff
- 點選任意一行新增內聯評論
- 選擇評論分類(bug、風格、效能等)
- 寫下評論正文說明問題
- 給這個檔案的正確性(1-5)和程式碼品質(1-5)打分
- 給出結論:選擇通過、要求修改,或只留評論
- 提交:點選 “Submit” 或按 Ctrl+Enter
鍵盤快捷鍵可以加快流程:
| 快捷鍵 | 操作 |
|---|---|
j / k | 在檔案之間切換 |
c | 在選中行上開啟評論 |
1-5 | 為當前維度打分 |
a | 結論設為通過 |
r | 結論設為要求修改 |
Ctrl+Enter | 提交評審 |
匯出格式
每份提交的評審會產出一個結構化的 JSON 物件:
{
  "trace_id": "swe_bench_123",
  "annotator": "reviewer_01",
  "timestamp": "2026-03-22T14:32:11Z",
  "review": {
    "inline_comments": [
      {
        "file": "django/db/models/query.py",
        "line": 236,
        "side": "right",
        "category": "logic",
        "body": "This early return skips set_values entirely, but if fields are provided later via .values('name'), the previous empty .values() call will have returned a clone that never went through set_values. Consider checking if this clone is still valid downstream."
      },
      {
        "file": "tests/queries/test_values.py",
        "line": 5,
        "side": "right",
        "category": "suggestion",
        "body": "Consider adding a test case for .values() followed by .values('name') to verify the chaining behavior after your fix."
      }
    ],
    "file_ratings": [
      {
        "file": "django/db/models/query.py",
        "correctness": 3,
        "code_quality": 4
      },
      {
        "file": "tests/queries/test_values.py",
        "correctness": 4,
        "code_quality": 4
      }
    ],
    "verdict": "request_changes"
  }
}
這種結構化格式可以直接用於訓練程式碼評審模型,也便於做彙總分析。
分析:處理評審資料
載入評審結果
import json
import pandas as pd
from pathlib import Path

reviews = []
for f in Path("output/").glob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            reviews.append(json.loads(line))

print(f"Loaded {len(reviews)} code reviews")
評論分類分佈
from collections import Counter

all_comments = []
for rev in reviews:
    for comment in rev["review"]["inline_comments"]:
        all_comments.append(comment)

category_counts = Counter(c["category"] for c in all_comments)
print("Comment categories:")
for cat, count in category_counts.most_common():
    print(f"  {cat}: {count}")
檔案平均評分
ratings = []
for rev in reviews:
    for fr in rev["review"]["file_ratings"]:
        ratings.append(fr)

ratings_df = pd.DataFrame(ratings)
print("Average ratings by file:")
print(
    ratings_df.groupby("file")[["correctness", "code_quality"]]
    .mean()
    .round(2)
    .to_string()
)
結論分佈
verdict_counts = Counter(rev["review"]["verdict"] for rev in reviews)
total = sum(verdict_counts.values())
print("Verdict distribution:")
for verdict, count in verdict_counts.most_common():
    print(f"  {verdict}: {count} ({count/total*100:.1f}%)")
按智慧體統計 bug 率
如果你的 trace 裡帶 agent 欄位,就可以比較不同智慧體的 bug 率:
agent_bugs = {}
for rev in reviews:
    agent = rev.get("agent", "unknown")
    bug_count = sum(
        1 for c in rev["review"]["inline_comments"]
        if c["category"] == "bug"
    )
    if agent not in agent_bugs:
        agent_bugs[agent] = []
    agent_bugs[agent].append(bug_count)

print("Average bugs per review by agent:")
for agent, bugs in sorted(agent_bugs.items()):
    print(f"  {agent}: {sum(bugs)/len(bugs):.2f} (n={len(bugs)})")
應用場景
訓練程式碼評審模型
Potato 程式碼評審標註產出的結構化內聯評論、檔案評分和結論,很適合作為自動程式碼評審模型的訓練資料。每份評審提供:
- 定位到具體 diff 行的區域性反饋
- 已分類的問題(bug 還是風格還是效能)
- 多個粒度上的品質訊號(行、檔案、整體)
CodeRabbit 和 Graphite 的 AI 評審器用的就是這種資料格式,區別在於這裡的資料來自人類專家,而不是從 LLM 蒸餾出來的。
在 SWE-bench 上評估編碼智慧體
SWE-bench 告訴你智慧體有沒有解決 issue(測試是否通過),但不告訴你程式碼能不能合併。對 SWE-bench 的解法跑一遍程式碼評審標註,你就能區分出哪些智慧體是用乾淨的程式碼解決問題,哪些是靠 hack 矇混過關。這樣得到的排行榜更細緻,也更貼近開發者的真實體驗。
構建程式碼品質資料集
把大量 trace 的程式碼評審資料彙總起來,可以建立 AI 生成程式碼中常見品質問題的資料集。這類資料集可以用於:
- 微調程式碼生成模型,避開常見錯誤
- 針對 AI 生成程式碼的模式構建專門的 linter
- 訓練分類器,在人工評審之前先標出智慧體輸出中可能有問題的地方
小結
Potato 的 code_review 方案把 GitHub PR 評審流程放進了智慧體評估。你收集到的內聯評論、檔案評分和結論構成結構化的程式碼品質資料,比一個通過/失敗的測試結果說明的東西多得多。無論你是要訓練程式碼評審模型、把乾淨的 SWE-bench 解法和糙活區分開,還是隻想給自己的智慧體定一條品質基線,需要的都是這類資料。