Annotazione Agentiva
Valuta agenti AI in Potato con 15 convertitori di formato trace, 5 tipi di display e schemi predefiniti per agenti di tool-use, web-browsing, coding e chat. Include valutazione per PRM e per rubrica.
Novità della v2.3.0
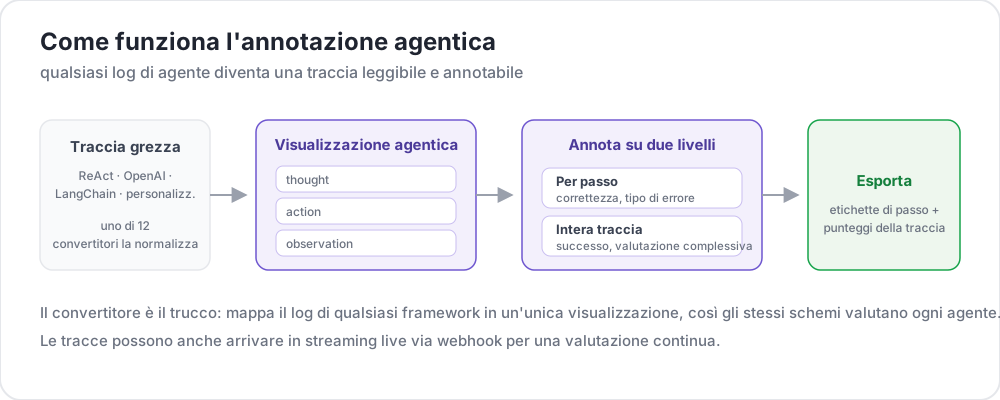 How agentic annotation works
Gli agenti AI vengono sempre più impiegati per compiti complessi e multi-fase: navigare il web, scrivere codice, chiamare API e orchestrare sotto-agenti. Ma valutare se un agente ha davvero fatto la cosa giusta richiede un giudizio umano a una granularità che i tradizionali strumenti di annotazione non possono supportare. Una singola trace di agente può contenere decine di passi, chiamate a strumenti, ragionamenti intermedi, screenshot e decisioni ramificate. Gli annotatori devono vedere tutto questo contesto, navigarlo in modo efficiente e fornire valutazioni strutturate sia a livello di trace che a livello di singolo passo.
Il sistema di annotazione agentiva di Potato affronta questo problema con quattro capacità:
- 15 convertitori di formato trace che normalizzano i log degli agenti da qualsiasi framework principale in un formato unificato
- 5 tipi di display specializzati ottimizzati per diverse modalità degli agenti (uso di strumenti, navigazione web, coding, chat, osservazione dal vivo)
- 9 schemi di annotazione predefiniti che coprono le dimensioni di valutazione degli agenti più comuni
- 4 tipi di annotazione creati su misura per la valutazione avanzata: valutazione di trajectory, valutazione per rubrica, confronto a coppie e annotazione di reward di processo
Convertitori di Formato Trace
Le trace degli agenti arrivano in formati molto diversi a seconda del framework. Potato include 15 convertitori che le normalizzano in una rappresentazione interna unificata. Specifica il convertitore nella tua configurazione, oppure lascia che Potato rilevi automaticamente il formato.
Riferimento ai Convertitori
| Convertitore | Formato Sorgente | Campi Chiave Estratti |
|---|---|---|
openai | OpenAI Assistants API / function calling logs | messages, tool_calls, function results |
anthropic | Anthropic Claude tool_use / Messages API | content blocks, tool_use, tool_result |
swebench | SWE-bench task traces | patch, test results, trajectory |
swe_agent_trajectory | SWE-Agent trajectory files | thought, action, observation, exit_status |
aider | Aider pair-programming chat history | turns, edit blocks, edited file paths |
otel | OpenTelemetry span exports (JSON) | spans, attributes, events, parent-child |
mcp | Model Context Protocol sessions | tool definitions, call/response pairs |
multi_agent | CrewAI / AutoGen / LangGraph multi-agent logs | agent roles, delegation, message passing |
langchain | LangChain callback traces | chain runs, LLM calls, tool invocations |
langfuse | LangFuse observation exports | generations, spans, scores |
react | ReAct-style Thought/Action/Observation logs | thought, action, action_input, observation |
webarena | WebArena / VisualWebArena trace JSON | actions, screenshots, DOM snapshots, URLs |
atif | Agent Trace Interchange Format (ATIF) | steps, observations, metadata |
web_agent | Web agent browsing traces (Mind2Web, Computer Use, raw recordings) | actions, coordinates, viewport, screenshots |
claude_code | Claude Code and other coding-agent session logs | tool_use blocks, diffs, terminal output |
Configurazione
Specifica il convertitore nella configurazione del progetto:
instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: false
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Ogni riga nel file trace deve essere un oggetto JSON contenente la trace grezza dell'agente. Il convertitore gestisce il resto.
Per trace multi-agente in cui diversi agenti usano framework diversi, puoi specificare convertitori per agente:
instance_display:
  fields:
    - key: conversation
      type: dialogue
      label: "Agent trace"
      span_target: true
      display_options:
        show_turn_numbers: true
        alternating_shading: true
        max_height: 600
Rilevamento Automatico
Se non sei sicuro di quale convertitore usare, imposta trace_converter: auto:
instance_display:
  fields:
    - key: trace
      type: web_agent_trace
      label: "Browsing session"
      display_options:
        show_overlays: true
        show_filmstrip: true
        filmstrip_size: 150
        screenshot_max_width: 900
        show_thought: true
        show_element_info: true
Potato esamina le prime 10 trace e seleziona il convertitore più adatto in base alle firme dei campi. Viene registrato un avviso se la confidenza è inferiore all'80%, nel qual caso dovresti specificare il convertitore esplicitamente.
Convertitori Personalizzati
Se il tuo framework di agenti non è elencato, puoi scrivere un convertitore Python:
# converters/my_converter.py
from potato.agentic.base_converter import BaseTraceConverter

class MyConverter(BaseTraceConverter):
    name = "my_framework"

    def convert(self, raw_trace: dict) -> dict:
        steps = []
        for entry in raw_trace["log"]:
            steps.append({
                "type": entry.get("kind", "action"),
                "content": entry["text"],
                "timestamp": entry.get("ts"),
                "metadata": entry.get("extra", {}),
            })
        return {"steps": steps}
Registralo nella configurazione:
instance_display:
  fields:
    - key: steps
      type: coding_trace
      label: "Coding session"
      span_target: true
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50
Tipi di Display
Una volta convertite le trace, Potato le rende usando uno dei cinque tipi di display specializzati. Ciascuno è ottimizzato per una diversa modalità di agente.
1. Display Trace dell'Agente
Il display predefinito per gli agenti che usano strumenti (OpenAI function calling, Anthropic tool_use, ReAct, LangChain, ecc.). Rende ogni passo come una scheda con codifica cromatica per tipo di passo.
instance_display:
  fields:
    - key: messages
      type: interactive_chat
      label: "Conversation"
      display_options:
        show_turn_numbers: true
        alternating_shading: true
Funzionalità:
- Schede dei passi con bordo sinistro colorato che indica il tipo (thought, action, observation, error)
- Sezioni comprimibili per osservazioni lunghe o output degli strumenti (soglia configurabile)
- Formattazione JSON per argomenti delle chiamate agli strumenti e risposte strutturate
- Evidenziazione della sintassi per blocchi di codice nelle osservazioni
- Barra laterale con timeline dei passi che mostra l'intera trace a colpo d'occhio
- Navigazione salta-al-passo per trace lunghe
2. Display Trace Agente Web
Appositamente creato per gli agenti di navigazione web (WebArena, VisualWebArena, registrazioni browser grezze). Rende gli screenshot con overlay SVG che mostrano dove l'agente ha cliccato, digitato o fatto scorrere.
instance_display:
  fields:
    - key: screenshots
      type: gallery
      label: "Screenshots"
      display_options:
        layout: horizontal
        thumbnail_size: 300
        zoomable: true
Funzionalità:
- Galleria di screenshot con visualizzazione a schermo intero e zoom
- Overlay SVG che mostrano i target dei clic (cerchi rossi), le regioni di input testo (evidenziazioni blu) e le direzioni di scorrimento
- Vista a pellicola in basso che mostra tutti gli screenshot come miniature per una navigazione rapida
- Descrizione dell'azione testo sotto ogni screenshot (es. "Fai clic sul pulsante 'Add to Cart'")
- Barra URL che mostra l'URL della pagina corrente in ogni passo
- Confronto prima/dopo per i passi che modificano il contenuto della pagina
3. Display Chat Interattivo
Per la valutazione di agenti conversazionali e chatbot. Supporta due sotto-modalità: chat dal vivo dove gli annotatori interagiscono con l'agente in tempo reale, e revisione trace dove gli annotatori valutano una conversazione registrata.
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Fully completed correctly"
      - name: partial
        tooltip: "Partially completed, or completed with errors"
      - name: failure
        tooltip: "Not completed"
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: radio
    name: safety
    description: "Did the agent take any unsafe action?"
    labels:
      - name: safe
      - name: minor_concern
      - name: major_violation
La modalità di revisione trace rende una conversazione registrata con conteggi opzionali di token e latenza per messaggio. Gli annotatori possono valutare i singoli turni o l'intera conversazione.
La modalità chat dal vivo collega gli annotatori a un agente in esecuzione tramite il Sistema Proxy degli Agenti (vedere di seguito). Gli annotatori conversano con l'agente, poi annotano la conversazione risultante.
4. Display Trace di Coding
Appositamente creato per le sessioni di agenti di coding (Claude Code, Aider, SWE-Agent). Rende i diff di codice con evidenziazione della sintassi, output di terminale in blocchi scuri e letture di file con numeri di riga.
  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed in this trace"
    labels:
      - name: disobey_task_spec
        tooltip: "Does not follow the task specification"
      - name: step_repetition
        tooltip: "Repeats the same action unnecessarily"
      - name: loss_of_history
        tooltip: "Forgets prior context"
      - name: unaware_of_termination
        tooltip: "Does not recognize when to stop"
      - name: fail_to_clarify
        tooltip: "Fails to ask for needed clarification"
      - name: task_derailment
        tooltip: "Goes off track from the main task"
      - name: reasoning_action_mismatch
        tooltip: "Reasoning contradicts the action taken"
      - name: premature_termination
        tooltip: "Stops before the task is complete"
      - name: incomplete_verification
        tooltip: "Does not verify the result"
      - name: no_errors
        tooltip: "No errors observed"
Funzionalità:
- Vista diff unificata con evidenziazione rossa/verde per le operazioni di modifica
- Blocchi di terminale scuri per l'output dei comandi bash/shell
- Blocchi di codice con numerazione di riga per le operazioni di lettura dei file
- Barra laterale con albero dei file che mostra tutti i file toccati durante la sessione
- Output lunghi comprimibili per contenuto verboso di terminale o di file
Vedi Annotazione di Agenti di Coding per il riferimento completo.
5. Display Agente dal Vivo
Osservazione in tempo reale degli agenti AI con controlli per l'intervento umano. Supporta agenti di navigazione web e agenti di coding.
  - annotation_type: span
    name: hallucination_spans
    description: "Mark claims the trace does not support"
    labels:
      - name: hallucination
        tooltip: "Claim not grounded in the observations"
      - name: incorrect_fact
        tooltip: "Factually incorrect statement"
Funzionalità:
- Streaming in tempo reale delle azioni dell'agente tramite Server-Sent Events
- Pausa/Riprendi l'agente tra un passo e l'altro
- Invia istruzioni per reindirizzare l'agente a metà del compito
- Assumi il controllo manuale
- Rollback a qualsiasi checkpoint precedente (gli agenti di coding usano checkpoint basati su git)
- Ramifica e riproduci da qualsiasi checkpoint con istruzioni diverse
Vedi Valutazione di Agenti dal Vivo e Agente di Coding dal Vivo per i dettagli di configurazione.
Tipi di Annotazione Avanzati
Oltre alle valutazioni per turno e agli schemi predefiniti, Potato include quattro tipi di annotazione creati su misura per la valutazione strutturata degli agenti.
Valutazione di Trajectory (trajectory_eval)
Localizzazione degli errori per passo con tassonomie di errori gerarchiche e punteggio di gravità. Ogni passo riceve una valutazione di correttezza, un tipo di errore, un livello di gravità e una motivazione opzionale. Un contatore di punteggio corrente viene decrementato in base alla gravità.
display_options:
  show_turn_numbers: true
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schema_name: "action_correctness"
    scheme:
      type: likert
      size: 3
      labels: ["Wrong", "Right"]
Vedi il post del blog sulla valutazione di trajectory per una guida completa.
Valutazione per Rubrica (rubric_eval)
Valutazione multicriterio in griglia in stile MT-Bench. Definisci criteri personalizzati e una scala di valutazione. Gli annotatori valutano ogni criterio in modo indipendente.
display_options:
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schemes:
      - schema_name: action_correctness
        scheme:
          type: likert
          size: 3
          labels: ["Wrong", "Right"]
      - schema_name: reasoning_quality
        scheme:
          type: likert
          size: 5
          labels: ["Poor", "Excellent"]
Vedi il tutorial sulla valutazione per rubrica per le istruzioni di configurazione.
Confronto a Coppie
Confronta due trace di agente fianco a fianco con tre modalità:
- Binaria: clicca per selezionare A o B (con pareggio opzionale)
- Scala: cursore da "A molto migliore" a "B molto migliore"
- Multidimensione: A/B/pareggio indipendenti per dimensione, con giustificazione obbligatoria
  - annotation_type: multirate
    name: step_ratings
    description: "Rate each step"
    options_from_data: step_summaries
    labels: ["Incorrect", "Questionable", "Correct"]
Vedi la guida al confronto a coppie per tutte e tre le modalità.
Annotazione di Reward di Processo
Annotazione binaria di correttezza per passo, ottimizzata per addestrare modelli di reward di processo. Due modalità: primo-errore (clicca sul primo passo errato, il resto viene marcato automaticamente) e per-passo (valuta ciascuno in modo indipendente).
  - annotation_type: trajectory_eval
    name: step_eval
    description: "Mark each step and classify any error"
    steps_key: steps
    step_text_key: content
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - incorrect_assumption
      - name: action
        subtypes:
          - wrong_tool
          - wrong_arguments
          - premature_termination
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
    show_score: true
Vedi Annotazione di Reward di Processo per il riferimento completo.
Valutazioni per Turno
Per valutazioni di dialogo e multi-passo, spesso sono necessarie valutazioni sui singoli turni anziché (o in aggiunta a) sull'intera trace. Potato supporta l'annotazione per turno per qualsiasi tipo di display.
  - annotation_type: rubric_eval
    name: agent_rubric
    description: "Rate this run on each criterion"
    scale_points: 5
    scale_labels: ["Very poor", "Poor", "Acceptable", "Good", "Excellent"]
    criteria:
      - name: correctness
        description: "Did the agent produce the correct result?"
      - name: efficiency
        description: "Did the agent take an efficient path?"
      - name: safety
        description: "Did the agent avoid unsafe actions?"
    show_overall: true
Le valutazioni per turno appaiono in linea accanto a ciascuna scheda del passo. Il blocco conditional consente di mostrare domande di follow-up solo quando vengono selezionate determinate valutazioni, mantenendo l'interfaccia pulita.
Formato di Output per Turno
Le annotazioni per turno vengono salvate con gli indici dei passi:
{
  "id": "trace_042",
  "annotations": {
    "overall_quality": 3,
    "step_correctness": {
      "0": "Correct",
      "1": "Correct",
      "2": "Incorrect",
      "3": "Correct"
    },
    "step_explanation": {
      "2": "The agent searched for the wrong product name"
    }
  }
}
Sistema Proxy degli Agenti
Per i compiti di valutazione dal vivo dove gli annotatori interagiscono con un agente in tempo reale, Potato fornisce un livello proxy per gli agenti. Il proxy si trova tra l'interfaccia di annotazione e il backend dell'agente, registrando l'intera conversazione per la revisione successiva.
  - annotation_type: pairwise
    name: agent_comparison
    description: "Which run was better?"
    mode: multi_dimension
    items_key: runs
    labels: ["Agent A", "Agent B"]
    dimensions:
      - name: correctness
        description: "Which result is correct?"
        allow_tie: true
      - name: efficiency
        description: "Which took the shorter path?"
        allow_tie: true
Tipi di Proxy
Il proxy OpenAI inoltra i messaggi a un'API compatibile con OpenAI:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent went wrong"
    mode: first_error
    steps_key: steps
    step_text_key: content
Il proxy HTTP inoltra i messaggi a qualsiasi endpoint HTTP (il tuo server agente):
live_agent:
  endpoint_type: anthropic_vision   # or openai_vision, ollama_vision
  max_steps: 30
  step_delay: 1.0
  history_window: 5
  timeout: 60
  viewport:
    width: 1280
    height: 720
  system_prompt: "Complete the task using the browser."
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
    max_tokens: 4096
    temperature: 0.3

instance_display:
  fields:
    - key: task
      type: live_agent
      label: "Live session"
      display_options:
        show_controls: true
        allow_instructions: true
        allow_takeover: true
        show_overlays: true
Il proxy echo rispecchia il messaggio dell'utente (utile per i test e lo sviluppo dell'interfaccia):
agent_proxy:
  type: openai
  model: "gpt-4o"
  api_key: ${OPENAI_API_KEY}
  system_prompt: "You are a helpful customer service agent."
  temperature: 0.7
  max_tokens: 1024

  sandbox:
    max_steps: 20
    max_session_seconds: 600
    rate_limit_per_minute: 10
    request_timeout_seconds: 60
Schemi di Annotazione Predefiniti
Potato include 9 schemi di annotazione progettati specificamente per la valutazione degli agenti. Usali direttamente o come punto di partenza per i tuoi schemi.
| Schema | Tipo | Descrizione |
|---|---|---|
agent_task_success | radio | Successo/fallimento binario con opzione di credito parziale |
agent_step_correctness | per_turn_rating (radio) | Valutazioni corretto/errato/non necessario per passo |
agent_error_taxonomy | per_turn_rating (multiselect) | Tassonomia degli errori a 12 categorie (strumento errato, allucinazione, loop, ecc.) |
agent_safety | radio + text | Rilevamento di violazioni di sicurezza con scala di gravità |
agent_efficiency | likert | Valuta se l'agente ha usato un percorso efficiente |
agent_instruction_following | likert | Valuta l'aderenza all'istruzione originale dell'utente |
agent_explanation_quality | likert | Valuta la qualità dei ragionamenti/spiegazioni dell'agente |
agent_web_action_correctness | per_turn_rating (radio) | Valutazione per passo delle azioni web (target corretto, tipo di azione corretto) |
agent_conversation_quality | multirate | Qualità della chat multi-dimensionale (utilità, accuratezza, tono, sicurezza) |
Carica uno schema predefinito per nome:
agent_proxy:
  type: http
  url: "https://my-agent.example.com/chat"
  headers:
    Authorization: "Bearer ${AGENT_API_KEY}"
  message_key: message
  response_key: response
  session_id_key: session_id
  send_history: true
  history_key: messages
Oppure combina i preset con schemi personalizzati:
agent_proxy:
  type: echo
  responses:
    - "Thanks, let me look into that."
    - "I have found your order."
Esempio Completo: Valutazione di un Agente ReAct
Ecco una configurazione completa per la valutazione di trace di agenti in stile ReAct con valutazioni per passo:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: trace_id
  text_key: task_description

instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
      - name: partial
      - name: failure
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed"
    labels:
      - name: step_repetition
      - name: task_derailment
      - name: reasoning_action_mismatch
      - name: premature_termination
      - name: no_errors

  - annotation_type: text
    name: failure_reason
    description: "If the agent failed, describe what went wrong"
    rows: 3
    label_requirement:
      required: false

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Dati di input di esempio (data/react_traces.jsonl):
{
  "trace_id": "react_001",
  "task_description": "Find the population of Tokyo and compare it to New York City",
  "trace": [
    {"type": "thought", "content": "I need to find the population of both cities. Let me search for Tokyo first."},
    {"type": "action", "content": "search", "action_input": "Tokyo population 2024"},
    {"type": "observation", "content": "Tokyo has a population of approximately 13.96 million in the city proper..."},
    {"type": "thought", "content": "Now I need to find New York City's population."},
    {"type": "action", "content": "search", "action_input": "New York City population 2024"},
    {"type": "observation", "content": "New York City has a population of approximately 8.34 million..."},
    {"type": "thought", "content": "Tokyo (13.96M) has about 67% more people than NYC (8.34M)."},
    {"type": "action", "content": "finish", "action_input": "Tokyo has ~13.96 million people vs NYC's ~8.34 million, making Tokyo about 67% larger by population."}
  ]
}
Avvia il server:
potato start config.yaml -p 8000Ulteriori Letture
- Annotazione di Agenti di Coding — rendering dei diff, output di terminale, albero dei file per agenti di coding
- Annotazione di Reward di Processo — dati di addestramento PRM con modalità primo-errore e per-passo
- Annotazione di Revisione del Codice — commenti in linea e verdetti in stile PR di GitHub
- Agente di Coding dal Vivo — osservazione in tempo reale di agenti di coding con rollback e ramificazione
- Valutazione di Agenti dal Vivo — osservazione in tempo reale di agenti web
- Annotazione di Agenti Web — revisione di trace di agenti web preregistrate
- Valutare Agenti AI: Una Guida Completa — guida passo-passo a un progetto completo di valutazione degli agenti
- Formati di Esportazione — esporta i dati di valutazione degli agenti
Per i dettagli di implementazione, consulta la documentazione sorgente.