Annotazione di process reward
Raccogli etichette di reward per singolo passo per i process reward model, con modalità primo errore e passo per passo, etichette neutre opzionali e pre-etichettatura con LLM più verifica umana.
Novità della v2.4.0
I process reward model valutano i passi di ragionamento compiuti da un modello e non solo la sua risposta finale, quindi addestrarne uno richiede un'etichetta per passo invece di una per traccia. Lo schema process_reward raccoglie queste etichette.
Due modalità bilanciano velocità e dettaglio. La modalità primo errore chiede un solo clic: il primo passo che va storto, con tutto ciò che segue trattato come compromesso. La modalità passo per passo chiede un giudizio su ogni passo, il che costa di più e coglie casi che il primo errore non può rappresentare, come un agente che si riprende da un proprio errore.
Entrambe funzionano con i display delle tracce di coding, delle tracce degli agenti e della chain-of-thought.
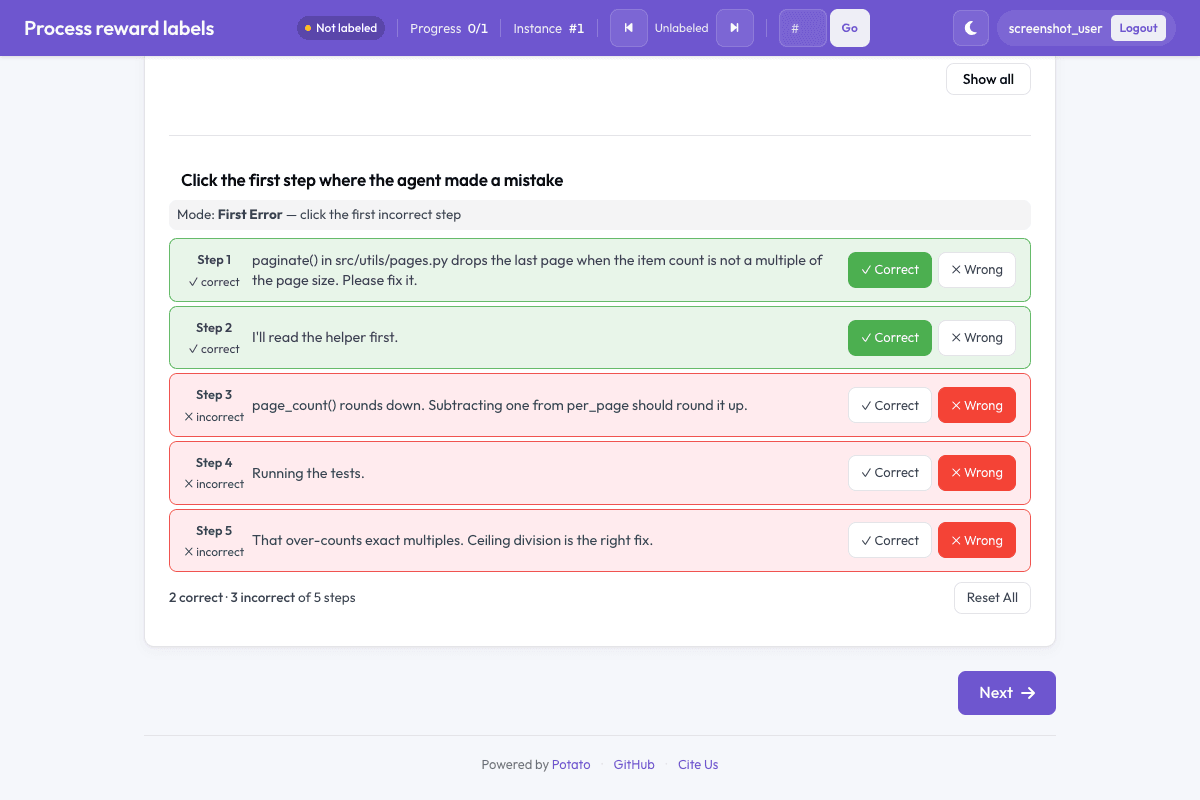 Un clic sul primo passaggio errato etichetta l'intera traccia
Modalità primo errore
L'annotatore legge la traccia dall'alto verso il basso e clicca sul primo passo sbagliato. I passi precedenti vengono registrati come corretti, e il passo cliccato e tutti quelli successivi come sbagliati. Ne esce la sequenza di etichette che l'addestramento PRM binario si aspetta: 1 fino all'errore, poi -1 dall'errore in avanti.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent made a mistake"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
steps_key indica il campo che contiene l'elenco dei passi, e step_text_key il campo di ciascun passo da mostrare.
Flusso di annotazione
- I passi partono non contrassegnati
- L'annotatore clicca sul primo passo sbagliato
- Tutto ciò che lo precede diventa verde
- Quel passo viene contrassegnato come primo errore
- Tutto ciò che lo segue viene contrassegnato come compromesso
I colori rendono visibile la cascata, che è lo scopo della modalità: un solo giudizio etichetta l'intera traccia.
Modalità passo per passo
Ogni passo viene giudicato per conto suo. Aggiungi allow_neutral per l'etichetta a tre vie in stile PRM800K, in cui un passo può non essere né giusto né sbagliato:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
allow_neutral vale solo nella modalità passo per passo. La cascata del primo errore non ha una posizione per un passo neutro, quindi l'opzione lì viene ignorata.
inline_with_trace: true collega i controlli di valutazione a ciascun passo nel display invece di raccoglierli in un pannello separato, ed è ciò che serve su una traccia lunga in cui l'annotatore altrimenti perderebbe il segno.
Rinominare le etichette
I tre pulsanti riportano per impostazione predefinita Correct, Neutral e Wrong. reward_labels li rinomina per i domini in cui quelle parole non vanno bene:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    reward_labels:
      correct: "Valid"
      neutral: "Neutral"
      incorrect: "Flawed"
Segmentare una chain-of-thought
Le tracce di ragionamento di solito arrivano come una lunga stringa e non come un elenco di passi. cot_segmentation la divide prima che inizi l'annotazione:
cot_segmentation:
  source_key: reasoning      # the item field holding the long CoT string
  strategy: auto             # blank_line | numbered | markers | sentence | llm | auto
  target_key: cot_steps      # where the step list is written
  min_step_chars: 30         # merge anything shorter into the previous step
  max_steps: 200

instance_display:
  fields:
    - key: cot_steps
      type: cot_trace
      label: "Reasoning"

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
Conviene impostare min_step_chars. Senza, la segmentazione per frasi e per righe vuote produce frammenti di una riga che gli annotatori non possono giudicare in isolamento, e l'etichetta che ne risulta è rumore.
Pre-etichettatura con LLM
Un modello può proporre le etichette per passo e l'annotatore conferma o corregge ciascuna, il che è più veloce che etichettare da zero su tracce lunghe:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Verify or correct each suggested reward"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
    ai_prelabel: true
    require_verification: true

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    max_tokens: 768
    temperature: 0.1
    include:
      all: true
ai_prelabel aggiunge il pulsante che richiede i suggerimenti. require_verification rifiuta l'annotazione finché ogni suggerimento non è stato confermato o modificato, ed è ciò che mantiene l'output un'etichetta umana e non una del modello.
Lascia a max_tokens un margine reale. Una chain-of-thought lunga più un verdetto per passo è una risposta ampia, e una risposta troncata appare come nessun suggerimento.
Che cosa contiene l'output
L'annotazione viene memorizzata sotto il nome dello schema come elenco steps più il mode con cui è stata raccolta:
{
  "step_rewards": {
    "mode": "per_step",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": 0, "source": "ai", "verified": true, "ai_reward": 0},
      {"reward": null, "source": null, "verified": false}
    ]
  }
}
reward vale 1 per corretto, -1 per sbagliato e 0 per neutro. Un passo saltato è null e non 0, così un passo che nessuno ha giudicato resta distinguibile da uno giudicato né giusto né sbagliato. La distinzione conta quando le etichette diventano dati di addestramento, perché trattare i passi saltati come neutri inventa in silenzio un segnale.
source registra se il valore viene da una persona o da un modello, e verified se una persona lo ha confermato. Con ai_prelabel attivo, ai_reward conserva il suggerimento originale del modello anche dopo che un annotatore lo ha sostituito, ed è ciò che permette di riportare quanto spesso il modello aveva ragione senza un secondo passaggio.
Esportazione
Potato non ha un formato di esportazione PRM o DPO integrato. Esporta le annotazioni e dai loro la forma che ti serve:
python -m potato.export -c config.yaml -f jsonl -o ./export/Convertire le annotazioni di primo errore in etichette di addestramento a livello di passo richiede poco codice, e scriverlo da sé permette di decidere come trattare i passi saltati:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "steps": [
                    {"content": src, "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_training_data.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Analisi
import json
from collections import Counter
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

print(f"Traces annotated: {len(traces)}")

all_correct = sum(
    1 for t in traces
    if all(s.get("reward") == 1 for s in t.get("steps", []))
)
print(f"Traces with no errors: {all_correct} ({all_correct / len(traces):.1%})")

# Where the first error lands
first_error_positions = []
for t in traces:
    for i, s in enumerate(t.get("steps", [])):
        if s.get("reward") == -1:
            first_error_positions.append(i)
            break

if first_error_positions:
    avg = sum(first_error_positions) / len(first_error_positions)
    print(f"Average first-error position: step {avg:.1f}")
    print("By position:", Counter(first_error_positions).most_common(10))
Quando ai_prelabel è attivo, gli stessi record dicono con quale frequenza il suggerimento del modello è sopravvissuto alla revisione:
kept = changed = 0
for t in traces:
    for s in t.get("steps", []):
        if s.get("ai_reward") is None:
            continue
        if s.get("reward") == s.get("ai_reward"):
            kept += 1
        else:
            changed += 1

total = kept + changed
if total:
    print(f"AI suggestions kept: {kept}/{total} ({kept / total:.1%})")
Questo tasso di accettazione è il numero da tenere d'occhio prima di fidarsi della pre-etichettatura in un nuovo dominio. Un tasso vicino al 100% di solito significa che gli annotatori confermano invece di controllare, non che il modello abbia ragione.
Contesto di ricerca
L'annotazione di process reward esiste per sostenere il lavoro sui reward model per sistemi a più passi, dove la constatazione che motiva l'intero approccio è che una risposta finale corretta può poggiare su un ragionamento difettoso. Le etichette a livello di passo separano le due cose, e le modalità primo errore e passo per passo qui descritte corrispondono ai formati di etichetta usati da quel filone di lavoro.
Per la progettazione della tassonomia e le questioni di accordo che ne derivano, vedi la localizzazione degli errori per passo, che tratta le stesse tracce dal lato della classificazione degli errori.
Vedi anche
- Annotazione di coding agent - mostra e annota le tracce dei coding agent
- Annotazione agentica - annotazione generica di tracce di agenti
- Formati di esportazione - i formati che Potato esporta
- Controllo qualità - accordo tra annotatori e adjudication
- Eseguire il fine-tuning di un LLM sulle tue annotazioni - addestrare un modello di ricompensa di processo sulle valutazioni dei passi con
prm-reward
Per i dettagli implementativi, vedi la documentazione sorgente.