Valutare gli agenti AI: annotazione umana delle tracce degli agenti
Come configurare in Potato la valutazione umana degli output di agenti AI, dall'importazione delle tracce e dalla progettazione di schemi a livello di traccia e di passo fino all'analisi dei risultati esportati.
Converti le tracce degli agenti con python -m potato.trace_converter, visualizzale tramite un campo di visualizzazione agent_trace e raccogli un verdetto a livello di traccia insieme a un giudizio trajectory_eval per passo. È il giudizio per passo a individuare il passo in cui l'esecuzione è andata storta.
Un tasso di successo ti dice quanto spesso un agente porta a termine il task e niente sul perché dei fallimenti. Due agenti con lo stesso tasso di successo del 62% possono fallire per ragioni del tutto diverse, uno perché sceglie lo strumento sbagliato e l'altro perché ragiona correttamente su un retrieval sbagliato, e la correzione è diversa in ciascun caso. La valutazione umana a livello di passo li separa, perché l'annotatore segna quale passo si è rotto e che tipo di rottura è stata.
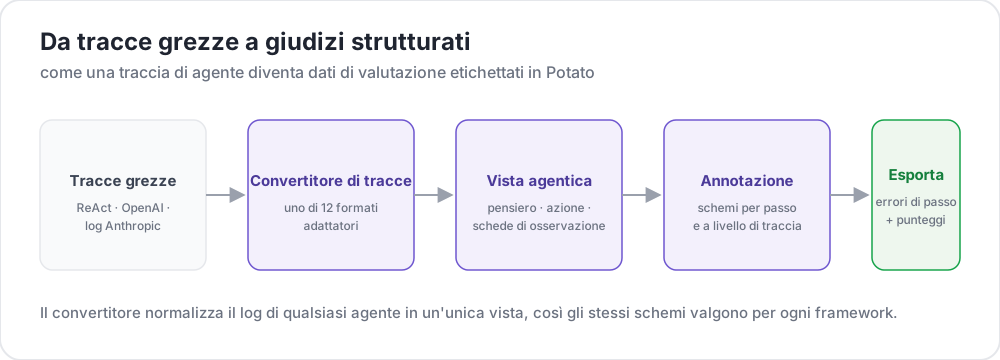 Dalle tracce grezze ai giudizi strutturati
Questa guida costruisce la pipeline per un agente in stile ReAct che risponde alle domande cercando sul web. Le configurazioni sono verificate con Potato 2.9.1:
pip install --upgrade potato-annotationPasso 1: convertire le tracce
Potato registra 15 convertitori di tracce, e la CLI li elenca con le relative descrizioni:
python -m potato.trace_converter --list-formatsL'elenco comprende react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code e aider. Gli export delle esecuzioni di LangSmith passano per langchain, e i log di CrewAI, AutoGen e LangGraph passano per multi_agent.
Il convertitore react legge una traccia i cui passi hanno le chiavi thought, action e observation:
{
  "id": "trace_001",
  "task": "What is the capital of Australia and what is its population?",
  "steps": [
    {"thought": "I need the capital of Australia and then its population.",
     "action": "search('capital of Australia')",
     "observation": "Canberra is the capital city of Australia."},
    {"thought": "Now I need Canberra's population.",
     "action": "search('Canberra population 2025')",
     "observation": "Canberra has a population of approximately 467,000 as of 2025."},
    {"thought": "I have both pieces of information.",
     "action": "finish('Canberra, approximately 467,000')"}
  ],
  "metadata": {"agent": "GPT-4", "tokens": 2340}
}
Un solo comando converte il file:
python -m potato.trace_converter \
  --input raw_traces.json \
  --input-format react \
  --output data/traces.jsonl
Passa --auto-detect al posto di --input-format quando non sei sicuro di quale convertitore sia adatto, e il registro ne sceglie uno in base alle firme dei campi. Indica il formato in modo esplicito non appena lo conosci, perché il rilevamento prende il primo convertitore che corrisponde e diversi formati si sovrappongono nei campi che contengono.
Tutti i convertitori scrivono la stessa forma canonica, ed è questo che permette a una sola configurazione di funzionare con framework diversi. Ogni riga contiene id, task_description e conversation, una lista di turni con uno speaker e un text. Un convertitore che li ha a disposizione scrive anche agent_name, metadata_table e screenshots:
{
  "id": "trace_001",
  "task_description": "What is the capital of Australia and what is its population?",
  "agent_name": "GPT-4",
  "metadata_table": [{"Property": "Steps", "Value": "3"},
                     {"Property": "tokens", "Value": "2340"}],
  "conversation": [
    {"speaker": "Agent (Thought)", "text": "I need the capital of Australia and then its population."},
    {"speaker": "Agent (Action)", "text": "search('capital of Australia')"},
    {"speaker": "Environment", "text": "Canberra is the capital city of Australia."}
  ]
}
Passo 2: visualizzare la traccia
La visualizzazione agent_trace mostra ogni turno come una card, con un colore in base al tipo di passo, così l'annotatore legge l'esecuzione e non un blocco di JSON:

instance_display decide cosa compare nella pagina e in quale ordine. La descrizione del task sta in cima, perché l'annotatore deve sapere cosa è stato chiesto all'agente prima che qualsiasi passo abbia senso, e la tabella dei metadati sta sotto, in un campo foglio di calcolo compatto:
instance_display:
  layout:
    direction: vertical
    gap: 16px

  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120

    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Comprimere le osservazioni impedisce ai risultati di ricerca lunghi di spingere il resto della traccia fuori dallo schermo, dato che una traccia con una dozzina di risultati di ricerca completi è soprattutto scorrimento, e l'annotatore perde il segno di dove si trova nell'esecuzione. Impostare span_target: true sullo stesso campo consente a uno schema di span di marcare le parole esatte di un'affermazione allucinata all'interno di un turno, una registrazione più fine che segnare come sbagliato l'intero passo.
Passo 3: il giudizio a livello di traccia
Tre domande coprono la traccia nel suo insieme. Il successo del task è il numero principale, la correttezza della risposta separa una risposta giusta raggiunta male da una risposta sbagliata, e l'efficienza è ciò che distingue due agenti che hanno entrambi successo:
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
        tooltip: "Fully completed correctly"
      - name: "Partial success"
        tooltip: "Completed with errors or omissions"
      - name: "Failure"
        tooltip: "Not completed"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3
"Cannot determine" si guadagna il suo posto. Senza questa opzione, un annotatore che non ha modo di verificare la risposta o tira a indovinare o la segna come errata, ed entrambe le scelte introducono rumore nel numero che ti interessa di più.
Passo 4: il giudizio per passo
trajectory_eval mostra ogni passo come una card con i propri controlli, e riunisce l'etichetta di correttezza, la tassonomia degli errori e la gravità in un solo schema invece che in tre. Punta steps_key al campo che contiene i passi, che per una traccia convertita è conversation, e step_text_key alla chiave all'interno di ogni passo da visualizzare:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options:
      - correct
      - partially_correct
      - incorrect
      - unnecessary
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - factual_error
          - planning_error
      - name: execution
        subtypes:
          - wrong_tool
          - wrong_args
          - api_error
      - name: termination
        subtypes:
          - premature_stop
          - redundant_step
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100
I pesi di gravità trasformano un elenco di passi segnati in un unico numero confrontabile per traccia, e conviene cambiare i valori predefiniti invece di accettarli. Un peso dice quanto un errore critico sia peggiore di uno lieve per il tuo task, e in una valutazione di sicurezza quel rapporto è molto più ripido che in un task di ricerca.
Tenere unnecessary separato da incorrect è l'altra decisione da prendere in modo deliberato. Un passo sprecato costa token e tempo senza introdurre un errore, e unire le due categorie nasconde la differenza tra un agente che gira a vuoto e uno che sbaglia.
Passo 5: la configurazione completa
Tutto quanto sopra, in un unico file:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."
output_annotation_dir: "output/"

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: task_description

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120
    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
      - name: "Partial success"
      - name: "Failure"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3

  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options: [correct, partially_correct, incorrect, unnecessary]
    error_types:
      - name: reasoning
        subtypes: [logical_error, factual_error, planning_error]
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
      - name: termination
        subtypes: [premature_stop, redundant_step]
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

export_annotation_format: jsonl
Avvia il server e apri http://localhost:8000:
potato start config.yaml -p 8000Com'è la sessione di annotazione
La pagina mostra il task, la tabella informativa della traccia e le card dei passi, con i controlli per passo collegati a ciascuna card e gli schemi a livello di traccia sotto la traccia. L'ordine in cui lavorano gli annotatori conta più di quanto sembri. Valutare prima i passi e poi la traccia mantiene il verdetto complessivo ancorato a ciò che l'esecuzione ha fatto davvero, mentre valutare prima il successo tende a condizionare ogni giudizio sui passi che segue.
Tre abitudini vale la pena scriverle nelle istruzioni per gli annotatori. Espandere le osservazioni compresse invece di fidarsi della riga di riepilogo, perché un risultato di ricerca letto male è la fonte più comune di una risposta sbagliata che sembra ben ragionata. Confrontare la risposta finale con il ground truth prima di valutare il successo del task, quando il dataset ne ha uno. Usare la timeline dei passi per tornare a un passo quando un passo successivo rivela che quello precedente era già sbagliato.
Passo 6: esportare e analizzare
L'esportatore JSONL scrive annotations.jsonl, con un record per istanza e annotatore:
python -m potato.export --config config.yaml --format jsonl --output ./export/Ogni record contiene instance_id, user_id, labels, spans e links, e le risposte agli schemi si trovano sotto labels, indicizzate per nome dello schema:
import json
import pandas as pd

records = [json.loads(line) for line in open("export/annotations.jsonl")]

df = pd.DataFrame([
    {"trace": r["instance_id"], "annotator": r["user_id"], **r["labels"]}
    for r in records
])

print(df["task_success"].value_counts())
Oltre qualche centinaio di tracce, esporta invece in Parquet e interroga il file direttamente. L'export Parquet scrive annotations.parquet con instance_id, user_id e una colonna per ogni schema di annotazione, quindi il nome dello schema è una colonna e non un valore:
python -m potato.export --config config.yaml --format parquet --output ./export/import duckdb
print(duckdb.sql("""
SELECT task_success, COUNT(*) AS n
FROM 'export/annotations.parquet'
GROUP BY task_success
ORDER BY n DESC
"""))I giudizi a livello di passo sono quelli da leggere per primi. Contare i sottotipi di errore su tutte le tracce ti dice se l'agente ha un solo errore sistematico o una lunga coda di errori scollegati tra loro, e solo il primo caso merita una correzione mirata.
Passo 7: più annotatori e una fase di qualificazione
La valutazione degli agenti è abbastanza soggettiva da rendere una singola valutazione per traccia una misura senza barra d'errore. Tre annotatori per traccia ti danno un valore di accordo, e l'assegnazione casuale evita che la sovrapposizione si concentri sulle tracce che si trovano all'inizio del file:
num_annotators_per_item: 3
assignment_strategy: random
Una fase di qualificazione intercetta gli annotatori che non hanno capito la tassonomia degli errori prima che passino una giornata ad applicarla in modo incoerente. Il blocco di training li tiene su tracce con risposta nota finché non superano la prova:
training:
  enabled: true
  data_file: "data/training_traces.jsonl"
  passing_criteria:
    min_correct: 4
  allow_retry: true
  failure_action: "repeat_training"
Altri framework per agenti
La visualizzazione e gli schemi restano gli stessi tra un framework e l'altro, e cambia solo il convertitore. Le tracce di OpenAI Chat Completions e i messaggi Anthropic con blocchi tool_use hanno ciascuno il proprio convertitore, e i log multi-agente di CrewAI, AutoGen e LangGraph ne condividono uno:
python -m potato.trace_converter --input runs.json --input-format openai --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format anthropic --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format multi_agent --output data/traces.jsonl
Gli agenti di programmazione hanno bisogno di una visualizzazione diversa, perché un diff letto come stringa JSON non si può revisionare. La visualizzazione coding_trace mostra diff unificati con un albero dei file e comprime gli output lunghi del terminale:

instance_display:
  fields:
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
Gli agenti di navigazione web hanno bisogno degli screenshot, delle sovrapposizioni delle azioni e di una filmstrip per scorrerli:
instance_display:
  fields:
    - key: steps
      type: web_agent_trace
      label: "Agent Browsing Trace"
      display_options:
        show_overlays: true
        show_filmstrip: true
        show_thought: true
        screenshot_max_width: 900
Annotare gli agenti di navigazione web tratta il formato delle sovrapposizioni e la modalità di creazione che registra nuove tracce.
Per i dettagli di implementazione alla base di tutto questo, consulta la guida alla valutazione degli agenti e la documentazione sulle tracce degli agenti. Se stai impostando la tua prima valutazione, converti dieci tracce, esegui la configurazione qui sopra e annotale tu stesso prima di scrivere le linee guida, perché la tassonomia degli errori che ti serve di solito non è quella che avresti scritto in anticipo.
Ulteriori letture
- Documentazione sull'annotazione agentica
- Annotare gli agenti di navigazione web
- Modalità Solo, per combinare l'annotazione agentica con la valutazione collaborativa tra umani e LLM
- Best-Worst Scaling, per classificare gli output degli agenti in modo comparativo
- Export Parquet, per l'analisi su larga scala