Annotazione Span
Evidenzia ed etichetta span di testo in Potato per il riconoscimento di entità nominate, con colori per etichetta, scorciatoie da tastiera, tooltip e span discontinui.
L'annotazione span consente agli annotatori di selezionare ed etichettare porzioni di testo, ed è così che in Potato si costruiscono i compiti di riconoscimento di entità nominate (NER), di etichettatura delle parti del discorso e di evidenziazione del testo. Un'etichetta si scrive come semplice stringa oppure come oggetto con i propri color, key_value e tooltip. Potato legge questi tre come proprietà di ciascuna etichetta, quindi una mappa colors, key_values o tooltips a livello di schema non ha alcun effetto su uno schema span.
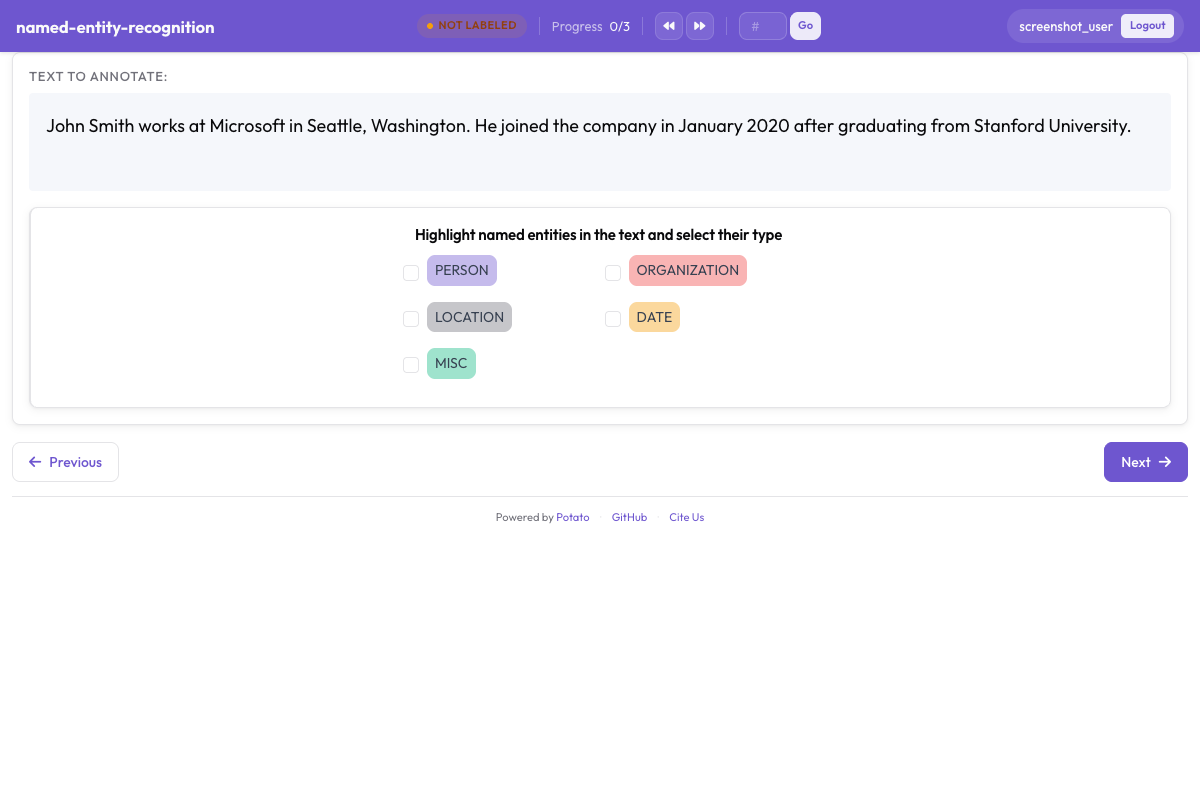 Annotazione span con etichette di entità a colori in Potato
Configurazione di base
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
description è obbligatorio in ogni schema e compare sopra i pulsanti delle etichette come la consegna che l'annotatore legge, quindi deve indicare la decisione di etichettatura anziché ripetere il nome dello schema. Le etichette scritte come semplici stringhe prendono i colori dalla tavolozza di Potato nell'ordine in cui sono elencate.
Opzioni di configurazione
Etichette delle entità
L'insieme di etichette è la principale scelta di progettazione in un compito span, perché il recall, l'accordo e ogni misura successiva sono definiti rispetto a esso. Mantienilo abbastanza piccolo da permettere agli annotatori di ricordarlo senza consultare le linee guida a ogni span, il che in pratica significa da quattro a otto tipi per la maggior parte dei lavori di NER. Aggiungi le etichette allo schema precedente:
labels:
  - PERSON
  - ORGANIZATION
  - LOCATION
  - DATE
  - EVENT
Colori
Potato assegna a ogni etichetta un colore della tavolozza nell'ordine dell'elenco, quindi conviene scrivere i colori solo quando conta un abbinamento specifico, ad esempio per due tipi che compaiono spesso nella stessa frase e non devono essere facili da confondere a colpo d'occhio. Un colore appartiene all'etichetta:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - name: PERSON
        color: "#3b82f6"
      - name: ORGANIZATION
        color: "#10b981"
      - name: LOCATION
        color: "#f59e0b"
      - DATE
I valori sono esadecimali (#3b82f6) oppure rgb(255, 0, 0). Un'etichetta lasciata come semplice stringa, come DATE qui sopra, riceve il colore successivo della tavolozza, quindi uno schema può indicare i colori per le etichette che ne hanno bisogno e lasciare invariate le altre.
I colori di più schemi si possono anche impostare in un unico punto, sotto ui.label_colors, indicizzati per nome dello schema e poi per etichetta:
ui:
  label_colors:
    entities:
      PERSON: "#3b82f6"
      ORGANIZATION: "#10b981"
Una mappa colors: scritta nello schema stesso non è una chiave che Potato legge. Uno schema che la contiene viene visualizzato con i colori della tavolozza, come se il blocco non ci fosse.
Scorciatoie da tastiera
Conviene attivare le scorciatoie in qualsiasi compito span con più di due etichette, perché un annotatore che sposta il mouse su un pulsante per ogni span lavora a una frazione della velocità di chi tiene entrambe le mani sul testo. Impostando sequential_key_binding: true le etichette ricevono i tasti nell'ordine in cui sono elencate:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - DATE
  sequential_key_binding: true
Quando un compito ha più schemi nella pagina, Potato assegna a ciascuno i tasti da un gruppo separato, prendendo prima la riga dei numeri, poi la riga superiore delle lettere, poi la riga centrale, così le scorciatoie di schemi diversi non entrano mai in conflitto.
Per legare un'etichetta a un tasto preciso anziché alla sua posizione nell'elenco, assegnale un key_value. L'allocatore rispetta un key_value esplicito prima di assegnare qualsiasi tasto in automatico, e i tasti mnemonici resistono a un successivo riordino dell'elenco delle etichette, cosa che i tasti posizionali non fanno:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      key_value: "p"
    - name: ORGANIZATION
      key_value: "o"
    - LOCATION
  sequential_key_binding: true
Una mappa key_values: a livello di schema non viene letta, e nemmeno una mappa scritta come valore di sequential_key_binding, che Potato tratta solo come flag.
Tooltip
Il tooltip è il posto dei casi limite di un'etichetta, così un annotatore può verificare che cosa conta come ORGANIZATION senza lasciare il compito. I tooltip sono proprietà di ciascuna etichetta:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      tooltip: "Names of people, characters, or personas"
    - name: ORGANIZATION
      tooltip: "Companies, agencies, institutions"
    - name: LOCATION
      tooltip_file: "config/tooltips/location.html"
tooltip accetta testo semplice e tooltip_file accetta il percorso di un file HTML, che è la scelta migliore quando le indicazioni richiedono esempi, testo in grassetto o un elenco. Una mappa tooltips: a livello di schema viene letta solo da hierarchical_multiselect e non ha effetto su uno schema span.
Span sovrapposti
Consenti la sovrapposizione
Gli span possono sovrapporsi e nessuna impostazione attiva questo comportamento. La sovrapposizione serve quando un tratto di testo porta due etichette insieme, come in "Dr. Smith", che è sia PERSON sia ROLE. Dalla versione 2.9.0 viene accettata anche una selezione che inizia alla fine di uno span esistente o termina all'inizio di uno, quindi si possono creare span parzialmente sovrapposti. Le versioni precedenti rifiutavano quella selezione.
Disabilita la sovrapposizione (predefinito)
Lo schema span non ha una chiave che vieti la sovrapposizione, quindi un compito in cui gli span non devono mai sovrapporsi deve dirlo nelle proprie linee guida di annotazione. Quando la distinzione conta per l'esportazione più che per l'annotatore, due schemi span tengono separati gli insiemi di etichette, poiché ogni schema salva i propri span sotto il proprio nome:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: roles
    description: "Label professional roles"
    labels:
      - ROLE
Modalità di selezione degli span
Potato salva ogni span come offset di carattere nel testo dell'item, e nessuna chiave di configurazione fa passare la selezione dalla granularità di parola a quella di carattere. Le due modalità seguenti descrivono che cosa può fare un annotatore, non impostazioni da attivare.
Selezione a livello di parola
Trascinare su parole intere è ciò che la maggior parte del lavoro di NER comporta nella pratica, e il risultato viene salvato come offset di carattere del primo e dell'ultimo carattere selezionato. Nulla nella configurazione impone i confini di parola, quindi se per i tuoi dati contano span di parole intere, metti il requisito nelle linee guida e verificalo sull'esportazione invece di aspettarti che l'interfaccia rifiuti una parola parziale.
Selezione a livello di carattere
La selezione di parte di una parola è sempre disponibile e non richiede configurazione, ed è ciò su cui si basano i compiti morfologici e sotto il livello del token. Potato comprime le sequenze di spazi e tabulazioni prima del rendering, in modo che gli offset salvati corrispondano a ciò che misura il browser, e questo conta quando il testo contiene un'indentazione significativa. Dichiara instance_display quando lo spazio orizzontale deve essere conservato esattamente.
Span pre-annotati
Precaricare un compito con l'output di un modello trasforma l'etichettatura in correzione, che è il flusso di lavoro più rapido quando un modello ha già ragione sulla maggior parte del corpus. Potato legge le annotazioni iniziali da un campo di ciascun item, indicato da pre_annotation.field:
pre_annotation:
  enabled: true
  field: "predictions"
  allow_modification: true
  show_confidence: true
  highlight_low_confidence: 0.7
È allow_modification: true a fare del compito una correzione anziché una revisione, perché senza di esso gli annotatori non possono modificare ciò che il modello ha proposto. highlight_low_confidence: 0.7 segnala gli item su cui il modello era meno sicuro, così l'attenzione va agli span con maggiore probabilità di essere sbagliati.
Il campo contiene una voce per ogni nome di schema, e uno schema span accetta un elenco di offset:
{
  "id": "item_002",
  "text": "Apple announced new iPhone in California.",
  "predictions": {
    "entities": [
      {"start": 0, "end": 5, "label": "ORG", "confidence": 0.85},
      {"start": 27, "end": 37, "label": "LOC", "confidence": 0.91}
    ]
  }
}
Le pre-annotazioni sono un punto di partenza e non un'annotazione, quindi un item che nessuno apre viene esportato vuoto anche se è arrivato con le previsioni allegate.
Configurazioni NER comuni
NER standard (4 tipi)
L'insieme di quattro tipi segue la convenzione di CoNLL-2003, ed è la scelta giusta quando i risultati devono essere confrontabili con i valori NER pubblicati:
- annotation_type: span
  name: ner
  description: "Label named entities"
  labels:
    - PER    # Person
    - ORG    # Organization
    - LOC    # Location
    - MISC   # Miscellaneous
  sequential_key_binding: true
NER esteso (stile OntoNotes)
Diciotto tipi offrono distinzioni più fini a un costo reale in termini di accordo, perché i confini tra NORP, ORG e GPE sono il punto in cui gli annotatori sono più in disaccordo. Usa l'insieme esteso quando il lavoro a valle richiede queste distinzioni, e metti in conto una formazione più lunga:
- annotation_type: span
  name: ner_extended
  description: "Label named entities using the OntoNotes type set"
  labels:
    - PERSON
    - NORP        # Nationalities, religious/political groups
    - FAC         # Facilities
    - ORG
    - GPE         # Geopolitical entities
    - LOC
    - PRODUCT
    - EVENT
    - WORK_OF_ART
    - LAW
    - LANGUAGE
    - DATE
    - TIME
    - PERCENT
    - MONEY
    - QUANTITY
    - ORDINAL
    - CARDINAL
NER biomedico
Gli span biomedici sono lunghi e spesso annidati, quindi i tooltip con un esempio svolto per ogni tipo ripagano lo sforzo più qui che in un compito di dominio generale:
- annotation_type: span
  name: bio_ner
  description: "Label biomedical entities"
  labels:
    - GENE
    - PROTEIN
    - DISEASE
    - DRUG
    - SPECIES
NER per social media
I testi dei social media portano tipi di entità per cui gli insiemi pensati per le notizie di agenzia non hanno posto, e CREATIVE_WORK e GROUP sono i due che più spesso finiscono classificati per errore come ORG se non hanno un'etichetta propria:
- annotation_type: span
  name: social_ner
  description: "Label named entities in social media text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - PRODUCT
    - CREATIVE_WORK
    - GROUP
Span con attributi
Un secondo schema accanto allo schema span raccoglie un giudizio sull'item nel suo insieme. Potato salva i due separatamente, quindi la risposta radio si riferisce al documento e non a un singolo span:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: radio
    name: entity_type
    description: "What type of entity is this?"
    labels:
      - Named
      - Nominal
      - Pronominal
Schemi span multipli
Due schemi span permettono di annotare aspetti diversi dello stesso testo senza costringere gli annotatori a tenere a mente un unico insieme combinato di etichette. Ogni schema ha la propria riga di pulsanti, il proprio gruppo di tasti e il proprio campo nell'esportazione:
annotation_schemes:
  # Named entities
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION

  # Sentiment expressions
  - annotation_type: span
    name: sentiment_spans
    description: "Highlight sentiment expressions"
    labels:
      - POSITIVE
      - NEGATIVE
Annotazione span su più campi
Novità nella v2.1.0
L'annotazione span può puntare a un campo di testo specifico nei dati multi-campo tramite l'opzione target_field, che è ciò che serve quando un item contiene un documento sorgente e un riassunto e uno span appartiene a uno dei due.
Configurazione
Ogni schema indica il campo che annota, così i due insiemi di etichette restano collegati al testo giusto:
annotation_schemes:
  - annotation_type: span
    name: source_entities
    description: "Label entities in the source text"
    target_field: source_text
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: summary_entities
    description: "Label entities in the summary"
    target_field: summary
    labels:
      - PERSON
      - ORGANIZATION
Formato dei dati multi-campo
I dati devono includere i campi di testo separati:
{
  "id": "doc1",
  "source_text": "John Smith works at Microsoft in Seattle.",
  "summary": "Smith is employed by Microsoft."
}
Formato di output
Quando si usa target_field, le annotazioni sono indicizzate per campo:
{
  "id": "doc1",
  "source_entities": {
    "source_text": [
      {"start": 0, "end": 10, "text": "John Smith", "label": "PERSON"},
      {"start": 20, "end": 29, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  },
  "summary_entities": {
    "summary": [
      {"start": 0, "end": 5, "text": "Smith", "label": "PERSON"},
      {"start": 22, "end": 31, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  }
}
Per un esempio funzionante completo, consulta project-hub/simple_examples/simple-multi-span/ nel repository Potato.
Opzioni di visualizzazione
Mostra etichetta nello span
Per impostazione predefinita Potato mostra l'etichetta all'interno di ogni span evidenziato. In un documento denso con molti span brevi il testo delle etichette affolla la frase, e show_span_labels: false mantiene il testo leggibile mentre il colore dell'evidenziazione continua a indicare l'etichetta:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  show_span_labels: false
Stile a sottolineatura
Lo schema span non ha una chiave per lo stile di evidenziazione, e gli span vengono sempre mostrati con uno sfondo colorato. La sottolineatura e la resa tra parentesi sono opzioni del tipo coreferenza, tramite visual_display.highlight_mode, quindi un compito che richiede una delle due dovrebbe usare le Catene di coreferenza.
Formato di output
Le annotazioni span vengono salvate con offset di carattere:
{
  "id": "doc1",
  "entities": [
    {
      "start": 0,
      "end": 10,
      "text": "John Smith",
      "label": "PERSON"
    },
    {
      "start": 20,
      "end": 29,
      "text": "Microsoft",
      "label": "ORGANIZATION"
    }
  ]
}
Esempio completo: compito NER
item_properties indica i campi da cui Potato legge l'id dell'item e il suo testo, e una configurazione senza di esso non si avvia. I cinque tipi di entità ricevono i tasti della riga dei numeri tramite sequential_key_binding, e lo schema radio finale registra un giudizio di difficoltà utile in seguito per spiegare dove l'accordo è calato:
annotation_task_name: "Named Entity Recognition"

data_files:
  - data/documents.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight and label all named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
      - DATE
      - MONEY
    sequential_key_binding: true
    allow_discontinuous: false

  - annotation_type: radio
    name: difficulty
    description: "How difficult was this document to annotate?"
    labels:
      - Easy
      - Medium
      - Hard

output_annotation_dir: annotation_output
export_annotation_format: jsonl
Span discontinui
Novità nella v2.2.0
allow_discontinuous: true consente a un annotatore di selezionare più tratti di testo non adiacenti e registrarli come un unico span, che è ciò che richiedono gli antecedenti divisi e i costituenti discontinui. La discontinuità è una cosa diversa dalla sovrapposizione, e la chiave non ha effetto sulla possibilità che due span coprano gli stessi caratteri:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  allow_discontinuous: true
Con l'opzione attiva, un annotatore tiene premuto Ctrl su Windows e Linux, o Cmd su Mac, mentre seleziona altro testo da aggiungere allo span corrente. L'output contiene una coppia di inizio e fine per ogni segmento.
Integrazione con Entity Linking
Novità nella v2.2.0
Le annotazioni span possono essere collegate a basi di conoscenza esterne (Wikidata, UMLS o API REST personalizzate) aggiungendo un blocco entity_linking allo schema span. Il collegamento vale il passaggio in più per ogni span quando due entità condividono la stessa forma superficiale e l'etichetta da sola non basta a distinguerle:
- annotation_type: span
  name: entities
  description: "Highlight and link named entities"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
  entity_linking:
    enabled: true
    knowledge_bases:
      - name: wikidata
        type: wikidata
        language: en
    auto_search: true
    required: false
auto_search: true avvia la ricerca non appena viene creato uno span, risparmiando un clic nei compiti in cui la maggior parte degli span viene collegata. required: true impedisce di salvare uno span senza collegamento, quindi lascialo disattivato a meno che ogni entità dei tuoi dati non sia attesa nella base di conoscenza. Quando l'entity linking è abilitato, un'icona di collegamento appare nella barra di controllo di ogni span, e facendo clic su di essa si apre una finestra modale di ricerca. Consulta la documentazione di Entity Linking per i dettagli completi.
Buone pratiche
- Scrivi i colori sulle etichette che ne hanno bisogno e lascia il resto alla tavolozza
- Metti i casi limite in
tooltipotooltip_file, uno per etichetta, anziché nella descrizione dello schema - Attiva
sequential_key_bindingin ogni schema con più di due etichette, e aggiungikey_valuedove un tasto mnemonico aiuta - Stabilisci la regola sulla sovrapposizione nelle linee guida, poiché lo schema non ne impone nessuna
- Precarica con
pre_annotationper i flussi di lavoro di correzione, e mantieniallow_modification: true - Mantieni piccolo l'insieme di etichette e separa gli aspetti non correlati in schemi span distinti
Ulteriori letture
- Entity Linking - Collega gli span a basi di conoscenza
- Catene di coreferenza - Raggruppa le menzioni che si riferiscono alla stessa entità
- Annotazione di eventi - Strutture di eventi N-ari con argomenti span
- Span Linking - Crea relazioni tra span
- Visualizzazione delle istanze - Visualizzazione di contenuti multi-campo con target span
- Configurazione UI - Personalizza i colori degli span
- Funzionalità di produttività - Scorciatoie da tastiera
Per i dettagli di implementazione, consulta la documentazione sorgente.