Apprendimento Attivo
Riordina la coda di annotazione di Potato in base all'incertezza del modello, con cinque strategie di query, classificatori sklearn, gestione del cold start e persistenza del modello tra i riavvii.
L'apprendimento attivo riordina la coda di annotazione in modo che gli annotatori vedano le istanze su cui un modello è meno sicuro, invece di scorrere il corpus nell'ordine in cui è arrivato.
Come Funziona
- Raccogli un primo insieme di annotazioni
- Addestra un classificatore su ciò che è stato etichettato finora
- Valuta l'incertezza del pool non etichettato
- Riordina la coda per mettere in testa le istanze più incerte
- Annota le istanze prioritarie
- Riaddestra periodicamente man mano che le annotazioni si accumulano
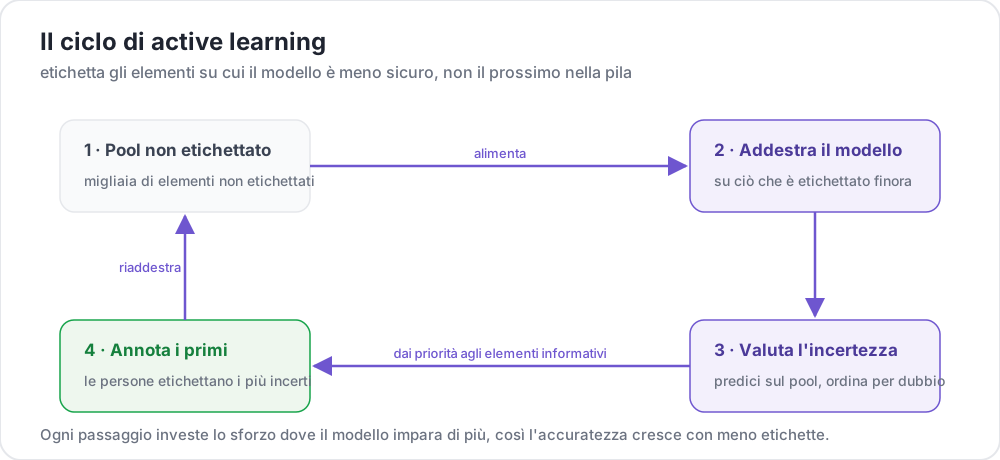 Investi lo sforzo di annotazione dove il modello impara di più
Configurazione
Impostazione di Base
active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000
min_instances_for_training vale 10 per impostazione predefinita e update_frequency vale 5. Entrambi i valori predefiniti sono abbastanza bassi da meritare di essere alzati in un progetto reale, perché riaddestrare ogni cinque annotazioni spende calcolo su un modello che è cambiato appena.
Configurazione Completa
active_learning:
  enabled: true

  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000

  # How disagreement between annotators resolves into one training label
  resolution_strategy: majority_vote

  # Fraction of the queue left in random order, so the model does not
  # only ever see what it already found interesting
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
I blocchi annidati classifier, vectorizer e model_persistence sono la forma documentata e quella che potato validate --strict riconosce. Le loro sottochiavi sono name e hyperparameters per i primi due, e enabled, save_directory e retention_count per il terzo. Un blocco che usa altri nomi di sottochiave viene ignorato senza avvisi, e l'esecuzione torna silenziosamente ai valori predefiniti.
Strategie di Query
| Strategia | Descrizione |
|---|---|
uncertainty | Istanze su cui il modello è meno sicuro. Il valore predefinito |
diversity | Istanze meno simili a ciò che è già stato annotato |
badge | Batch Active learning by Diverse Gradient Embeddings |
bald | Bayesian Active Learning by Disagreement |
hybrid | Una combinazione pesata di incertezza e diversità |
active_learning:
  query_strategy: uncertainty
Un nome di strategia non riconosciuto ripiega su uncertainty con un avviso invece di far fallire l'avvio, quindi controlla il log se una strategia sembra non avere alcun effetto.
Regolazione di Hybrid e BALD
hybrid usa per impostazione predefinita il 70% di incertezza e il 30% di diversità:
active_learning:
  query_strategy: hybrid
  hybrid_weights:
    uncertainty: 0.7
    diversity: 0.3
bald addestra un piccolo ensemble e ordina le istanze in base al disaccordo al suo interno:
active_learning:
  query_strategy: bald
  bald_params:
    n_estimators: 5
    bootstrap_fraction: 0.8
Classificatori
I classificatori si indicano con il loro percorso di import sklearn. Il valore predefinito è sklearn.linear_model.LogisticRegression.
| Classificatore | Percorso | Ideale Per | Velocità |
|---|---|---|---|
| Regressione logistica | sklearn.linear_model.LogisticRegression | La maggior parte dei compiti testuali | Veloce |
| Random forest | sklearn.ensemble.RandomForestClassifier | Pattern non lineari | Media |
| SVC | sklearn.svm.SVC | Dataset piccoli | Lenta |
| Multinomial NB | sklearn.naive_bayes.MultinomialNB | Classificazione testuale semplice | Molto veloce |
Regressione logistica, il punto di partenza consigliato:
active_learning:
  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000
Random forest, quando la decisione non è vicina a una funzione lineare:
active_learning:
  classifier:
    name: sklearn.ensemble.RandomForestClassifier
    hyperparameters:
      n_estimators: 100
      max_depth: 10
A un SVC va detto esplicitamente di produrre probabilità, perché il punteggio di incertezza dipende da esse:
active_learning:
  classifier:
    name: sklearn.svm.SVC
    hyperparameters:
      kernel: rbf
      probability: true
Naive Bayes, quando la velocità conta più dell'ultimo punto di accuratezza:
active_learning:
  classifier:
    name: sklearn.naive_bayes.MultinomialNB
    hyperparameters:
      alpha: 1.0
calibrate_probabilities è attivo per impostazione predefinita. È importante perché il campionamento per incertezza ordina in base alla probabilità prevista, e un classificatore non calibrato tratta gli elementi su cui sbaglia con sicurezza come se fossero già risolti.
Vettorizzatori
Il valore predefinito è sklearn.feature_extraction.text.TfidfVectorizer.
TF-IDF, feature pesate:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]
      stop_words: english
Conteggi semplici:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.CountVectorizer
    hyperparameters:
      max_features: 3000
      ngram_range: [1, 1]
Hashing, per un vocabolario troppo grande da tenere in memoria:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.HashingVectorizer
    hyperparameters:
      n_features: 10000
ngram_range si scrive come lista YAML e viene convertito nella tupla che sklearn si aspetta, quindi [1, 2] è corretto qui e non richiede alcuna sintassi speciale.
Cold Start
Prima che esista un modello non c'è nulla su cui essere incerti, quindi il primo batch viene scelto senza modello:
active_learning:
  cold_start_strategy: random
  cold_start_batch_size: 20
Selezione Assistita da LLM
Un LLM può assegnare un punteggio alle istanze durante il periodo di cold start o in affiancamento al classificatore:
active_learning:
  enabled: true
  schema_names:
    - sentiment

  llm:
    enabled: true
    endpoint_type: vllm
    base_url: http://localhost:8000/v1
    model: meta-llama/Llama-3.2-3B-Instruct
    confidence_method: verbalized
confidence_method stabilisce come si ottiene il punteggio di confidenza, e la scelta conta perché è quel punteggio a guidare la selezione:
| Metodo | Come funziona | Compromesso |
|---|---|---|
verbalized | Il modello dichiara la propria confidenza su una scala da 1 a 10 | Universale, ma inaffidabile con alcuni modelli |
logprobs | Calcolato dalle log-probabilità dei token | Il meglio calibrato, richiede un endpoint che restituisca i logprobs |
consistency | La stessa istanza viene interrogata più volte e valutata in base all'accordo tra le risposte | Funziona ovunque, al costo di N chiamate per istanza |
logprobs ripiega sulla confidenza verbalizzata quando l'endpoint non li restituisce.
Persistenza del Modello
I modelli addestrati possono sopravvivere a un riavvio invece di essere ricostruiti da zero:
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
retention_count vale 2 per impostazione predefinita e limita quanti modelli salvati vengono conservati.
La persistenza su database non è più configurabile. Le chiavi database_enabled e database_config sono state rimosse perché lo strato dietro di esse era uno stub che registrava un successo e non salvava nulla. La cronologia delle esecuzioni ora viene sempre registrata e non richiede configurazione, ed entrambe le chiavi vengono ignorate se una configurazione le contiene ancora.
Schemi Multipli
schema_names elenca gli schemi le cui annotazioni addestrano il modello. Se non è impostato, usa per impostazione predefinita gli schemi etichettabili del progetto:
annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels: [Positive, Negative, Neutral]

  - annotation_type: radio
    name: topic
    description: "What is the topic?"
    labels: [Politics, Sports, Tech, Entertainment]

active_learning:
  enabled: true
  schema_names:
    - sentiment
    - topic
Configurazione Completa
annotation_task_name: "Sentiment Analysis with Active Learning"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 30
  update_frequency: 50
  max_instances_to_reorder: 500
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5

output_annotation_dir: "output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Combinazione con il Supporto AI
L'apprendimento attivo decide cosa mostrare dopo. Il supporto AI aiuta l'annotatore con ciò che è sullo schermo. Sono indipendenti e si combinano:
active_learning:
  enabled: true
  schema_names:
    - sentiment
  min_instances_for_training: 30

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true
Leggi il risultato con cautela. Se il modello suggerisce un'etichetta e l'annotatore la accetta, e la stessa famiglia di modelli ha scelto l'istanza, l'accordo che misuri alla fine è in parte il modello che concorda con se stesso.
Monitoraggio
La dashboard di amministrazione riporta l'accuratezza del modello, il numero di cicli di addestramento, la distribuzione dell'incertezza e quante istanze restano. Per accedervi serve la chiave di amministrazione o un ruolo che abbia view_admin_dashboard.
Best Practice
Raccogli Prima una Base
Non si può addestrare nulla su un insieme vuoto, e un modello addestrato su venti annotazioni riordina soprattutto rumore:
active_learning:
  min_instances_for_training: 50
Controlla il Bilanciamento delle Classi
Il campionamento per incertezza si concentra sul confine di decisione, e questo allontana la distribuzione delle etichette da quella del corpus. Per addestrare un modello va bene, ma è fuorviante se presenti il campione annotato come una descrizione dei dati. random_sample_percent mantiene non distorta una parte della coda proprio per questo motivo.
Non Riaddestrare Troppo Spesso
active_learning:
  update_frequency: 100
Conserva i Modelli tra i Riavvii
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
Risoluzione dei Problemi
L'addestramento non parte mai
Verifica che le annotazioni abbiano raggiunto min_instances_for_training e che ogni classe abbia almeno un esempio. Con un insieme di addestramento a una sola classe non si può addestrare un classificatore.
Il riordinamento sembra non avere effetto
Cerca nel log una query_strategy sconosciuta, che ripiega silenziosamente sull'incertezza. Verifica che sia impostato enabled: true e che schema_names nomini schemi che esistono davvero.
Lentezza con un pool grande
Riduci max_instances_to_reorder, aumenta update_frequency o passa a HashingVectorizer per un vocabolario molto grande.
Ulteriori Letture
- Supporto AI - Assistenza LLM durante l'annotazione
- Assegnazione Compiti - Le altre strategie di assegnazione
- Dashboard di Amministrazione - Monitorare il ciclo di addestramento
- Ordinamento per Diversità - Ordinamento basato su embedding senza classificatore
Per i dettagli di implementazione, consulta la documentazione sorgente.