把校準會議裝上儀表
標註團隊本來就在開規範化會議,也一直想知道標註者是怎麼想的。多人協作房間用即時一致性指標度量校準會議;Think-Aloud 模式在本地記錄出聲推理,全程不需要 LLM。
有兩件事,每個標註團隊都做得不好,因為工具幫不上忙:一是校準會議,它在螢幕共享裡發生,不留下任何痕跡;二是弄清標註者為什麼選了某個標籤,這通常退化成一個沒人填的自由文本框。Potato 2.7 給這兩件事都裝上了儀表:一個帶即時一致性指標的規範化協作房間,以及一個在本地跑語音轉文字的出聲思考記錄器。 兩者都不需要 LLM。
規範化會議
如果你帶過兩人以上的標註項目,你就開過規範化會議。所有人標同樣的幾條資料,然後大家上線開會,就分歧爭論一番,最後在標註指南到底是什麼意思上達成一致。
這套做法有效,但完全沒有儀表。人們在討論之前持有的判斷消失了。誰改變了主意,以及改主意是因為被說服還是因為資深同事先發了言,也都消失了。至於這場會議究竟有沒有提升一致性,沒人答得上來,因為沒人測過。
多人協作房間把這樣的會議搬進工具裡。
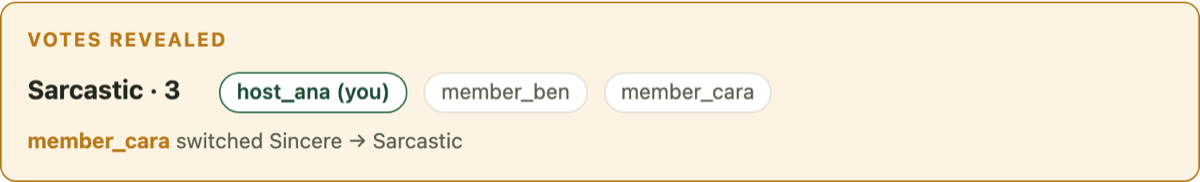 會議進行中的規範化房間
rooms:
  enabled: true
  who_can_create: any
  persist_votes: true
  schema: sarcasm
開啟 /rooms 建立一個房間,它會得到一個六位字母的房間碼,你可以在通話裡念出來。整個流程是刻意設計的:
- 所有人盲投。 成員能看到誰投過票,但永遠看不到投了什麼。這一點由服務端強制執行,因此第一印象是真正獨立的。
- 主持人揭曉。 這一刻,盲投結果就固定下來,不可更改。
- 大家討論,在側邊聊天框裡或在你們的通話中。
- 任何人都可以改票。 揭曉之後的每一次改動都會記錄下來,包括從什麼改成什麼,以及當時的多數意見是什麼。
揭曉之後的改票和一次投票不是同一類事件;它是在已知多數意見的情況下發生的改變。把它記錄下來,你就得到了一份逐人的從眾記錄,也就能注意到某位標註者每一次都會倒向多數。在你把他們的一致性當作獨立證據之前,這一點值得知道。
一致性指標
Krippendorff's α 會在已揭曉的資料上即時計算兩次:一次基於盲投,一次基於當前投票。兩者之間的差距就是這場會議的規範化增益,並且會在會議進行時顯示在螢幕上。
如果一小時的討論把 α 從 0.61 推到 0.78,這一小時買到了東西。如果只從 0.61 挪到 0.62,那麼分歧出在標註指南本身而不是理解方式上,再談下去也解決不了。去把指南重寫一遍。
有兩種變體值得了解。碰頭房間會直接用團隊當前存在分歧的資料來填充房間,這些資料是從標註狀態即時算出來的,因此它相當於一個同步版的裁定流程。旁觀房間讓新人即時觀摩資深標註者工作,連他們正在高亮哪一段文本都能看到。這是最接近於坐在別人旁邊看他們標註的體驗。
房間採用事件溯源寫入 JSONL 日誌,因此一個正在進行的房間能挺過伺服器重啟,而這份日誌同時也是本次會議的審計軌跡。整個過程不涉及 WebSocket;客戶端用游標輪詢,這意味著房間在任何 WSGI 部署下都能工作。
理由
另一個缺口是理由。多數工具提供一個自由文本框,而多數標註者在裡面寫"顯而易見",或者乾脆不寫。
把推理寫出來比在腦中想一遍要慢得多,而當任務長達 400 條時,理由框是第一個被放棄的東西。
Think-Aloud 模式通過換一種模態來消除這層阻力:標註者一邊工作,一邊直接說出來。
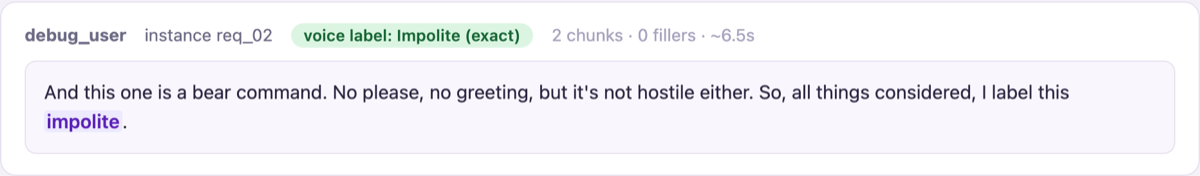 Think-Aloud,附帶檢測到的標籤
thinkaloud:
  enabled: true
  schema: politeness
  model: tiny.en
語音轉文字通過 faster-whisper 在本地執行,用 39 MB 的 tiny.en 模型即可在 CPU 上達到即時速度。音訊不會離開這臺機器,既不需要呼叫雲端介面,也不產生按 token 計費的賬單。對很多敏感資料來說,這就是"我們能用"和"法務不批"之間的區別。
早在這一切被計算化之前,出聲思考法就已經是研究人如何做決策的標準方法。它一直沒有進入標註工具,因為讓人對著錄音裝置敘述、再手工轉寫,不是任何人能長期堅持的工作流。
逐字轉寫稿
轉寫稿完全按說出來的樣子儲存,並刻意不做摘要,因為對出聲思考記錄做轉述會汙染這份材料。那些遲疑、自我更正、"嗯,它可能是諷刺,不過……"——這些正是資料本身。把它整理成一份乾淨的摘要,得到的是另一種、也遠沒那麼有用的東西。
標註者還可以用語音提交標籤,使用一套由規則解析器識別的固定說法:
- "I label this Polite"
- "My answer is impolite"
- "Final answer: neutral"
只有這些說法會觸發提交。在思考過程中說的一切都會被忽略,這正是規則解析器足夠用的原因。整條流水線裡沒有任何 LLM,也沒有任何模型來判斷你是什麼意思。之後再說一個新的短語,以最後一次提交為準。
你還會得到確定性的遲疑訊號(靜音片段計數、填充詞計數),它們是用算術算出來的,不依賴模型。在某條資料上停頓很久,是難度的一個不錯的代理指標,而採集它不花任何成本。
人與模型的思維鏈
Think-Aloud 是一個人類思維鏈記錄器。它捕捉的是一個人實際推理到某個標籤的過程:不是事後寫下的整理版說明,而是推理發生時的樣子,連中途走岔的部分都在。
Potato 的過程獎勵標註對模型做同樣的事:把模型的思維鏈切分開,並逐步打分。
同一條資料,兩條思維鏈,一條來自人,一條來自模型。你可以把它們並排放在一起,看看推理在哪裡分道揚鑣。這種配對是構建更好的過程獎勵資料的原材料,因為"模型因為錯誤的理由得出了正確答案"正是隻看最終答案的評分看不見的失敗。
Potato 提供兩種採集介面,但不會替你計算兩者之間的差異。那是一個研究問題而不是一項功能,我們寧可把材料交到你手上,也不願給你一個我們自己編出來的指標。