评估语音与视频智能体
在 Potato 中对语音、视频和文档智能体进行人工评估,涵盖轮流发言时间线、实时 IoU 和语音错误标签。
会说话、看视频、读文档的智能体,其错误是文本框无法呈现的,因此每种模态都需要一个为其量身定制的审查界面。语音智能体的失误出现在回合之间,视频智能体的答案是一个时间区间而不是一句话,文档智能体的错误则是读错的表格单元格。
Potato 为这些智能体新增了五种标注方案,本文将它们归为四类界面。语音(voice_interaction)、视频(temporal_grounding)和语音转写(speech_transcript)各有一种方案,文档使用两种,其中 table_grid 用于单元格结构,multimodal_reasoning 用于推理轨迹。它们与 Potato 已有的图像和音频展示并列,完整参考见多模态智能体评估。
 一个普通文本控件无法表达一次打断、一个事件区间或一个表格单元格
双轨语音时间线上的轮流发言
口语智能体会在回合边界出问题,例如打断用户、与用户抢话,或停顿太久以至于用户放弃。voice_interaction 方案把对话排布成双轨时间线,包含一条用户轨道和一条智能体轨道,并高亮双方同时说话的重叠区域(打断,barge-in)(Full-Duplex-Bench,2025)。你对每一处重叠分类,并为整体的轮流发言打分,提供音频时会内嵌播放。
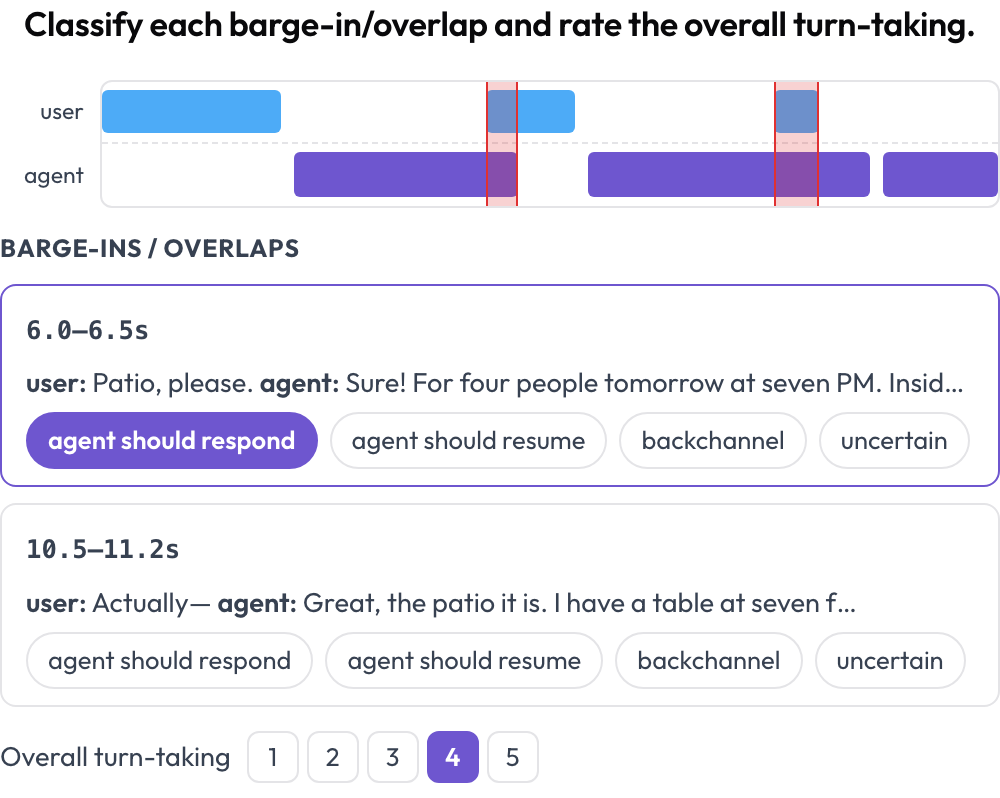 带打断检测与轮流发言评分的双轨语音时间线
annotation_schemes:
  - annotation_type: voice_interaction
    name: turn_taking
    description: "Classify each barge-in/overlap and rate the overall turn-taking."
    turns_key: turns
    speaker_key: speaker
    user_speakers: [user, human, caller]
    overlap_labels: [agent_should_respond, agent_should_resume, backchannel, uncertain]
    rating_scale: 5
Potato 在渲染时根据回合的时序计算重叠区域。因此,一段会被扁平转录压缩成“他们都说了些话”的全双工对话,会变成一组可以逐个打标签的具体时刻。
用实时 IoU 为时间定位打分
视频智能体对“进球发生在什么时候?”的回答是一个区间,所以你也按区间来打分。temporal_grounding 方案提供一个拖动条,你可以通过捕捉播放头或输入秒数,为每个事件提示标出黄金的 [start, end] 区间。当数据带有模型的预测区间时,实时的交并比(IoU)和一条双条迷你时间线会随着你调整边界而更新(TimeScope,2025)。
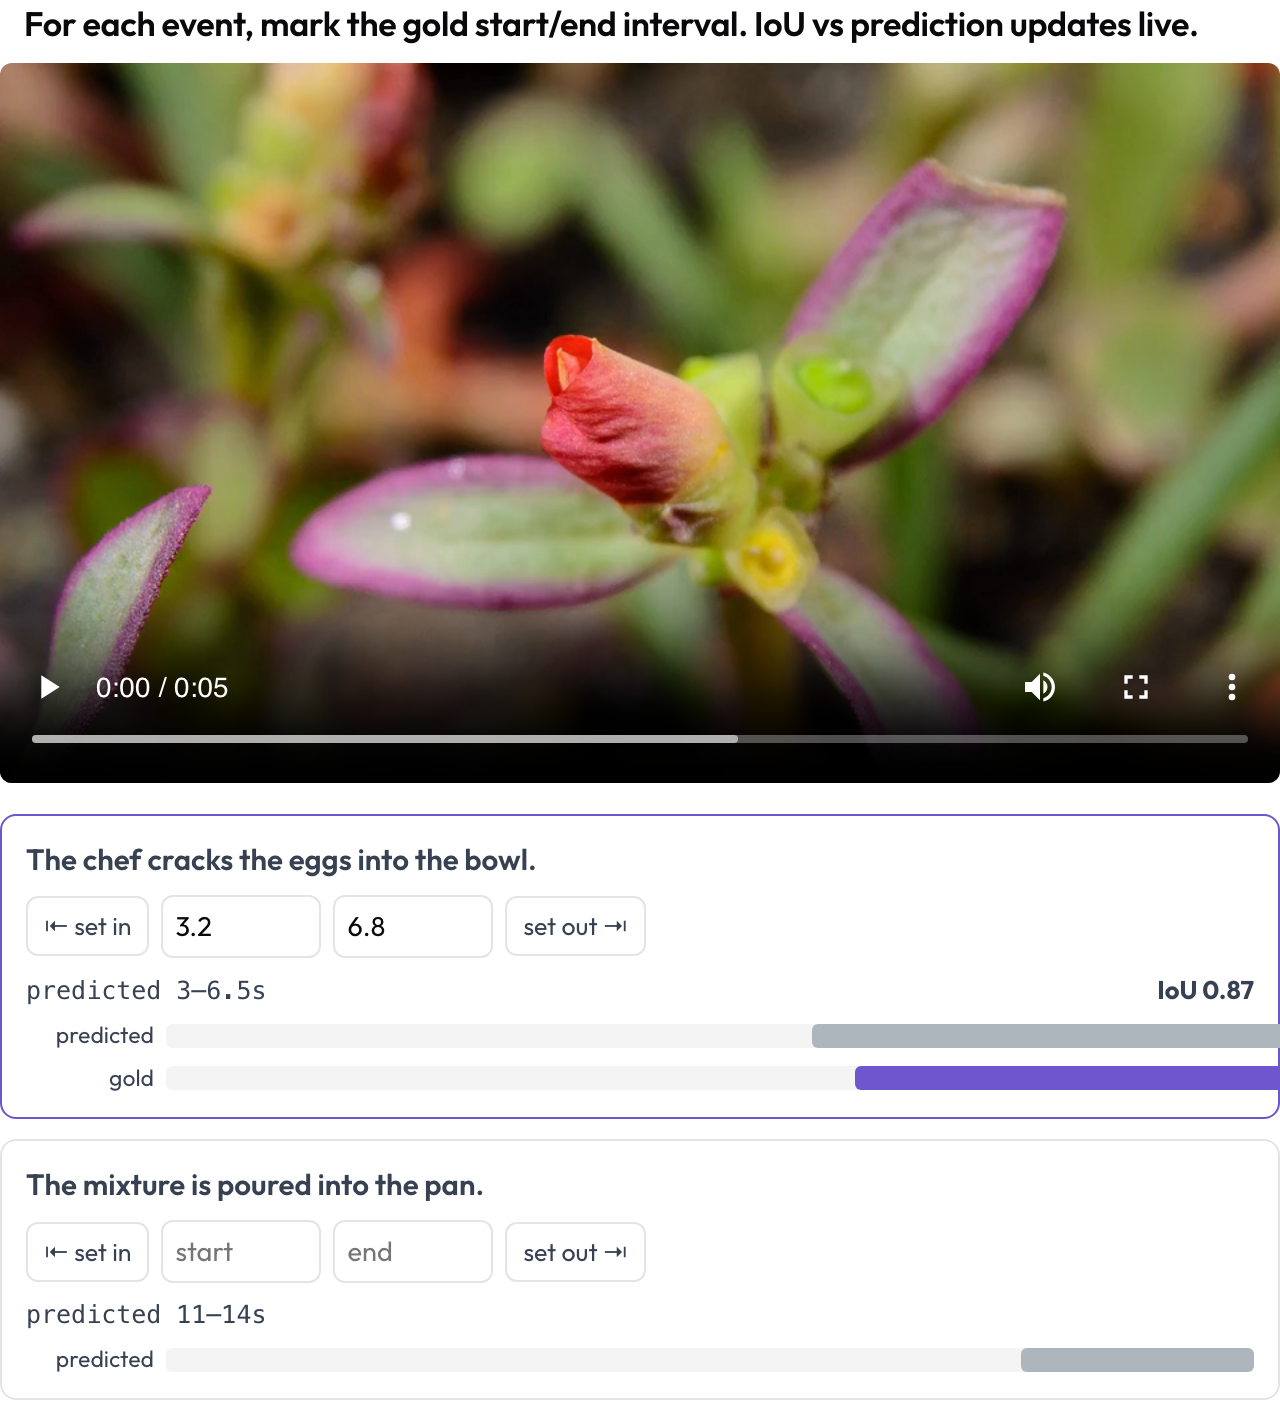 在视频上标出黄金事件区间,并实时显示相对模型预测的 IoU
annotation_schemes:
  - annotation_type: temporal_grounding
    name: grounding
    description: "Mark the gold start/end interval for each event. IoU vs prediction updates live."
    video_key: video
    events_key: events
这种方案是为“预测对比黄金”的定位而设计的,与一般的片段标注是不同的工作。你要评判的是模型给出的跨度离真实值有多近,而拖动边界时看着 IoU 变化,会让这段距离一目了然。
语音转写、推理轨迹和文档表格
另有三种方案覆盖语音和文档。
- 语音转写(
speech_transcript):每个时间对齐的片段是一张卡片,你可以在上面标记自动语音识别(ASR)和语音合成(TTS)的错误、发音错误和不流畅,并就地修正文本。同样的标记方式也适用于非母语语音,Speak & Improve Corpus 2025 发布了带人工转写和错误标签的此类语音,可用于二语学习者英语的 ASR 和不流畅检测研究。片段层级的视图是对轮流发言时间线的补充。 - 交错推理(
multimodal_reasoning):一条文本-图像-工具的轨迹会渲染成带类型的块。你为每一步的连贯性打分,并标记视觉幻觉,即推理与图像不相符的步骤(Multimodal RewardBench 2,2025)。 - 文档表格(
table_grid):你设定网格尺寸,并点击单元格标出其角色(数据、列表头、行表头或空)。网格能捕捉边界框无法表达的结构。
speech_transcript 的配置设定了四种错误标签,并允许修正。
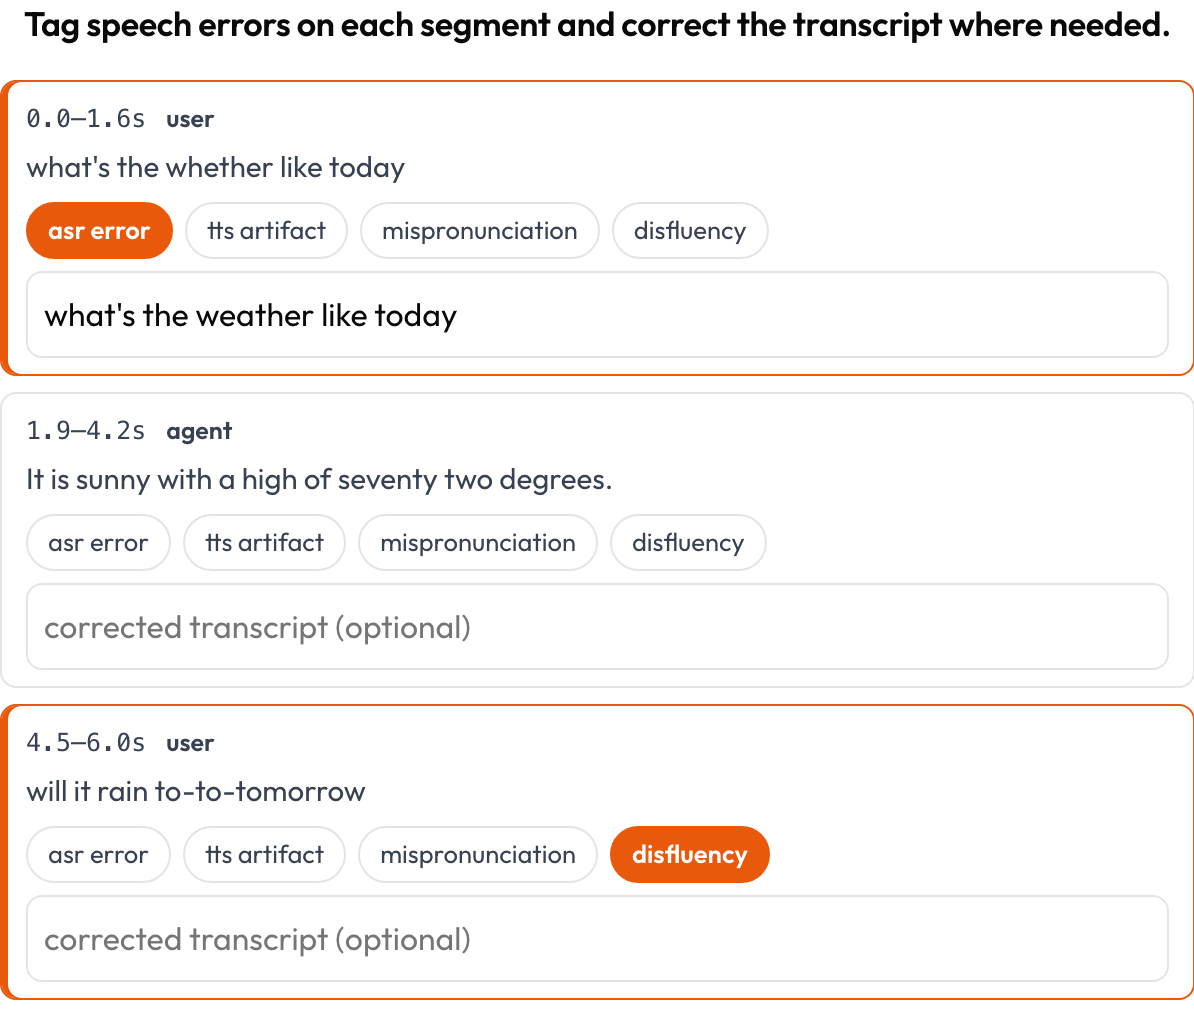 为每个片段标记 ASR、TTS 和发音错误,并就地修正转写文本
annotation_schemes:
  - annotation_type: speech_transcript
    name: speech_errors
    description: "Tag speech errors on each segment and correct the transcript where needed."
    segments_key: segments
    error_types: [asr_error, tts_artifact, mispronunciation, disfluency]
    allow_correction: true
其中几种方案可以在同一个任务上运行,因此一次文档智能体的运行可以同时被评分表格结构和推理连贯性。
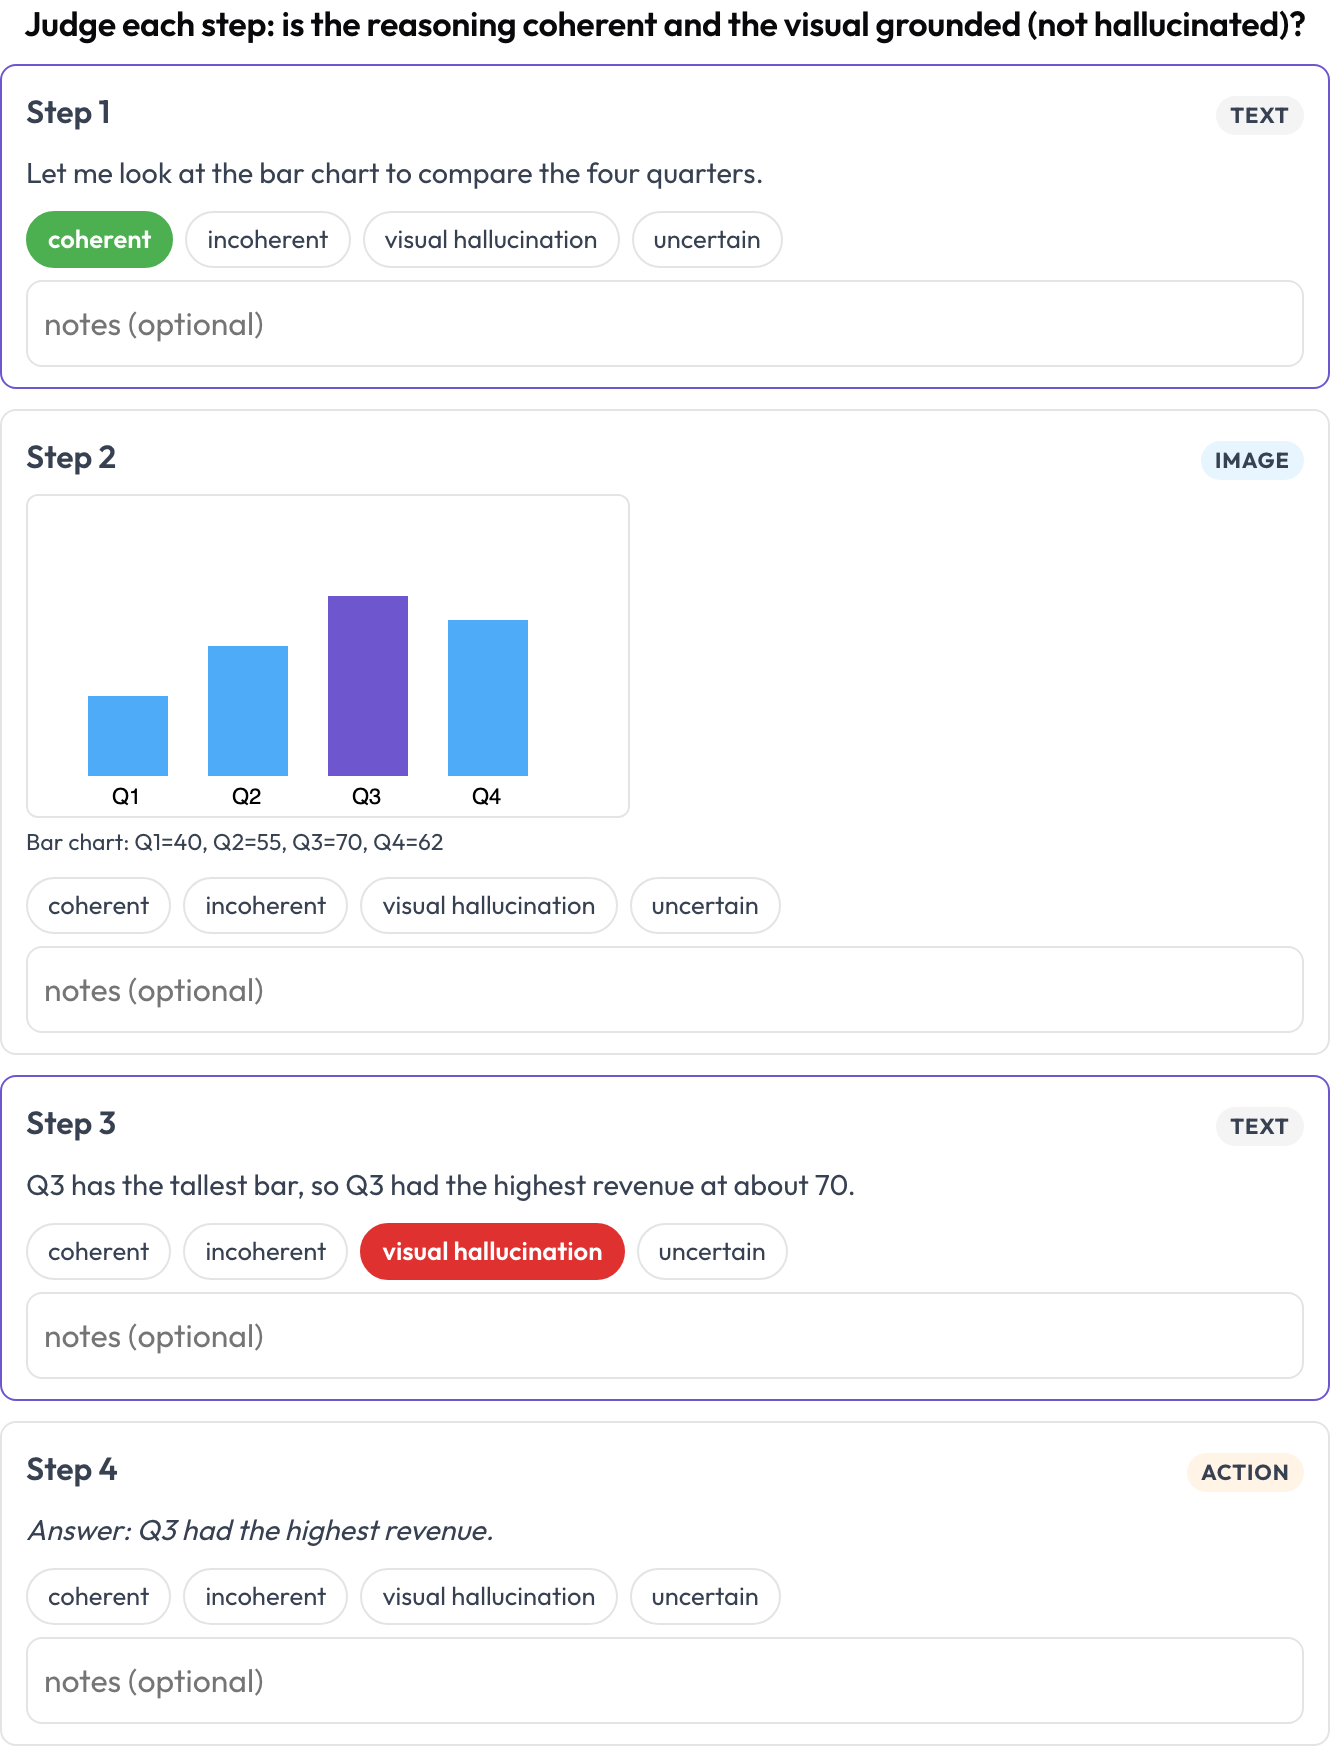 为一条文本-图像-工具推理轨迹的每一步评判连贯性与视觉幻觉
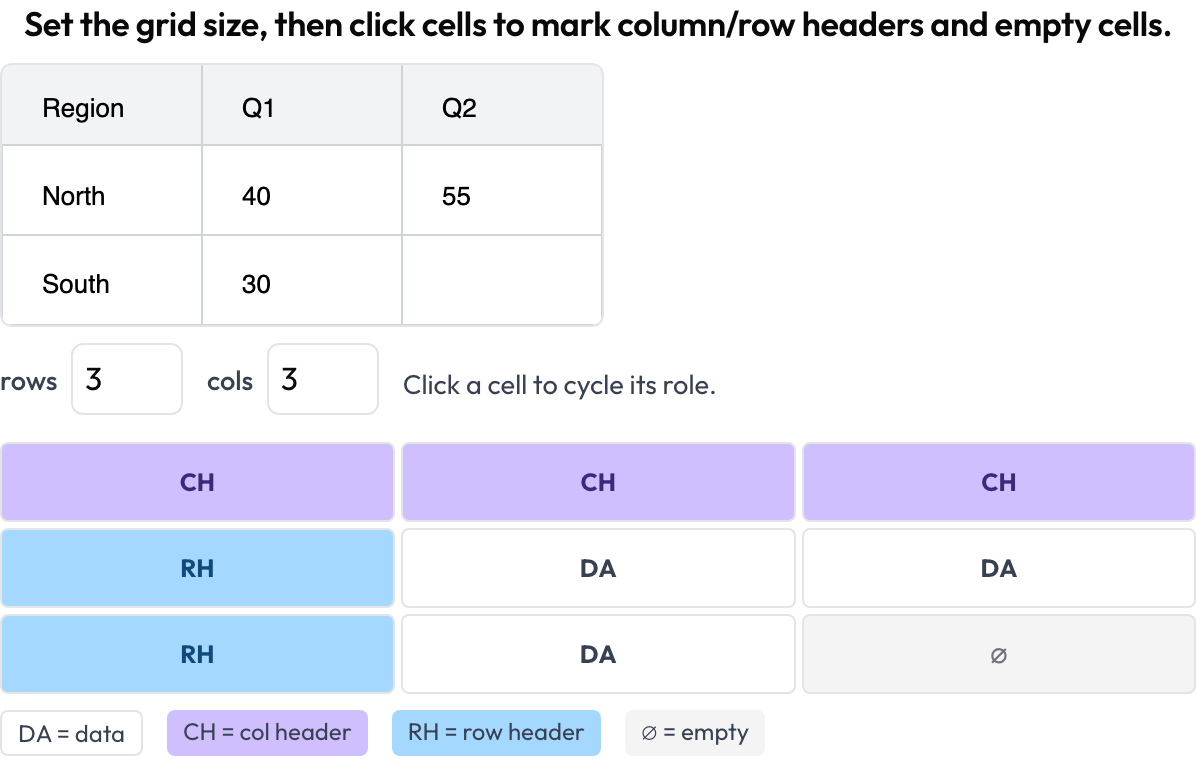 标注文档表格的单元格结构:列表头、行表头、数据和空单元格
运行示例项目
每个界面都在 Potato 仓库的 examples/agent-traces/ 下附带一个可运行的示例。这些示例不在 PyPI 包中,因此下面的命令会克隆仓库,并在 8000 端口运行时间定位示例。
git clone https://github.com/davidjurgens/potato.git
cd potato && pip install -r requirements.txt
python potato/flask_server.py start examples/agent-traces/temporal-grounding/config.yaml -p 8000
你自己的数据提供带时间戳的回合、片段或事件,每种界面会在渲染时从中推导出自己的时间线。对于 GUI 和操作系统智能体,配套的文章是评估计算机操作智能体。
延伸阅读
- 多模态智能体评估,完整的方案参考
- 评估计算机操作与多模态智能体,带方案选择表的指南
- 逐步评估计算机操作智能体,多模态界面中 GUI 与操作系统的部分
- Potato 2.6.2:一套完整的开源智能体评估工具,2.6.x 系列的全部内容
参考文献
Guan-Ting Lin et al. (2025). Full-Duplex-Bench: A Benchmark to Evaluate Full-duplex Spoken Dialogue Models on Turn-taking Capabilities. arXiv preprint arXiv:2503.04721. https://arxiv.org/abs/2503.04721
Xiangrui Liu et al. (2025). TimeScope: Towards Task-Oriented Temporal Grounding In Long Videos. arXiv preprint arXiv:2509.26360. https://arxiv.org/abs/2509.26360
Kate Knill et al. (2024). Speak & Improve Corpus 2025: an L2 English Speech Corpus for Language Assessment and Feedback. arXiv preprint arXiv:2412.11986. https://arxiv.org/abs/2412.11986
Yushi Hu et al. (2025). Multimodal RewardBench 2: Evaluating Omni Reward Models for Interleaved Text and Image. arXiv preprint arXiv:2512.16899. https://arxiv.org/abs/2512.16899