除錯多智慧體失敗:一次實戰演練
如何用 Potato 找出一個多智慧體 LLM 系統失敗的原因:互動圖、失敗歸因、交接審查、每個智慧體的記分卡、工具爭用時間線和湧現行為標記。
當一個智慧體團隊失敗時,難點不在於察覺到失敗——而在於找出是哪個智慧體在哪一步導致了它,以及真正的問題是不是兩個各自表現都沒問題的智慧體之間一次糟糕的交接。這篇演練會按照你在一次出問題的執行上實際會用到的順序,走完 Potato 為此打造的六個介面。 這裡的一切都用 YAML 配置,並執行在你自己的伺服器上;完整的方案參考見 多智慧體團隊評估。
一個 多智慧體系統 是若干個角色各異的 LLM 智慧體——一個規劃者、一個編碼者、一個審查者——彼此傳遞訊息並交接控制權。關於這些系統為何會出問題的研究,即 MAST 分類法(Why Do Multi-Agent LLM Systems Fail?)發現,大多數失敗都發生在智慧體之間:某個約束在交接處被丟掉,一個團隊從不核驗自己的工作,多個智慧體各說各話。一份扁平的聊天記錄恰恰會把這些藏起來,因為出錯的東西就活在兩條訊息之間的空隙裡,而不在任何一條訊息內部。
 失敗發生在智慧體之間、在交接處,而不在某一份記錄內部
我怎麼看清一次多智慧體執行的結構?
先從執行的形狀入手,而不是文本。agent_interaction_graph 方案把整次執行渲染為一張有向圖:節點是智慧體,邊是它們之間的交接,越粗的邊表示流量越大。你點選一個節點把它標在關鍵路徑上,點選一條邊讓它在正常、關鍵、有問題之間迴圈切換。
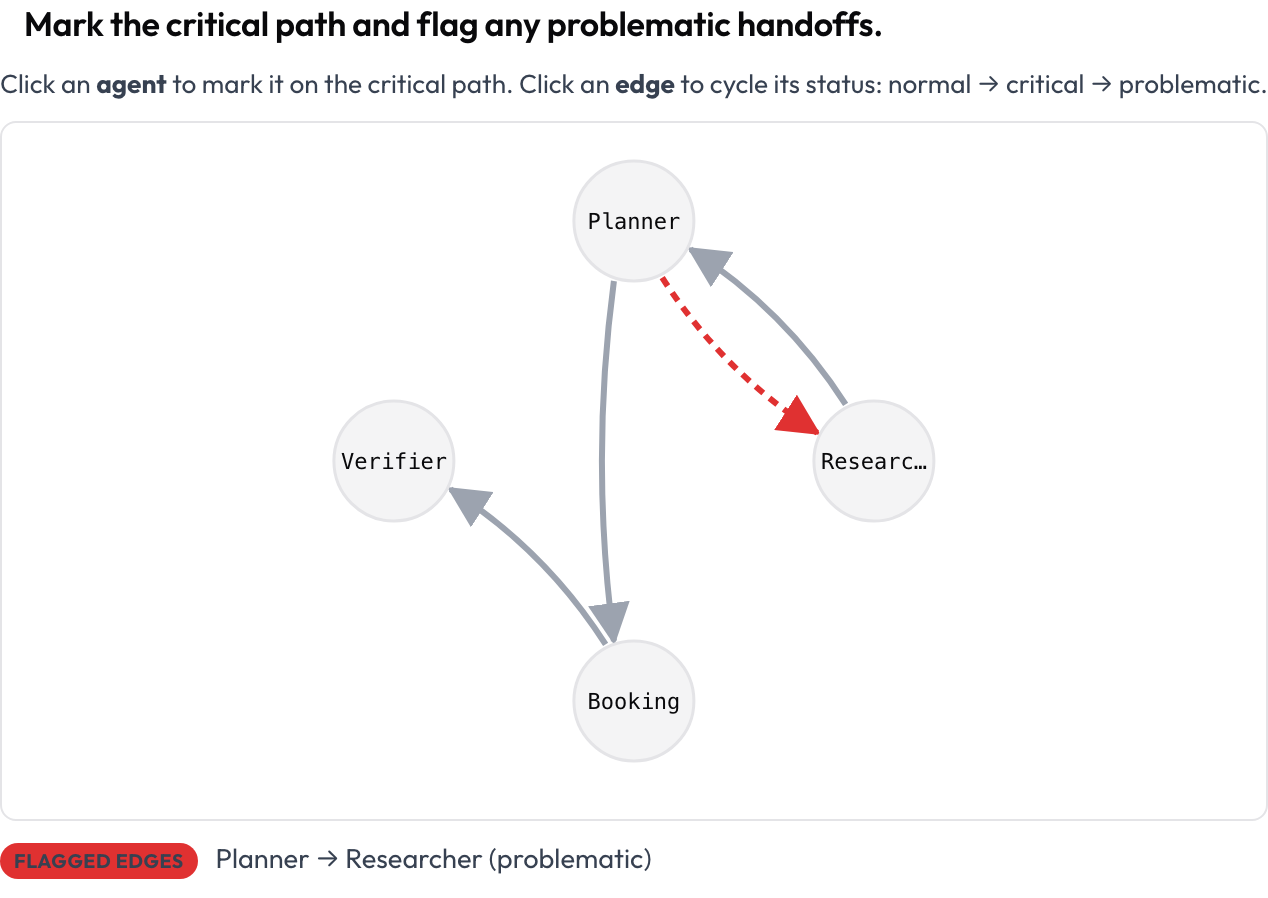 標出關鍵路徑並標記有問題的交接
annotation_schemes:
  - annotation_type: agent_interaction_graph
    name: graph
    description: "Mark the critical path and flag any problematic handoffs."
    steps_key: steps
    agent_key: agent
這張圖是根據軌跡自動佈局的,所以你什麼都不用畫。每個節點和邊都可用鍵盤聚焦,並有一段文字摘要列出關鍵節點和被標記的邊,因此其含義從不只靠顏色來傳達。這個檢視是回答“誰和誰通訊了,路徑在哪裡跑偏了”的最快方式。
我怎麼把一次多智慧體失敗歸因到某一個智慧體?
一旦你能看清這次執行,就把失敗釘死。failure_attribution 方案要求給出失敗歸因文獻裡的那個三元組(Zhang 等人,Which Agent Causes Task Failures and When?,ICML 2025,Who&When 資料集):該負責的智慧體、決定性的步驟和原因。智慧體下拉框和步驟選擇器由軌跡自身的回合填充,所以你只能把失敗歸因到確實發生過的某個智慧體和某一步。
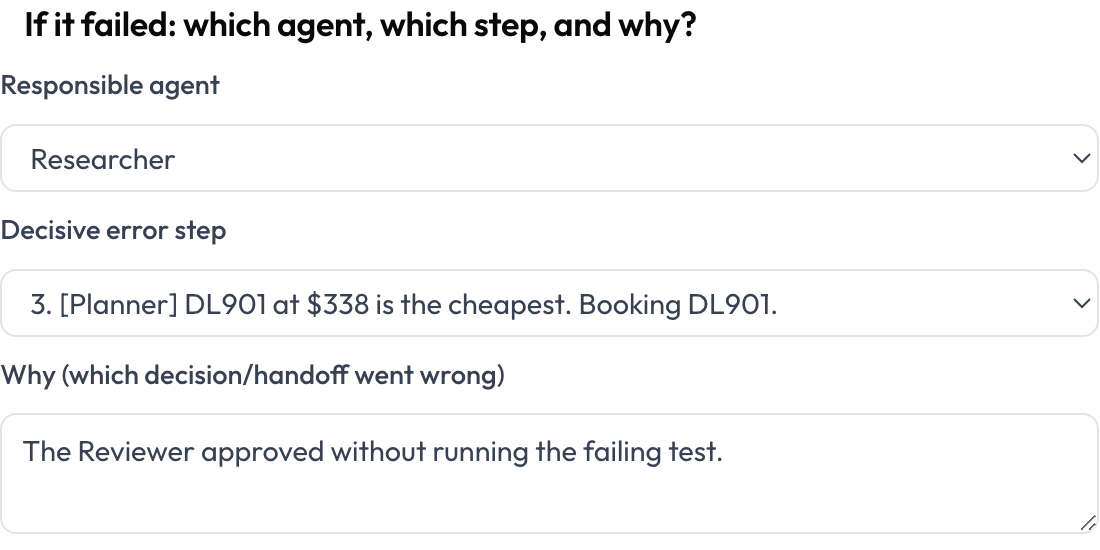 把失敗歸因到該負責的智慧體、決定性的步驟以及原因
annotation_schemes:
  - annotation_type: radio
    name: outcome
    description: "Did the system succeed?"
    labels: [success, failure]
  - annotation_type: failure_attribution
    name: attribution
    description: "If it failed: which agent, which step, and why?"
    steps_key: steps
    agent_key: agent
把歸因和一個成功/失敗的單選搭配起來,意味著這個三元組只在失敗的執行上收集,這讓標註者把時間花在帶有訊號的案例上。
那些交接本身呢?
歸因點出一個決定性步驟。交接審查則看每一次控制權轉移。只要執行的智慧體在兩個連續回合之間發生變化,Potato 就會發出一張交接卡片 A → B,你在這一遍裡標記出錯的地方——資訊丟失、約束被丟、內容被攪亂、目標漂移——並給品質打分。這些失敗模式來自 MAST 的智慧體間類別和“回聲”現象(Zhang 等人,2025)。
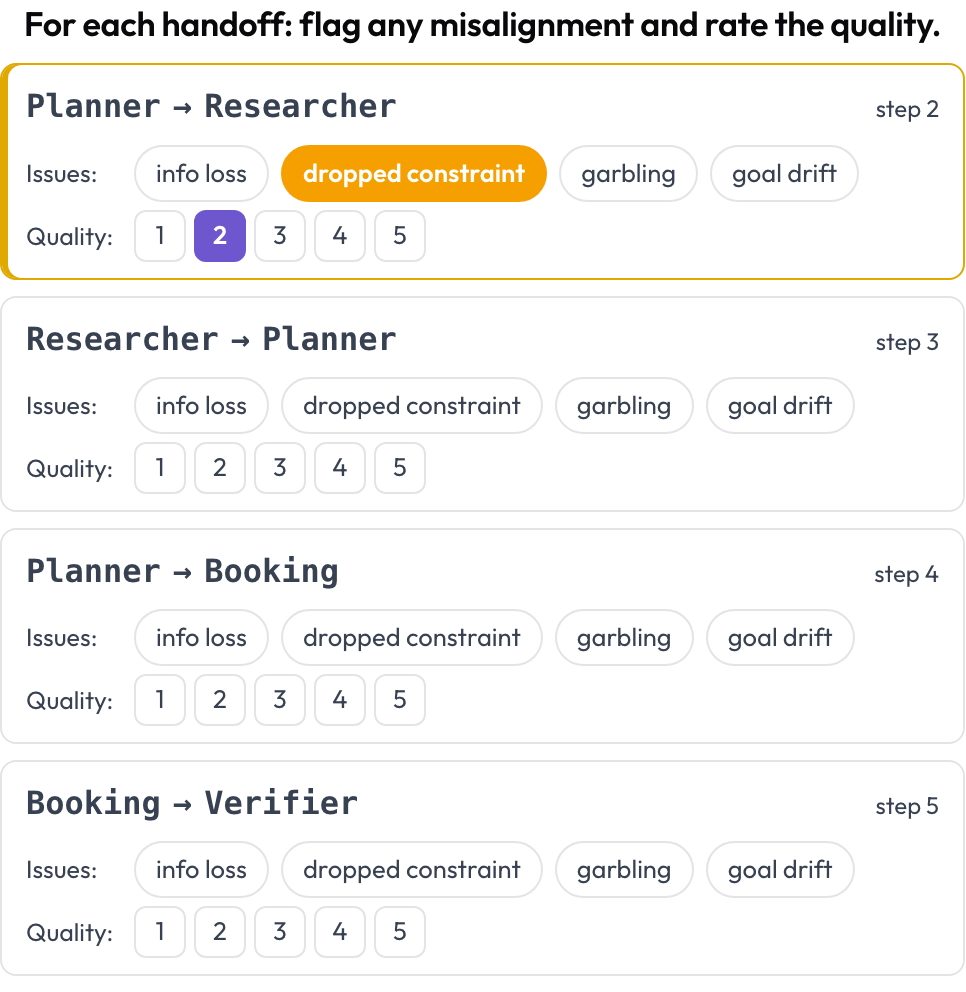 在每一次交接上標記智慧體間的不一致並給其品質打分
annotation_schemes:
  - annotation_type: handoff_review
    name: handoffs
    description: "For each handoff: flag any misalignment and rate the quality."
    steps_key: steps
    agent_key: agent
    flags: [info_loss, dropped_constraint, garbling, goal_drift]
    quality_scale: 5
交接是在渲染時推匯出來的,所以無需手動設定。“每個智慧體看起來都沒問題,團隊卻還是失敗了”這類案例通常就在這裡得到解答:約束在智慧體 A 那裡還活著,到智慧體 B 那裡就沒了。
我怎麼給智慧體和團隊打分?
一次失敗告訴你某一次哪裡壞了。一張記分卡則告訴你一個設計在多次執行中是否優秀。agent_scorecard 方案同時給兩個層級打分(MultiAgentBench,Zhou 等人,ACL 2025):每個智慧體的角色忠實度、貢獻度和協作度,以及團隊自身的共享維度,外加可選的里程碑。智慧體的行來自軌跡,所以這張矩陣與實際參與者相吻合。
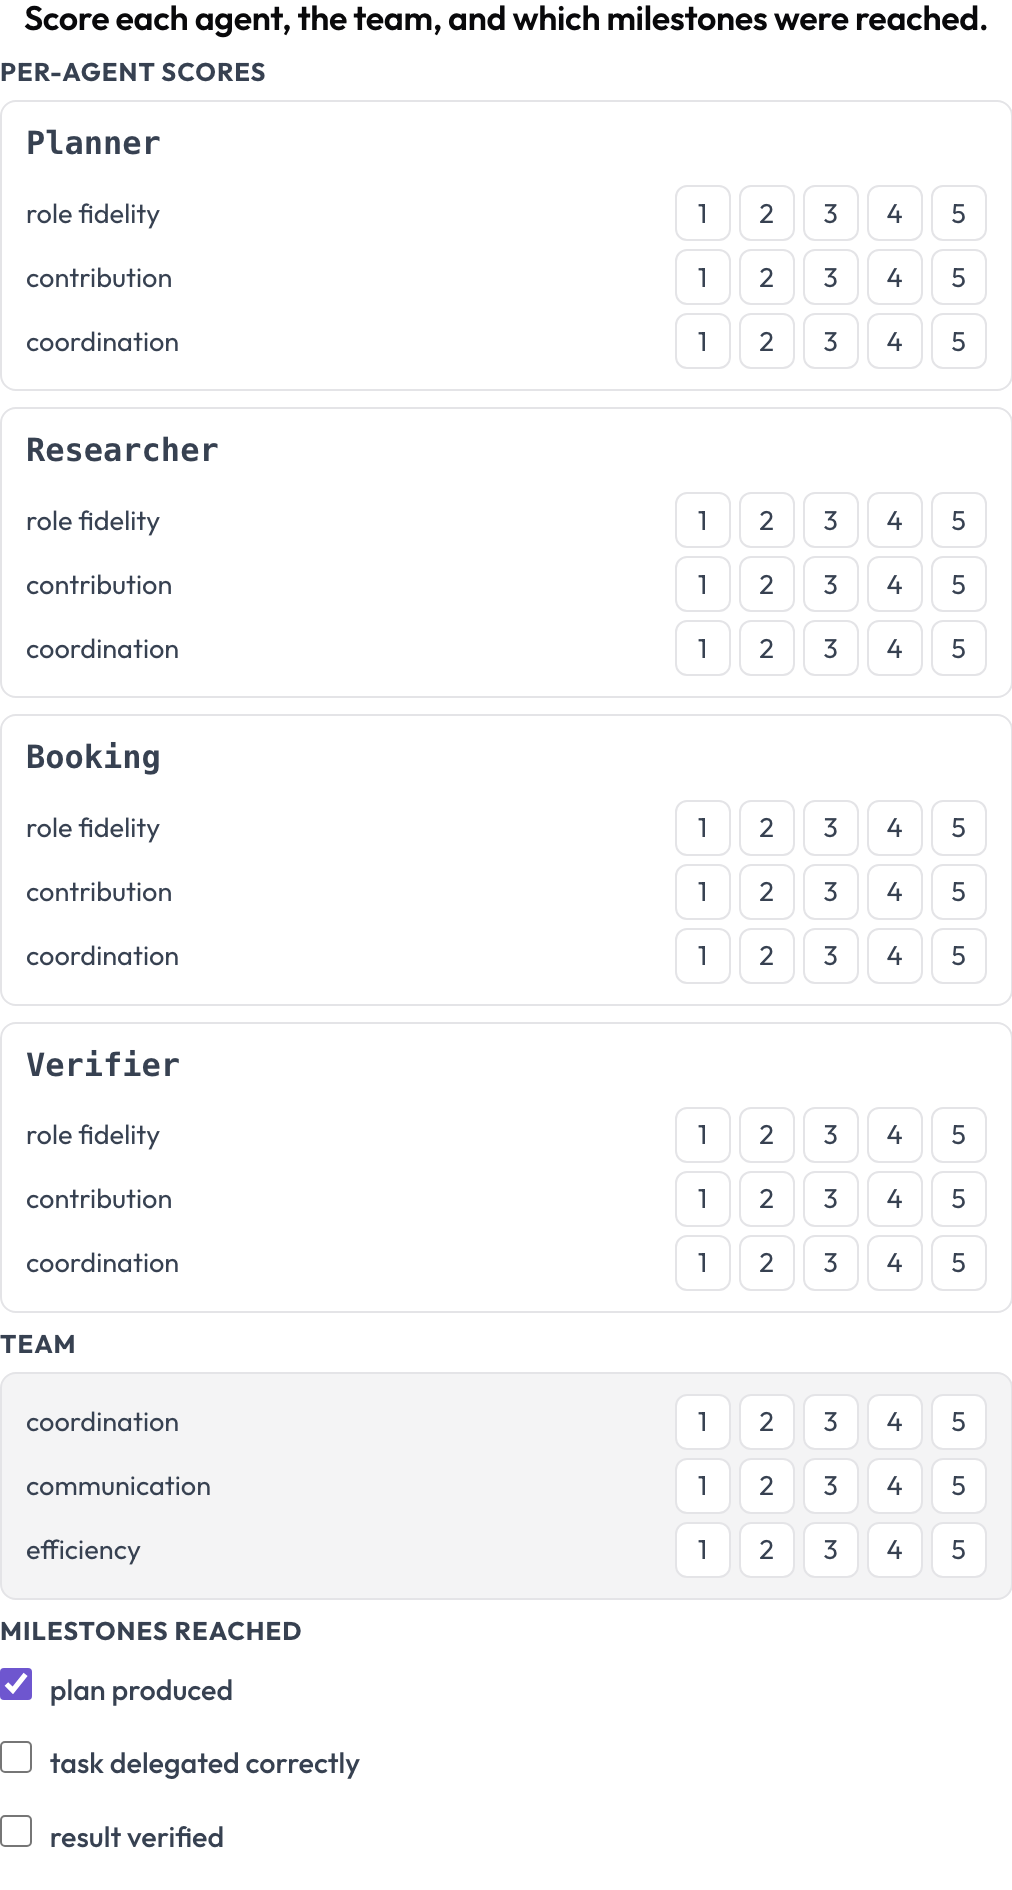 給每個智慧體在角色忠實度、貢獻度和協作度上打分,再加上團隊
annotation_schemes:
  - annotation_type: agent_scorecard
    name: scorecard
    description: "Score each agent, the team, and which milestones were reached."
    steps_key: steps
    agent_key: agent
    scale: 5
    agent_dimensions: [role fidelity, contribution, coordination]
    team_dimensions: [coordination, communication, efficiency]
    milestones: [plan produced, task delegated correctly, result verified]
一個困在協作糟糕的團隊裡的強力智慧體,會在這裡表現為一行很高的智慧體分數緊挨著很低的團隊維度,而這正是你在同樣任務上比較順序式、層級式與群聊式編排時想要看到的那種模式。
那併發與集體性的失敗呢?
還有兩個介面能抓住逐回合閱讀無法捕捉的失敗。tool_contention 時間線把每個智慧體放在各自的泳道上,並高亮兩次呼叫在重疊時間裡觸碰同一資源的區域,你把它分類為死鎖、迴圈等待、競態條件或良性(DPBench,2026)。
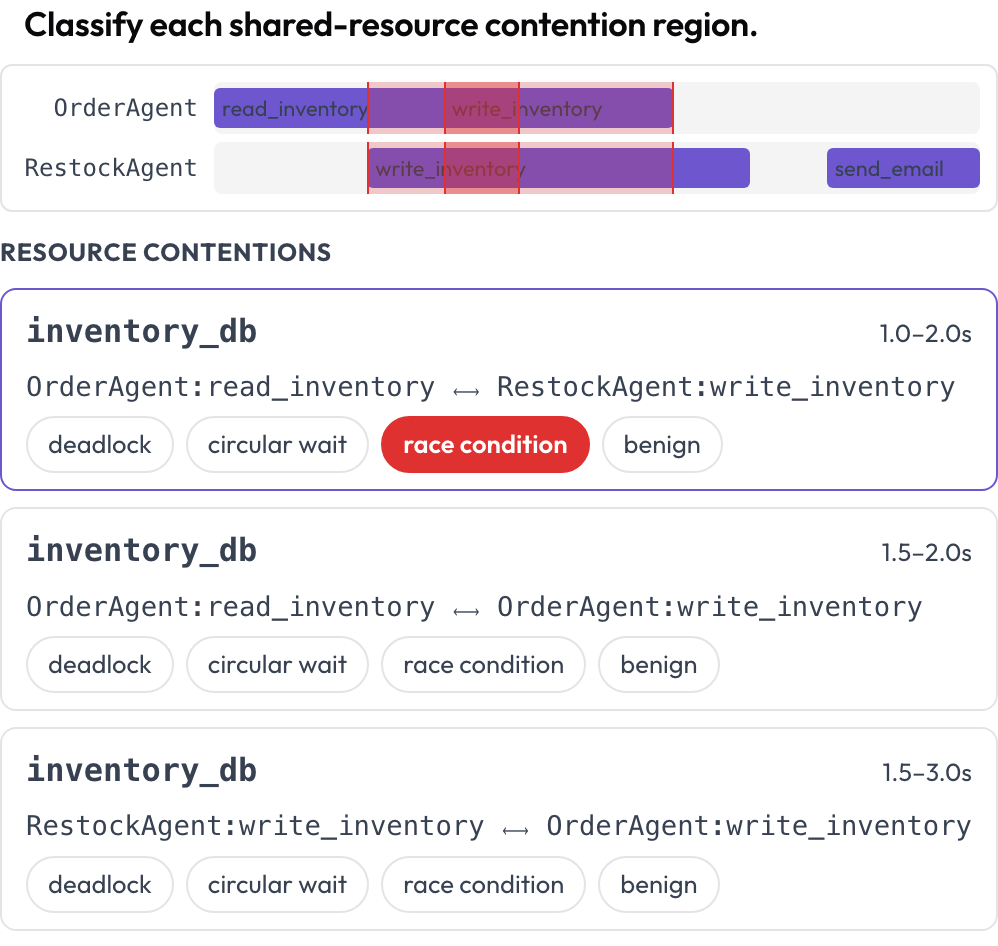 在每個智慧體的工具呼叫時間線上發現死鎖與競態條件
而 emergent_behavior 處理的是集體性而非定位於某一步的失敗——共謀、群體思維、級聯錯誤、角色漂移。一個湧現行為不是一段連續的跨度;它是一組參與的回合,可能來自不同的智慧體,所以你勾選參與其中的回合並加上一條備註。
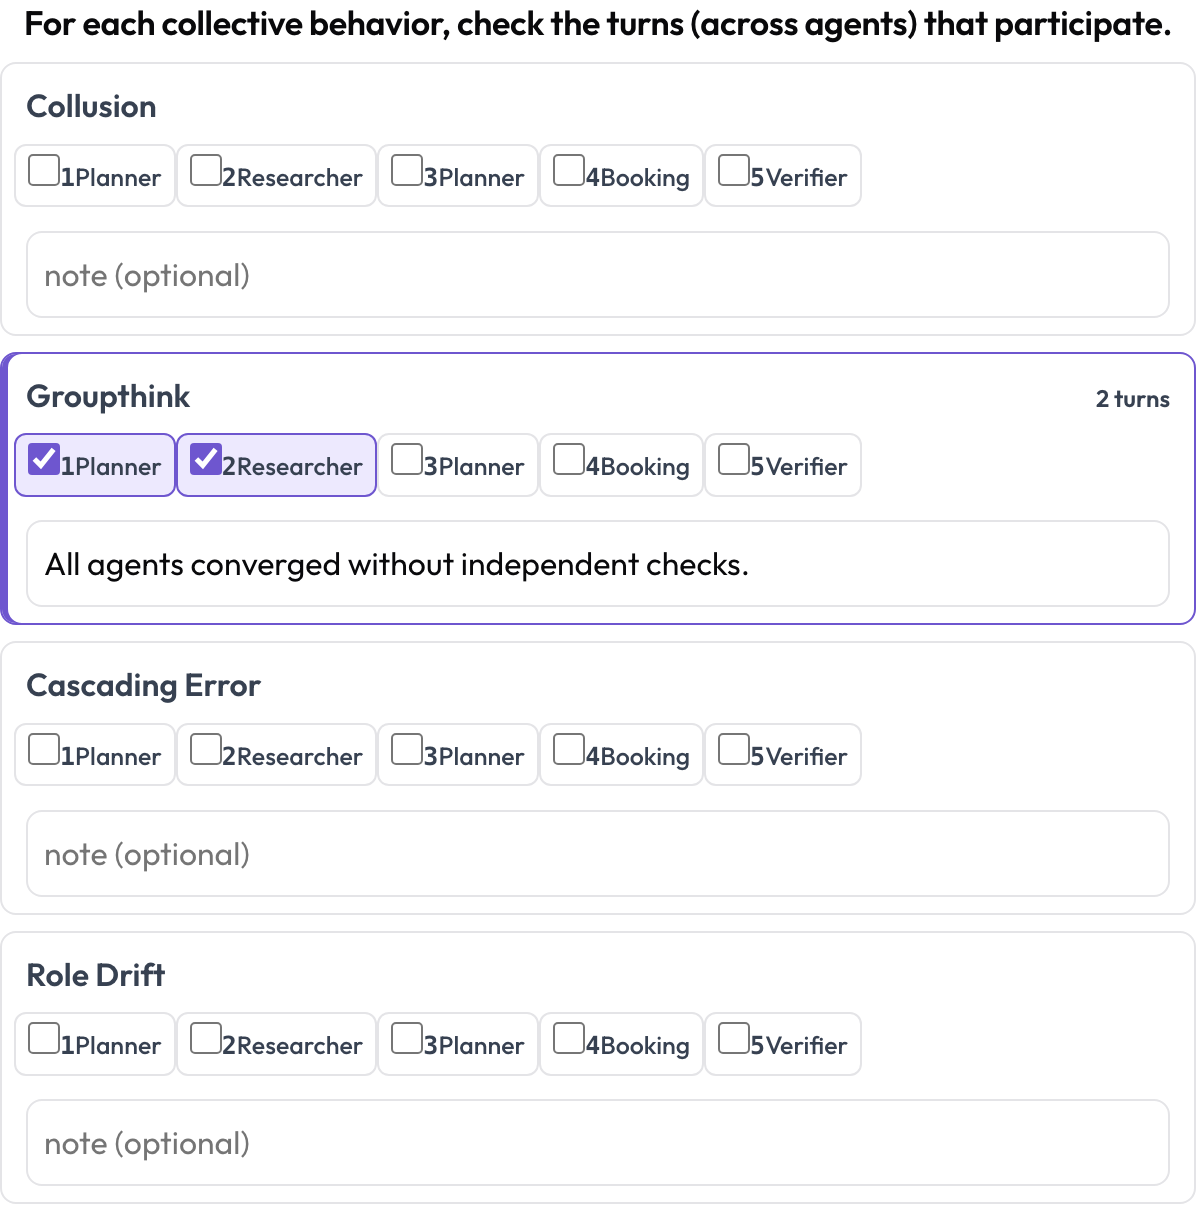 跨智慧體與回合標記共謀、群體思維和級聯錯誤
annotation_schemes:
  - annotation_type: tool_contention
    name: contention
    description: "Classify each shared-resource contention region."
    calls_key: calls
    agent_key: agent
    resource_key: resource
    contention_labels: [deadlock, circular_wait, race_condition, benign]
  - annotation_type: emergent_behavior
    name: emergent
    description: "For each collective behavior, check the turns that participate."
    steps_key: steps
    agent_key: agent
    behaviors: [collusion, groupthink, cascading_error, role_drift]
    allow_note: true
把它們排成順序
在一次真實的出問題的執行上,順序通常是:讀互動圖看清形狀,用失敗歸因點出決定性步驟,如果決定性步驟是一次轉移就開啟交接審查,當失敗關乎時序或群體而非單個智慧體時再去用爭用時間線或湧現行為標記。當你在比較多個設計而不是除錯某一次執行時,再用記分卡來打分。像對待任何主觀標籤那樣去衡量歸因上的一致性;參見 標註者間一致性。
延伸閱讀
- 多智慧體團隊評估 — 完整的方案參考,含每個介面的 YAML
- 如何評估多智慧體系統 — 何時該用哪種方法的決策指南
- Potato 2.6.2:一套完整的開源智慧體評估工具 — 2.6.x 系列釋出的全部內容
- 標註智慧體軌跡 — 每一步的錯誤分類法,包括在步驟粒度上的 MAST 標記