Potato 对比 LangSmith 和 Langfuse 的智能体评测:一份实用比较
LangSmith、Langfuse 和 Potato 在智能体评测中各自为什么而造,如何在它们之间搬运轨迹,以及人类判断在哪里被测量。
LangSmith 和 Langfuse 是为在生产环境中追踪和监控 LLM 应用而造的。Potato 是为收集关于这些轨迹的结构化人类判断、并测量判断者之间有多一致而造的。两样都需要的团队,通常用可观测性工具做采集,用 Potato 跑人类研究。
这三个工具重叠得足够多,所以这个比较经常被提起,而它们只在一个点上重叠:三者都能把一条人类判断挂到一次已记录的智能体运行上。它们各自围绕什么来组织则不同,这个差别决定了哪一个适合你要问的问题。
每个工具各为什么而造
LangSmith 给 LLM 应用做埋点、追踪和调试,与 LangChain 和 LangGraph 的集成最深。基于这两个框架构建的应用,轨迹不需要额外埋点就会送达,整个平台围绕检查运行、跟踪延迟与成本、以及在数据集上运行评测实验来组织。它的标注队列支持量规反馈键、可配置的每次运行评审人数、成对队列,以及互相看不到彼此反馈的评审者。
Langfuse 以开源方式覆盖同样的范围,面向任意 LLM 应用而不是某一个框架,并把提示词管理和追踪打包在一起。打分可以在轨迹层面进行,也可以在观测(span)层面进行,它的分类分值配置让你定义一组固定的标签集,并给同一个 span 挂上多个具名分值。
Potato 是一个被扩展到智能体轨迹上的标注平台。它围绕研究而不是围绕应用来组织,所以它的基本单位是谁标注什么、每个项目由多少人看、他们意见不一致时会怎样,以及一致性统计量对这些标签是否有意义说了什么。在当前版本登记的 61 种标注类型里,智能体轨迹只是其中一种项目类型,这也是它们能直接继承标注者间一致性、训练阶段、裁定和众包的原因,这些都不必为智能体重做一遍。
三者没有哪一个在抽象意义上更好。有用的问题是,你的瓶颈在于看清智能体做了什么,还是在于相信你正在收集的那些关于它的人类标签。
在它们之间搬运轨迹
Potato 是事后读取轨迹,而不是给你的代码做埋点,所以它为 15 种轨迹格式登记了转换器:
python -m potato.trace_converter --list-formats这份列表涵盖 react、openai、anthropic、langchain、langfuse、multi_agent、mcp、otel、atif、webarena、web_agent、swebench、swe_agent_trajectory、claude_code 和 aider。LangSmith 的运行导出走 langchain 转换器,因为没有单独的 langsmith 转换器。CrewAI、AutoGen 和 LangGraph 的日志走 multi_agent。
把一份导出转换过来,在工作流的每个方向上都只是一条命令:
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
--input-format langfuse如果你的框架不在列表上,--auto-detect 会根据字段特征挑一个转换器,而新写一个转换器就是继承 BaseTraceConverter。检测取第一个匹配上的转换器,所以一旦你知道哪个适合自己的文件,就把格式名明确写出来。
轨迹也可以不经过导出步骤就送达。Potato 的轨迹接入接受以 LangSmith 运行载荷格式提交到 /api/traces/* 的运行记录,所以 LangChain 的回调或者追踪 SDK 可以在运行发生的同时就把它们推进标注队列:
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
轨迹进来之后 Potato 多做了什么
方案是一个标注平台立足的地方。trajectory_eval 在一个挂到一条轨迹上的方案里,同时承载正确性标签、带子类型的分层错误分类体系、带可配置权重的严重程度等级,以及一个持续累计的质量分:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
严重程度权重是比较轨迹时真正要紧的那一部分。对被标记的步骤做平铺计数,只能说一个智能体犯了四个错、另一个犯了两个,而加权分数会说清楚那四个是不是无关痛痒、那两个是不是很危险。
对比式评测走 pairwise 方案,它有三种模式。binary 模式展示两个可点击的方块和一个可选的平局按钮,scale 模式把这个选择换成两个项目之间的滑块,multi_dimension 模式则要求按有用性、准确性、安全性这类具名维度分别给出 A/B 判断。
编程智能体有自己的展示方式,因为把统一 diff 当成 JSON 字符串来读是没法评审的:
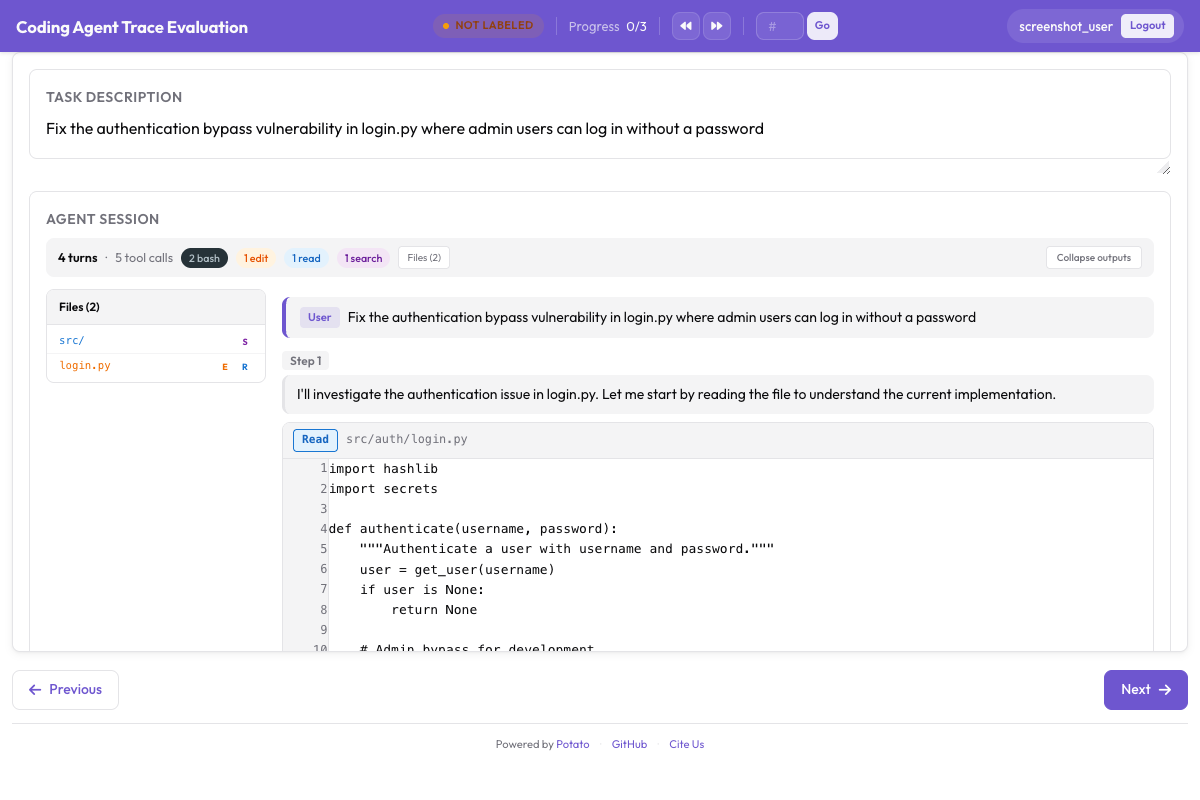 Potato 的编程轨迹展示,带统一 diff 渲染、语法高亮和文件树
coding_trace 展示类型带文件树渲染 diff,并折叠过长的终端输出,code_review 方案收集按行锚定的评论(分为可配置的类别)、按文件的评分维度,以及一个类似拉取请求的结论。随后 coding_eval 导出器写出过程奖励模型标签、代码评审标注、DPO 偏好对,以及与 SWE-bench 兼容的分数,这是训练数据需要的形状,而不是仪表盘需要的形状。
网页智能体轨迹渲染成带 SVG 动作叠加层的截图和一条胶片带:
 网页智能体轨迹查看器,展示带 SVG 动作叠加层的截图和胶片带导航
多智能体运行有自己的标注界面,而不是被压平成一条步骤流。注册表里带有这些方案:可由标注者编辑的交互图、跨智能体的失败归因、交接评审、按智能体和按团队的评分卡、共享时间线上的工具争用,以及涌现行为标记。具身智能体和多模态智能体也一样,计算机操作轨迹、全双工语音交互和视频时间定位都是一等公民方案。
不只是收集判断,还要测量判断
一个项目里最晚暴露出来的差别,是两名标注者意见不一致之后会发生什么。Potato 把分歧当作一次测量,而不是一个待解决的冲突,所以文本标注研究用的那套一致性统计量、裁定队列、训练阶段和金标项目,不需要额外配置就同样适用于智能体轨迹。Potato 自己的工具对比记录到,按 2026-06-24 那次核查,那些追踪平台是为把人类判断作为分数收集而造的,它们当中没有一个记录了针对这些判断的可靠性统计量,而且 Langfuse 会替换掉同一条轨迹上先前的标注,所以在那里做独立的双重标注需要变通办法。
当评测本身就是证据时,这一点就要紧了。用未经复核的单份判断算出来的成功率没有误差棒,而一个已经漂移的评审者,看上去和一个变好了的智能体一模一样。
在智能体运行时观察它
Potato 也可以在标注页面里直接运行一个智能体,而不是回放一份录制。live_agent 块把一个视觉模型接到无头浏览器上,并把会话流式传给标注者,标注者可以暂停它、发送指令,或者接管手动控制:
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
有三种情况让这套配置比事后评审更划算。在破坏性动作发生之前把一次运行叫停,是录制轨迹给不了的安全手段。运行中途记录下来的人类接管会变成演示数据。而观察智能体如何从一次干预中恢复,回答的是任何已完成轨迹里都不包含的问题。
把它们一起用
常见的生产设置两者并用,分工也很干净,因为这些工具想要的东西不同。用 LangSmith 或 Langfuse 给智能体埋点,让每次运行都被追踪。挑出值得人类给意见的那些运行,通常是失败案例、边缘案例,再加一个随机的对照样本。把它们转换进 Potato,用每条轨迹多名标注者的方式跑标注研究,把一致性报告和分数放在一起读。再把错误分类的计数反馈回开发,子类型的分布会说清楚你面对的是一个系统性失败,还是一条长尾。
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
怎么选
当应用建在 LangChain 或 LangGraph 上、需要的是生产可见性时,选 LangSmith,因为轨迹不用做埋点工作就会送达,托管服务也免去了基础设施的问题。当你想以开源方式、跨多家提供商拿到同样的可见性,并且希望提示词版本管理在同一个工具里时,选 Langfuse。当你需要的产出是一组站得住脚的人类标签,当研究需要每个项目多名标注者和一个一致性数字,当智能体是编程型、多智能体或具身型、轨迹需要专门的展示方式,或者当数据必须留在你自己的基础设施上时,选 Potato。Potato 采用 GPL-3.0-or-later 许可并自托管,没有按席位或按轨迹的费用。
这里关于 LangSmith 和 Langfuse 的陈述反映的是 2026-06-24 观察到的它们的文档,而两者的迭代都很快。欢迎在 GitHub 仓库提出更正。配置本身见智能体评测指南,从原始轨迹到导出判断的完整示例见评测 AI 智能体。