面向 AI 编码智能体的 GitHub PR 风格代码评审
在 Potato 中搭建 GitHub PR 风格的代码评审标注:diff 内联评论、文件级质量评分,以及对编码智能体产出的通过或打回结论。
测试通过率与代码质量
大多数编码智能体基准把评估压缩成一个二元问题:测试过了没有?SWE-bench 报告 issue 的解决率,HumanEval 报告 pass@k。这些指标拿来排榜有用,但对理解代码质量没什么帮助。
一个智能体可以通过全部测试,同时写出没人愿意维护的代码:带安全漏洞的、跑得慢的,或者风格和整个代码库对着干的。就算测试全绿,人类评审也会在那个 PR 上要求修改。如果你想要的是能被人真正合并的代码,就得去评审代码本身,而不只是跑测试。
Potato 的 code_review 标注方案把 GitHub PR 评审的体验搬进了标注工具。标注者看到带语法高亮的 unified diff,点击 diff 行添加内联评论,在两个质量维度上给文件打分,最后给出 approve、request changes 或 comment 的结论,和评审一个真实的 pull request 一样。完整的方案参考见编码智能体标注文档和智能体评估指南。
这是 Potato 里的代码评审界面,展示了内联 diff 评论和文件级评分:
 Potato 的代码评审界面,包含内联 diff 评论和文件级质量评分
代码评审方案概览
code_review 方案分三层:
- 内联 diff 评论:标注者点击 diff 中的任意一行,附上一条带分类的评论(bug、风格、性能、安全、逻辑、建议、疑问)
- 文件级评分:每个被修改的文件都单独获得正确性(1-5)和代码质量(1-5)两项评分
- 总体结论:标注者给出最终判断——通过、要求修改,或只留评论
这套流程和真实的代码评审对应,产出的结构化数据可以直接对接代码评审模型的训练。
CodingTraceDisplay:diff 是怎么渲染的
CodingTraceDisplay 组件把编码智能体的 trace 渲染成一串工具调用及其输出,并对文件编辑做了专门处理。当智能体编辑文件时,界面显示 unified diff,其中包含:
- 红色行:被删除的行(前缀
-) - 绿色行:新增的行(前缀
+) - 灰色行:上下文行(未改动)
- 行号:行号槽中同时给出旧行号和新行号
- 语法高亮:根据文件扩展名做语言感知的高亮
- 点击评论:点击任意一行会打开一个锚定到该行的评论表单
diff 由智能体的编辑操作自动算出。如果智能体用的是搜索替换类工具,Potato 会重建改动前后的状态并生成 unified diff。
对于一条 trace 中修改了多个文件的智能体(现实中的 bug 修复很常见),每个文件有自己的可折叠 diff 区块,类似 GitHub PR 的 “Files changed” 标签页。
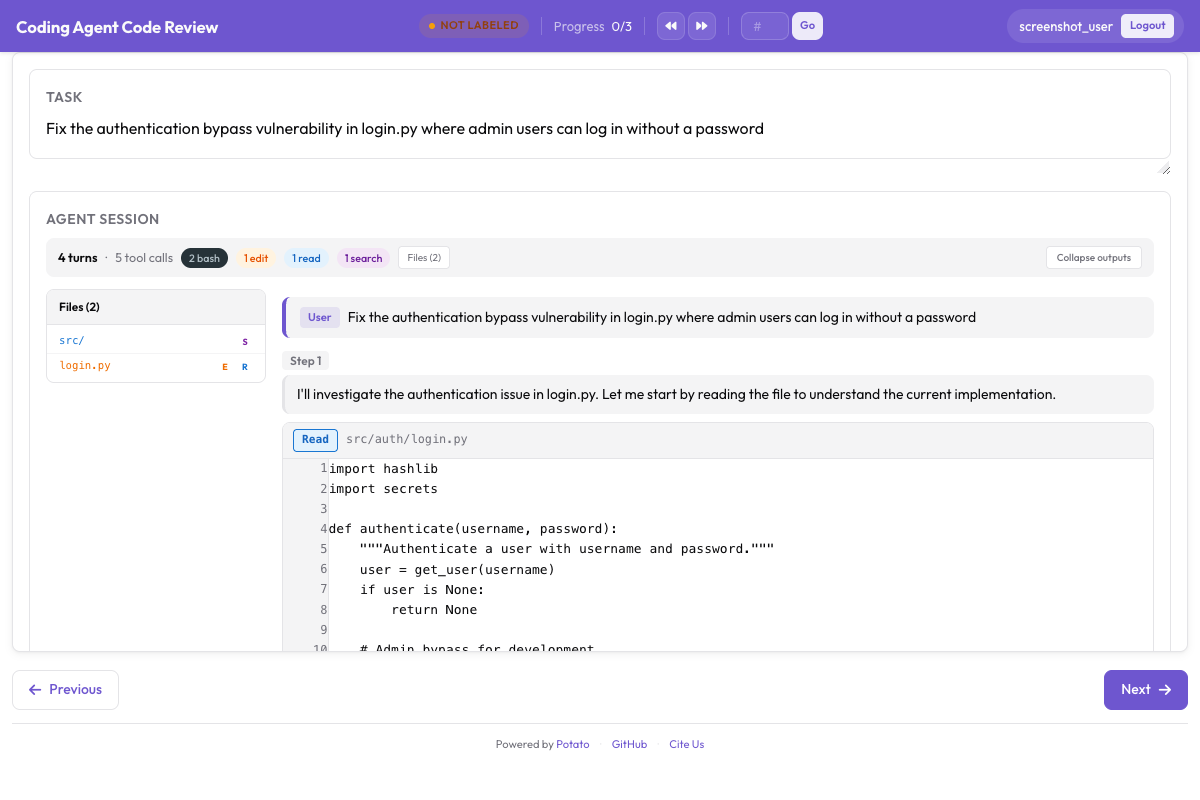
CodingTraceDisplay 渲染代码改动时带有正确的语法高亮:
 CodingTraceDisplay 渲染带语法高亮的 unified diff 和文件树侧边栏
评论分类
标注者点击 diff 行添加评论时,需要选一个分类:
| 分类 | 颜色 | 说明 | 示例 |
|---|---|---|---|
bug | 红色 | 代码存在功能性错误 | “如果 user 是 None,这里会抛 NullPointerException” |
style | 蓝色 | 代码风格或约定问题 | “本项目函数用 snake_case,不是 camelCase” |
performance | 橙色 | 代码效率低 | “这是在循环里查数据库,应该用批量查询” |
security | 紫色 | 安全漏洞 | “用户输入没有做净化就直接拼进了 SQL 查询” |
logic | 黄色 | 逻辑问题,未必立刻导致失败 | “这个条件应该是 >= 而不是 >,边界上差一” |
suggestion | 绿色 | 改进建议,不算错误 | “这里可以考虑用 context manager,资源处理更干净” |
question | 灰色 | 需要澄清 | “为什么加了这个 import?看起来并没有被用到” |
每条评论还有一个自由文本正文,标注者在这里详细说明问题,就像写真实的 PR 评论一样。
文件级评分
看完某个文件的 diff 之后,标注者从两个维度给它打分:
正确性(1-5):
- 1:不能工作,还引入了新 bug
- 2:部分可用,存在明显问题
- 3:主路径可用,但漏掉了边界情况
- 4:基本正确,只有小问题
- 5:完全正确,边界情况也处理得当
代码质量(1-5):
- 1:无法维护,毫无结构
- 2:质量差,风格或设计问题严重
- 3:可以接受,遵循了基本约定
- 4:质量好,干净可读
- 5:优秀,写法地道,文档齐全
结论选项
看完所有文件后,标注者从三种结论中选一个:
- Approve:代码可以原样合并,或者只需要无关紧要的小改动
- Request Changes:合并之前需要做实质性修改
- Comment Only:只给反馈,不做合并决定
这三项与 GitHub 的三种 PR 评审状态一一对应。
分步搭建
第 1 步:转换编码智能体 trace
编码智能体的 trace 格式五花八门。下面是三种常见智能体的例子。
从 Claude Code(JSON 导出):
python -m potato.trace_converter \
  --input claude_code_sessions/ \
  --output data/code_traces.jsonl \
  --input-format claude_code
从 Aider(聊天记录):
python -m potato.trace_converter \
  --input aider_logs/ \
  --output data/code_traces.jsonl \
  --input-format aider
从 SWE-Agent(trajectories 目录):
python -m potato.trace_converter \
  --input swe_agent_trajectories/ \
  --output data/code_traces.jsonl \
  --input-format swe_agent_trajectory
转换器输出一种标准化的 JSONL 格式。每一行是一条 trace,包含任务、智能体的各个步骤,以及文件 diff:
{
  "trace_id": "swe_bench_123",
  "task": "Fix the TypeError in django/db/models/query.py when calling .values() on an empty QuerySet",
  "repo": "django/django",
  "base_commit": "a1b2c3d",
  "steps": [
    {
      "type": "thought",
      "content": "Let me look at the QuerySet.values() method to understand the TypeError."
    },
    {
      "type": "action",
      "tool": "search",
      "input": "def values",
      "file": "django/db/models/query.py"
    },
    {
      "type": "observation",
      "content": "Found at line 234: def values(self, *fields):\n    ..."
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "django/db/models/query.py",
      "old_content": "    def values(self, *fields):\n        clone = self._clone()\n        clone.query.set_values(fields)",
      "new_content": "    def values(self, *fields):\n        clone = self._clone()\n        if not fields and not self.query.values_select:\n            return clone\n        clone.query.set_values(fields)"
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "tests/queries/test_values.py",
      "old_content": "class ValuesTests(TestCase):",
      "new_content": "class ValuesTests(TestCase):\n    def test_empty_queryset_values(self):\n        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n        qs = Author.objects.none()\n        result = list(qs.values())\n        self.assertEqual(result, [])"
    }
  ],
  "files_changed": [
    {
      "path": "django/db/models/query.py",
      "diff": "--- a/django/db/models/query.py\n+++ b/django/db/models/query.py\n@@ -234,6 +234,8 @@\n     def values(self, *fields):\n         clone = self._clone()\n+        if not fields and not self.query.values_select:\n+            return clone\n         clone.query.set_values(fields)"
    },
    {
      "path": "tests/queries/test_values.py",
      "diff": "--- a/tests/queries/test_values.py\n+++ b/tests/queries/test_values.py\n@@ -1,4 +1,10 @@\n class ValuesTests(TestCase):\n+    def test_empty_queryset_values(self):\n+        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n+        qs = Author.objects.none()\n+        result = list(qs.values())\n+        self.assertEqual(result, [])"
    }
  ]
}
第 2 步:配置代码评审方案
创建你的 config.yaml:
annotation_task_name: "Coding Agent Code Review"

data_files:
  - "data/code_traces.jsonl"

item_properties:
  id_key: "trace_id"
  text_key: "task"

# Display coding agent traces with diff rendering
instance_display:
  fields:
    - key: task
      type: text
      label: "Task"

    - key: steps
      type: coding_trace
      label: "Agent changes"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 200

annotation_schemes:
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes as you would a pull request"
    comment_categories: [bug, style, performance, security, logic, suggestion, question]
    file_rating_dimensions: [correctness, quality]
    verdict_options: [approve, request_changes, comment_only]

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl
第 3 步:启动标注服务
potato start config.yaml -p 8000打开 http://localhost:8000。你会看到第一条编码智能体 trace,包括任务描述、智能体的推理步骤,以及带语法高亮的文件 diff。
第 4 步:标注者的工作流
典型的评审流程是这样的:
- 读任务:搞清楚智能体被要求做什么(比如“修复 django/db/models/query.py 中的 TypeError”)
- 看 trace:翻一遍智能体的推理步骤,理解它的思路
- 逐个文件看 diff:
- 读带语法高亮的 diff
- 点击任意一行添加内联评论
- 选择评论分类(bug、风格、性能等)
- 写下评论正文说明问题
- 给这个文件的正确性(1-5)和代码质量(1-5)打分
- 给出结论:选择通过、要求修改,或只留评论
- 提交:点击 “Submit” 或按 Ctrl+Enter
键盘快捷键可以加快流程:
| 快捷键 | 操作 |
|---|---|
j / k | 在文件之间切换 |
c | 在选中行上打开评论 |
1-5 | 为当前维度打分 |
a | 结论设为通过 |
r | 结论设为要求修改 |
Ctrl+Enter | 提交评审 |
导出格式
每份提交的评审会产出一个结构化的 JSON 对象:
{
  "instance_id": "swe_bench_123",
  "annotator": "reviewer_01",
  "verdict": "request_changes",
  "comments": [
    {
      "category": "logic",
      "file": "django/db/models/query.py",
      "line": 236,
      "text": "This early return skips set_values entirely, but if fields are provided later via .values('name'), the previous empty .values() call will have returned a clone that never went through set_values. Consider checking if this clone is still valid downstream."
    },
    {
      "category": "suggestion",
      "file": "tests/queries/test_values.py",
      "line": 5,
      "text": "Consider adding a test case for .values() followed by .values('name') to verify the chaining behavior after your fix."
    }
  ],
  "file_ratings": {
    "django/db/models/query.py": { "correctness": 3, "quality": 4 },
    "tests/queries/test_values.py": { "correctness": 4, "quality": 4 }
  }
}这种结构化格式可以直接用于训练代码评审模型,也便于做汇总分析。coding_eval 导出器把它写成 code_reviews.jsonl:
python -m potato.export -c config.yaml -f coding_eval -o ./export/分析:处理评审数据
加载评审结果
import json
import pandas as pd
from pathlib import Path

reviews = []
for f in Path("output/").glob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            reviews.append(json.loads(line))

print(f"Loaded {len(reviews)} code reviews")
评论分类分布
from collections import Counter

all_comments = []
for rev in reviews:
    all_comments.extend(rev["comments"])

category_counts = Counter(c["category"] for c in all_comments)
print("Comment categories:")
for cat, count in category_counts.most_common():
    print(f"  {cat}: {count}")
文件平均评分
ratings = []
for rev in reviews:
    for path, dims in rev["file_ratings"].items():
        ratings.append({"file": path, **dims})

ratings_df = pd.DataFrame(ratings)
print("Average ratings by file:")
print(
    ratings_df.groupby("file")[["correctness", "quality"]]
    .mean()
    .round(2)
    .to_string()
)
结论分布
verdict_counts = Counter(rev["verdict"] for rev in reviews)
total = sum(verdict_counts.values())
print("Verdict distribution:")
for verdict, count in verdict_counts.most_common():
    print(f"  {verdict}: {count} ({count/total*100:.1f}%)")
按智能体统计 bug 率
如果你的 trace 里带 agent 字段,就可以比较不同智能体的 bug 率:
agent_bugs = {}
for rev in reviews:
    agent = rev.get("agent", "unknown")
    bug_count = sum(
        1 for c in rev["comments"]
        if c["category"] == "bug"
    )
    if agent not in agent_bugs:
        agent_bugs[agent] = []
    agent_bugs[agent].append(bug_count)

print("Average bugs per review by agent:")
for agent, bugs in sorted(agent_bugs.items()):
    print(f"  {agent}: {sum(bugs)/len(bugs):.2f} (n={len(bugs)})")
应用场景
训练代码评审模型
Potato 代码评审标注产出的结构化内联评论、文件评分和结论,很适合作为自动代码评审模型的训练数据。每份评审提供:
- 定位到具体 diff 行的局部反馈
- 已分类的问题(bug 还是风格还是性能)
- 多个粒度上的质量信号(行、文件、整体)
CodeRabbit 或 Graphite 这类自动评审器用的就是同一种形状的数据,区别在于这里的数据由人类专家写出,而不是从 LLM 蒸馏出来的。
在 SWE-bench 上评估编码智能体
SWE-bench 告诉你智能体有没有解决 issue(测试是否通过),但不告诉你代码能不能合并。对 SWE-bench 的解法跑一遍代码评审标注,你就能区分出哪些智能体是用干净的代码解决问题,哪些是靠 hack 蒙混过关。这样得到的排名反映的是代码能不能合并,而不只是测试有没有变绿。
构建代码质量数据集
把大量 trace 的代码评审数据汇总起来,可以建立 AI 生成代码中常见质量问题的数据集。这类数据集可以用于:
- 微调代码生成模型,避开常见错误
- 针对 AI 生成代码的模式构建专门的 linter
- 训练分类器,在人工评审之前先标出智能体输出中可能有问题的地方
小结
Potato 的 code_review 方案把 GitHub PR 评审流程放进了智能体评估。内联评论、文件评分和结论给你的是结构化的代码质量数据:可以拿来训练代码评审模型,可以把干净的 SWE-bench 解法和糙活区分开,也可以给自己的智能体定一条质量基线。