智慧體評估工具對比:Potato、LangSmith 與 Langfuse
從 trace 渲染、逐步與多智慧體標註、多模態智慧體評審、編碼智慧體、即時觀察、價格和自託管等方面,對比 Potato 與 LangSmith、Langfuse、Labelbox、Scale AI。
三個工具,三種出發點
Potato、LangSmith 和 Langfuse 都涉及智慧體評估,但它們的起點不一樣:
- Potato 以標註為本。它最初是為了收集針對 AI 輸出的結構化人類判斷而做的,後來擴充套件到支援智慧體 trace、程式碼 diff 和即時觀察。它的長處在於標註 schema 的深度和可配置性。
- LangSmith 以可觀測性為本。它最初是為了給生產環境中的 LangChain 應用做埋點、追蹤和除錯。標註功能是後來加的,用於支撐 LangChain 生態內部的評估流程。
- Langfuse 是開源的可觀測性工具。它覆蓋任意 LLM 應用的 tracing、prompt 管理和評估。標註功能可用,但相對監控是次要的。
沒有哪一個在所有場景下都更好。選哪個取決於你主要需要的是標註、可觀測性還是兩者兼有,也取決於你是否繫結在某個特定框架生態上。
功能對比
下表對比了與 AI 智慧體評估相關的能力。我們也把 Label Studio、Argilla 和 Scale AI 列了進來,因為團隊常常也會一併考慮它們。
| 功能 | Potato | LangSmith | Langfuse | Label Studio | Argilla | Scale AI |
|---|---|---|---|---|---|---|
| 主要定位 | 標註 | 可觀測性 | 可觀測性 | 標註 | 標註 | 標註 |
| 支援的 trace 格式 | 15 種 | LangChain 原生 | Langfuse SDK | 無 | 無 | 定製 |
| 逐步標註 | 完整(trajectory_eval) | 每個 span 一個評分 + 評論 | span 級結構化評分 | 有(trace 匯入) | 僅對話輪次 | 定製 |
| 即時智慧體觀察 | 有 | 無 | 無 | 無 | 無 | 無 |
| 智慧體暫停/恢復/接管 | 有 | 無 | 無 | 無 | 無 | 無 |
| 程式碼 diff 渲染 | 有(unified diff、語法高亮) | 無 | 無 | 無 | 無 | 無 |
| 終端輸出渲染 | 有(支援 ANSI 顏色) | 無 | 部分 | 無 | 無 | 無 |
| PRM 資料收集 | 有(步級正確性標籤) | 無 | 無 | 無 | 無 | 無 |
| 帶行內評論的程式碼評審 | 有(行級、分類) | 無 | 無 | 無 | 無 | 無 |
| 成對比較 | 3 種模式(並排、先後、盲測) | 有限(1 種模式) | 無 | 無 | 有(1 種模式) | 有(1 種模式) |
| 多維度評分量表 | 有(維度、量表均可配置) | 無 | 無 | 無 | 部分 | 有 |
| 錯誤分類體系 | 分層、可配置 | 無 | 類別型評分配置 | 無 | 無 | 定製 |
| 嚴重程度評分 | 有(加權、累計分數) | 無 | 僅數值評分 | 無 | 無 | 定製 |
| 多智慧體互動圖(標註者可編輯) | 有 | 無 | 僅視覺化 ¹ | 無 | 無 | 無 |
| 跨智慧體失敗歸因 | 有 | 無 | 僅能變通實現 | 無 | 無 | 僅託管服務 |
| 交接評審(一等物件) | 有 | 無 | 無 | 無 | 無 | 無 |
| 單智慧體 + 團隊級記分卡 | 有 | 無 | 無 | 無 | 無 | 無 |
| computer-use 軌跡(點選定位) | 有 | 無 | 無 | 通用影像工具 | 無 | 託管資料集 ² |
| 全雙工語音(插話打斷評分) | 有 | 無 | 僅回放 | 無 | 無 | 僅按輪次 ³ |
| 影片時間定位(即時 IoU) | 有 | 無 | 無 | IoU 僅用於標註者間一致性 | 無 | 無 |
| 自託管 | 有(完全支援) | 僅企業版 | 有(開源) | 有(開源) | 有(開源) | VPC(企業版) |
| 免費 | 是(完全開源) | 否(免費額度有限) | 部分(開源核心) | 部分(開源核心) | 是(開源) | 否 |
| 框架鎖定 | 無 | LangChain 生態 | 無 | 無 | 無 | 無 |
¹ Langfuse 的 Agent Graphs(beta)把一次多智慧體執行渲染成圖,但那是隻讀的除錯檢視,沒有文件說明標註者可以在上面標出關鍵路徑或標記某條邊。² Scale AI 把 GUI / computer-use 軌跡的標註作為託管資料服務來做(例如它在 CVAT 上的 CUA-Suite 工作),而不是一項你自己配置的自助功能。³ Scale 的 Voice Showdown 是按輪次的;全雙工的插話/重疊評分只是列在計劃中,尚未提供(截至 2026-03-20)。
對比於 2026-06-24 觀察得出,對應 LangSmith(docs.langchain.com)、Langfuse(MIT 核心,持續釋出)、Label Studio 1.23.0、Argilla 2.8.0 和 Scale AI 的產品頁面。這些工具迭代很快——如果這裡有內容已經過時,歡迎到 GitHub 倉庫提交更正。
在這些工具裡,只有 Potato 會用規範的 diff 格式渲染編碼智慧體的 trace:
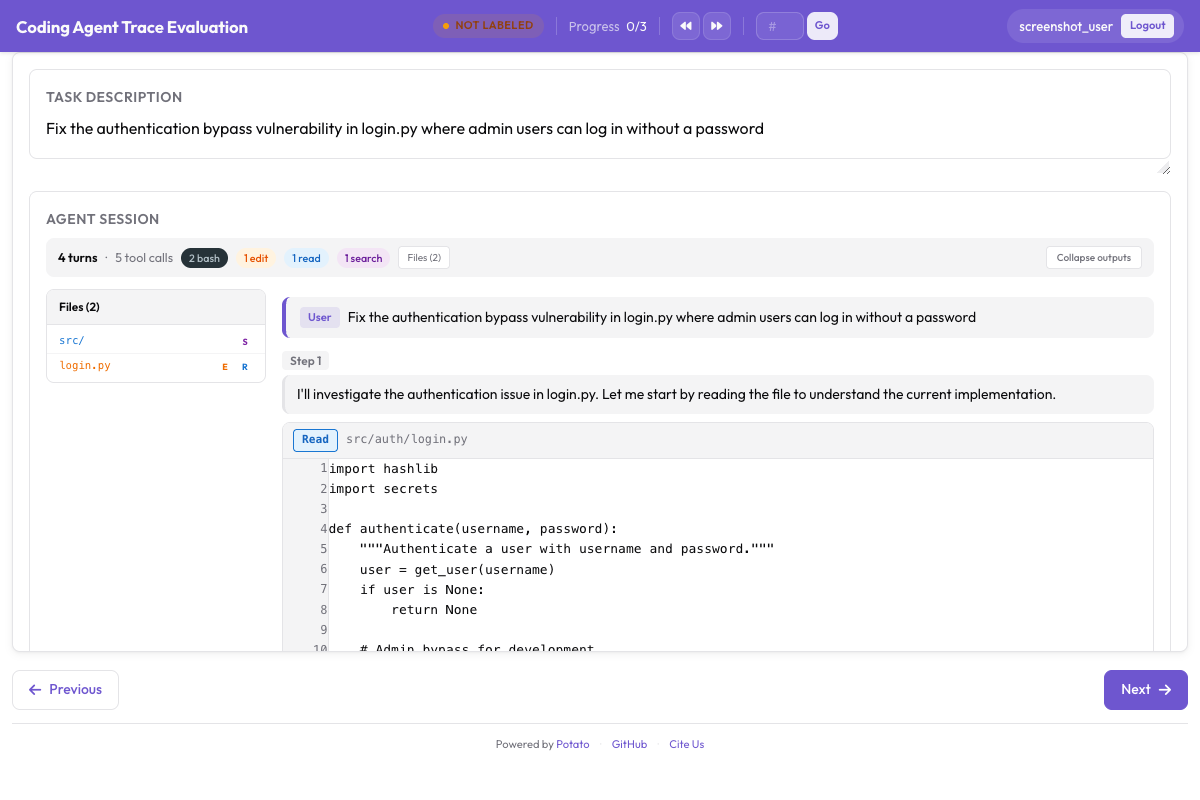 Potato 的 CodingTraceDisplay,帶 unified diff 渲染、語法高亮和檔案樹
trace 格式支援的細節
一個很實際的差別是:每個工具原生支援多少種智慧體 trace 格式。
Potato 內建了 15 種格式的轉換器:
# See all available converters
python -m potato.trace_converter --list-formats

# Available formats:
#   react                 - ReAct-style (Thought/Action/Observation)
#   openai                - OpenAI Chat Completions and Assistants API
#   anthropic             - Anthropic Messages API with tool_use
#   langchain             - LangChain / LangSmith run trace exports
#   langfuse              - Langfuse observation and trace exports
#   multi_agent           - CrewAI, AutoGen, and LangGraph multi-agent logs
#   swebench              - SWE-bench benchmark traces
#   swe_agent_trajectory  - SWE-Agent trajectory files
#   claude_code           - Claude Code and coding-agent session logs
#   aider                 - Aider chat histories with edit blocks
#   webarena              - WebArena / VisualWebArena episode traces
#   web_agent             - Mind2Web, Computer Use, and raw browser recordings
#   mcp                   - Model Context Protocol interaction logs
#   otel                  - OpenTelemetry / OTLP trace exports
#   atif                  - Agent Trace Interchange Format
沒有單獨的 langsmith 轉換器:LangSmith 的匯出走 langchain,AutoGen 和 CrewAI 走 multi_agent。如果你的框架不在列表裡,--auto-detect 會根據欄位特徵嘗試挑一個轉換器,你也可以繼承 BaseTraceConverter 自己寫一個。
LangSmith 原生支援 LangChain 的 trace。如果你的智慧體用 LangChain 或 LangGraph 搭建,trace 會自動流入。如果不是,你需要用 LangSmith SDK 手動給程式碼埋點,或者把 trace 轉換成 LangSmith 的格式。
Langfuse 原生支援通過 Langfuse SDK 埋點產生的 trace。它支援 Python 和 JavaScript,並集成了 LangChain、LlamaIndex 和 OpenAI。和 LangSmith 一樣,它要求在程式碼層面埋點,而不是事後轉換 trace。
把 LangSmith 或 Langfuse 的 trace 匯入 Potato
如果你的 trace 已經在 LangSmith 或 Langfuse 裡,又想用 Potato 的標註功能,轉換器可以處理:
# Export from LangSmith and convert
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Export from Langfuse and convert
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
所以你可以繼續用 LangSmith 或 Langfuse 做生產監控,需要做細緻的人工評估時再把 trace 拿到 Potato 裡。
逐步標註:差距最大的地方
能力上差別最大的是逐步標註的深度。
Potato 提供 trajectory_eval schema,包含:
- 步級正確性標籤(correct/incorrect)
- 分層錯誤分類體系的選擇
- 權重可配置的嚴重程度等級
- 逐步更新的累計分數
- 每一步的自由文本理由
- 以上都通過 YAML 配置
# Potato: rich per-step annotation
annotation_schemes:
  - annotation_type: "trajectory_eval"
LangSmith 允許你給一條 trace 中的單次 run 附上數值評分或類別標籤。這對基本的品質跟蹤有用,但不支援錯誤分類體系、嚴重程度加權或累計分數。它沒有內建的逐步評審介面;你是在 trace 詳情視圖裡給 run 打分。
Langfuse 支援在 trace 級和 observation(span)級打分,它的類別型 score config 允許你定義固定的標籤集——一套可用的錯誤分類體系——並給同一個 span 掛上多個具名評分。它沒有作為一等 schema 提供的,是分層的分類體系,以及跨步驟累積的、按嚴重程度加權的累計分數;這些需要你自己用扁平的 score config 拼出來。
所以誠實地講,這個差距比過去要小:Langfuse 和 Label Studio(現在可以匯入 LangGraph/CrewAI/AutoGen 的 trace 做逐步評審)都能做結構化的逐步打分。Potato 仍然是專門為此而建的地方在於組合——分層錯誤分類體系加嚴重程度權重加累計分數,全都在一個 trajectory_eval schema 裡——而這正是構建 PRM 訓練資料或定位智慧體最先在哪裡出錯時需要的。
編碼智慧體支援
評估編碼智慧體(Claude Code、Aider、SWE-Agent、Devin、OpenHands)意味著要渲染程式碼 diff 和終端輸出,好讓評審快起來。這是 Potato 領先於其他工具的地方。
Potato 會渲染:
- 帶紅/綠高亮和語法高亮的 unified diff
- 支援 ANSI 顏色碼的終端輸出
- 錨定到具體行的 diff 行內評論
- 檔案級品質評分
- PR 風格的批准 / 要求修改結論
LangSmith 把工具呼叫的輸入輸出顯示為格式化後的 JSON。程式碼 diff 以原始文本字串的形式出現在工具輸出裡。沒有 diff 渲染、語法高亮或行內評論。
Langfuse 同樣把 trace 資料顯示為結構化 JSON。程式碼內容顯示為純文本。對 diff 或終端輸出沒有專門渲染。
對編碼智慧體來說,這直接改變評審者一天的工作。在語法高亮的 unified diff 視圖裡配合行內評論看一份 50 行的 diff,花的時間只是把同一份 diff 當作 JSON 字串讀的一小部分。
Web 智慧體的 trace 包含帶 SVG 疊加層的截圖和膠片條導航:
 Web 智慧體 trace 檢視器,展示帶 SVG 動作疊加層的截圖和膠片條導航
即時智慧體觀察
Potato 可以即時觀察一個正在執行的智慧體,這一點 LangSmith 和 Langfuse 的標註流程都做不到。
在 Potato 的即時觀察模式下,標註者可以逐步看著智慧體幹活,暫停它來檢視當前狀態,之後再讓它繼續,也可以接管會話來糾正方向或者自己手動把任務做完。
這在幾種情況下有幫助:在智慧體做出破壞性操作之前把它攔下來(安全)、把人的糾正記錄成示範資料(訓練),以及觀察你中途介入時智慧體作何反應(互動式評估)。
# Enable live observation in Potato config
live_observation:
  enabled: true
  agent_endpoint: "http://localhost:5000/agent"
  allow_pause: true
  allow_takeover: true
  auto_pause_on:
    - action_type: "delete"
    - action_type: "execute"
    - confidence_below: 0.3
LangSmith 和 Langfuse 的設計目標是對已完成的 trace 做事後分析,不是與執行中的智慧體即時互動。
成對比較
把兩個智慧體的輸出並排比較是常見的評估模式,尤其是在做模型版本 A/B 測試或比較智慧體架構時。
Potato 提供三種比較模式:
- 並排:兩條 trace 同時可見,滾動同步
- 先後:先看 trace A,再看 trace B,然後下判斷
- 盲測:兩條 trace 被隨機標為 A 和 B,不顯示模型來源
annotation_schemes:
  - annotation_type: "pairwise"
LangSmith 通過評估實驗裡的 comparison view 支援基礎的成對比較。你可以跨不同模型版本比較 run,但這個介面是為並排檢查 run 設計的,不是為結構化的偏好標註設計的。
Langfuse 沒有內建的成對比較標註功能。
各自適合什麼時候用
用 Potato,當:
- 標註是你的主要目標:你要的是結構化的人類判斷,不只是監控
- 你需要編碼智慧體支援:diff 渲染、行內評論、終端輸出顯示
- 你在收集 PRM 訓練資料:帶累計分數的步級正確性標籤
- 你需要自託管:資料留在自己的基礎設施上,不依賴雲
- 你會用到多個智慧體框架:15 種 trace 格式轉換器,而不是綁死在單一框架上
- 你需要豐富的評估 schema:軌跡評估、量表評估、程式碼評審、成對比較
- 預算有限:完全免費且開源
用 LangSmith,當:
- 你已經在用 LangChain/LangGraph:trace 零配置自動流入
- 生產監控是你的首要需求:即時 tracing、延遲跟蹤、成本監控
- 標註是次要的:你需要基本的打分和反饋,不需要深度評估 schema
- 你想要託管服務:沒有基礎設施需要維護
- 團隊規模小:免費額度可能足夠做輕量評估
用 Langfuse,當:
- 你需要開源的可觀測性:自託管的監控和 tracing
- 你使用多個 LLM 提供方:對 OpenAI、Anthropic、LangChain、LlamaIndex 的整合都不錯
- 標註不是你的主要用途:有打分功能,但不是重點
- 你想要 prompt 管理和 tracing 放在一起:Langfuse 把 prompt 版本管理和可觀測性打包在一起
- 你需要一個免費的 LangSmith 監控替代品:Langfuse 的開源核心覆蓋了大部分監控需求
互補方案:可觀測性 + 標註
對不少團隊來說,實際做法是用一個可觀測性工具(LangSmith 或 Langfuse)做生產監控,用 Potato 做細緻的人工評估。流程大致是:
- 給智慧體埋點,用 LangSmith 或 Langfuse 做生產 tracing
- 抽取需要人工評審的 trace(失敗案例、邊界情況、隨機抽樣)
- 從可觀測性工具匯出這些 trace
- 用內建轉換器轉換並匯入 Potato
- 用 Potato 豐富的標註 schema 執行人工評估
- 把結果反饋回你的開發迴圈
# Example: convert failed traces exported from Langfuse and import to Potato
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse
這樣你既有可觀測性平臺的即時可見性,也有一個為標註而建的工具所提供的標註深度。
主要差異小結
其中有兩塊地方,這個說法最站得住腳。在我們調研過的所有工具裡(商業的和開源的),只有 Potato 提供面向多智慧體團隊結構和多模態智慧體評審的、標註者可配置的介面:
- 一張可點選、標註者可編輯的多智慧體互動圖——標出關鍵路徑,標記有問題的交接。別處最接近的東西是 Langfuse 的 Agent Graphs,那是隻讀的除錯檢視。
- 跨智慧體失敗歸因、作為一等物件的交接評審、單智慧體和團隊級記分卡、工具爭用時間線,以及湧現行為標記——這些其他工具都沒有作為內建的標註構件提供。
- 帶點選定位的 computer-use 軌跡、帶插話打斷評分的全雙工語音時間線,以及帶即時 IoU 的影片時間定位。Scale AI 做 GUI 定位和語音評估,但那是託管的資料集服務,而且它的語音競技場仍是按輪次的。
在這些之上,Potato 仍然是唯一一個免費、可自託管,同時把編碼智慧體 diff 渲染與行內評論、PRM 資料收集、帶暫停/恢復/接管的即時觀察、任意框架的 trace 接入、帶嚴重程度加權累計分數的分層錯誤分類體系、三種成對比較模式,以及 PR 風格程式碼評審集於一身的工具。
我們不知道還有哪個工具,開源的或商業的,把這些全都打包在一起——截至 2026-06-24,已對照 LangSmith、Langfuse、Labelbox、Scale AI、Label Studio、Argilla 和 Braintrust 核實(見對比表下方帶日期的腳註)。LangSmith 和 Langfuse 是很強的可觀測性工具,但它們的標註功能是 span 範圍的評分,不是面向智慧體結構的介面。Label Studio 和 Argilla 是通用標註工具;Label Studio 加裝了 trace 匯入,但兩者都沒有上面說的多智慧體或多模態智慧體介面。Labelbox 和 Scale 提供智慧體評估的資料產品,但形式是付費的雲服務或託管服務,而不是一個研究團隊可以自己執行和改造的自託管工具。
如果你的目標是搞清楚智慧體如何以及為何成功或失敗,並收集改進它們所需的訓練資料,Potato 補上了其他工具留下的這塊空缺。
遷移路徑
從 LangSmith 遷到 Potato(用於標註)
# 1. Export your dataset from LangSmith
langsmith export dataset my_eval_dataset -o langsmith_data.jsonl

# 2. Convert to Potato format
python -m potato.trace_converter \
  --input langsmith_data.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# 3. Create your Potato config and start annotating
potato start config.yaml -p 8000
從 Langfuse 遷到 Potato(用於標註)
# 1. Export traces from Langfuse via API
import requests

response = requests.get(
    "https://cloud.langfuse.com/api/public/traces",
    headers={"Authorization": "Bearer your_api_key"},
    params={"limit": 500}
)

with open("langfuse_traces.json", "w") as f:
json.dump(response.json()["data"], f)# 2. Convert to Potato format
python -m potato.trace_converter \
--input langfuse_traces.json \
--output data/traces.jsonl \
--input-format langfuse
# 3. Start annotating
potato start config.yaml -p 8000從 Label Studio 或 Argilla 遷移(用於智慧體評估)
如果你目前用 Label Studio 或 Argilla 做通用標註,想再加上智慧體評估能力,Potato 可以和現有工具並行執行。用 Label Studio 或 Argilla 處理非智慧體的標註任務(NER、分類等),用 Potato 做需要 trace 渲染、逐步標註和程式碼評審的智慧體專項評估。
結語
在 Potato、LangSmith 和 Langfuse 之間做選擇,不是抽象地問哪個最好。取決於你主要需要什麼:
- 要在生產環境監控智慧體,用 LangSmith 或 Langfuse。
- 要用結構化的人工標註評估智慧體行為,用 Potato。
- 兩者都要,就一起用。它們互補。
該問的問題是:你的主要目標是觀察智慧體做了什麼,還是評估它做得有多好。如果是評估,Potato 就是為此而建的。