エージェント評価におけるPotatoとLangSmith・Langfuse:実践的な比較
エージェント評価でLangSmith、Langfuse、Potatoがそれぞれ何のために作られているか、トレースを相互に移す方法、そして人間の判断がどこで測定されるかを解説します。
LangSmithとLangfuseは、本番環境のLLMアプリケーションをトレースし監視するために作られています。Potatoは、それらのトレースが示す内容について構造化された人間の判断を集め、判断する人どうしがどの程度一致しているかを測定するために作られています。両方が必要なチームは、通常、可観測性ツールでキャプチャし、人間による調査をPotatoで実施します。
3つのツールは比較がよく話題になる程度には重なっていますが、重なるのは1点だけです。3つとも、記録されたエージェントの実行に人間の判断を付けられます。何を中心に組み立てられているかは異なり、その違いが、あなたが立てている問いにどれが合うかを決めます。
それぞれのツールは何のために作られているか
LangSmithはLLMアプリケーションを計装し、トレースし、デバッグします。LangChainとLangGraphとの統合がもっとも深く、これらのフレームワーク上に構築したアプリケーションのトレースは追加の計装なしで届きます。プラットフォームは、実行の調査、レイテンシとコストの追跡、データセットに対する評価実験の実行を中心に組み立てられています。アノテーションキューは、ルーブリック付きのフィードバックキー、実行ごとのレビュアー数の設定、ペアワイズのキュー、互いのフィードバックを見られないレビュアーに対応しています。
Langfuseは同じ領域をオープンソースでカバーし、特定のフレームワークではなくあらゆるLLMアプリケーションを対象として、トレースとあわせてプロンプト管理も提供します。スコア付けはトレース単位とオブザベーション(span)単位で行え、カテゴリカルなscore configを使うと、固定のラベルセットを定義し、1つのspanに名前付きのスコアを複数付けられます。
Potatoは、エージェントトレースに対応するよう拡張されたアノテーションプラットフォームです。アプリケーションではなく調査を中心に組み立てられているため、その基本要素は、誰が何をアノテーションするか、各アイテムを何人が見るか、意見が分かれたときに何が起きるか、そしてラベルに意味があるかどうかについて一致度の統計が何を示すか、です。エージェントトレースは現在のリリースが登録する61のアノテーションタイプの中の1つのアイテムタイプにすぎず、そのため、アノテーター間一致度、トレーニングフェーズ、裁定、クラウドソーシングを、エージェント向けに何も作り直すことなく引き継いでいます。
3つのうちどれかが抽象的に優れているわけではありません。役に立つ問いは、ボトルネックがエージェントの行動を見ることにあるのか、それともそれについて集めている人間のラベルを信頼することにあるのか、です。
ツール間でトレースを移す
Potatoはコードを計装するのではなく、トレースを事後に読み込みます。そのため、15のトレース形式に対応するコンバーターを登録しています。
python -m potato.trace_converter --list-formats対象はreact、openai、anthropic、langchain、langfuse、multi_agent、mcp、otel、atif、webarena、web_agent、swebench、swe_agent_trajectory、claude_code、aiderです。独立したlangsmithコンバーターはないため、LangSmithの実行エクスポートはlangchainコンバーターを通します。CrewAI、AutoGen、LangGraphのログはmulti_agentを通します。
エクスポートの変換は、ワークフローのどちらの方向でも1つのコマンドで済みます。
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
--input-format langfuse使っているフレームワークが一覧にない場合、--auto-detectがフィールドの特徴からコンバーターを選びます。新しいコンバーターはBaseTraceConverterのサブクラスとして書けます。検出は最初に一致したコンバーターを採用するので、どの形式がファイルに合うか分かったら形式を明示してください。
トレースはエクスポートの手順を経ずに届けることもできます。Potatoのトレース取り込みは、LangSmithの実行ペイロード形式で/api/traces/*に送られた実行を受け付けるため、LangChainのコールバックやトレーシングSDKから、実行が発生するたびにアノテーションキューへ送り込めます。
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
トレースを取り込んだあとにPotatoが加えるもの
アノテーションプラットフォームが存在意義を示すのはスキーマです。trajectory_evalは、正誤ラベル、サブタイプを持つ階層的なエラー分類体系、重みを設定できる深刻度レベル、累積の品質スコアを、1つのトレースに付く1つのスキーマにまとめて持っています。
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
トレースを比較するうえで重要なのは深刻度の重みです。マークしたステップを単純に数えると、あるエージェントは4つ、別のエージェントは2つ誤ったことが分かります。重み付きスコアは、その4つが見た目だけの問題で、2つが危険なものだったかどうかを示します。
比較評価はpairwiseスキーマで行い、3つのモードがあります。バイナリモードはクリックできる2つのタイルと任意の引き分けボタンを表示し、スケールモードは選択の代わりに2つのアイテムの間にスライダーを置きます。multi_dimensionモードは、有用性、正確性、安全性といった名前付きの次元ごとに独立したA/Bの判定を求めます。
コーディングエージェントには専用の表示があります。JSON文字列として読むunified diffはレビューできないからです。
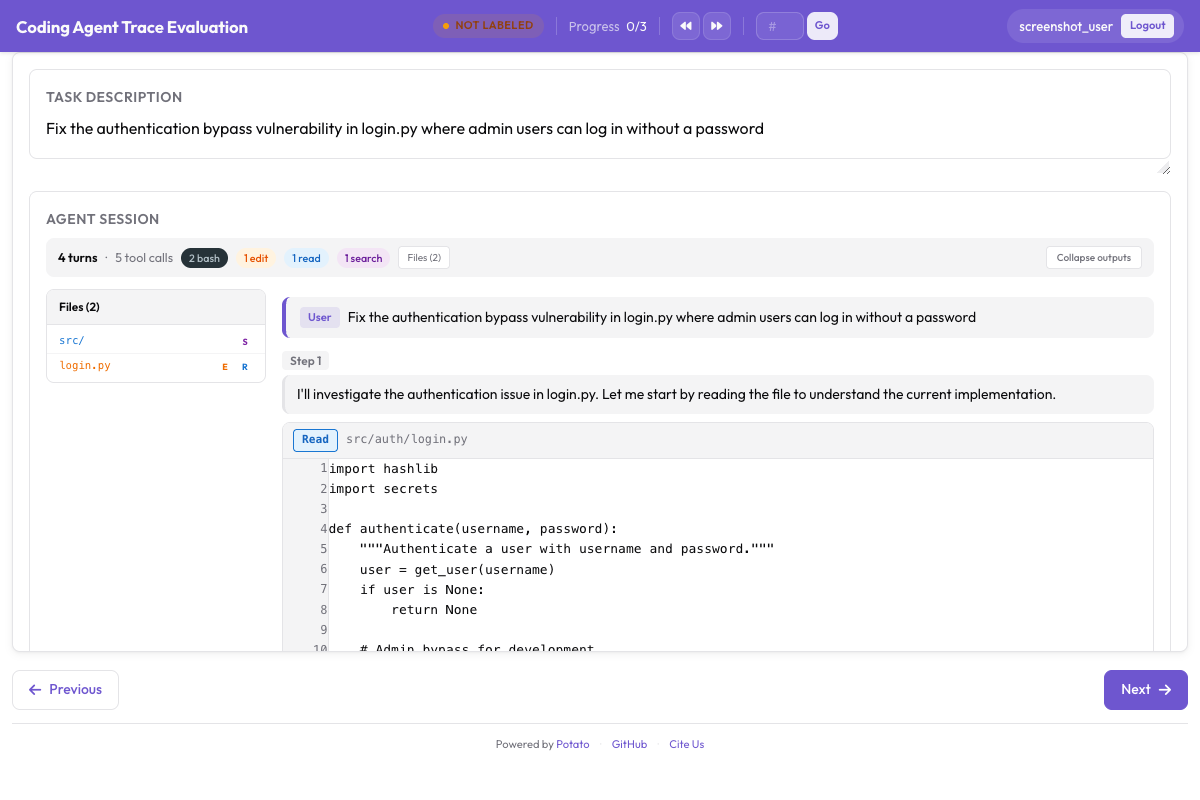 unified diffの描画、シンタックスハイライト、ファイルツリーを備えたPotatoのコーディングトレース表示
coding_trace表示はdiffをファイルツリーとともに描画し、長いターミナル出力を折りたたみます。code_reviewスキーマは、設定可能なカテゴリでの行に紐づくコメント、ファイルごとの評価次元、プルリクエスト形式の判定を集めます。そのうえでcoding_evalエクスポーターが、プロセス報酬モデルのラベル、コードレビューのアノテーション、DPOの選好ペア、SWE-bench互換のスコアを書き出します。これはダッシュボードが必要とする形ではなく、学習データが必要とする形です。
Webエージェントのトレースは、SVGによるアクションのオーバーレイ付きスクリーンショットとフィルムストリップとして描画されます。
 SVGのアクションオーバーレイ付きスクリーンショットとフィルムストリップのナビゲーションを表示するWebエージェントのトレースビューア
マルチエージェントの実行は、1本のステップ列に平坦化されるのではなく、専用のアノテーション画面を持ちます。レジストリには、アノテーターが編集できるインタラクショングラフ、エージェントをまたいだ失敗の帰属、ハンドオフのレビュー、エージェント単位とチーム単位のスコアカード、共有タイムライン上でのツールの競合、創発的な振る舞いのタグ付けのためのスキーマがあります。身体性を持つエージェントやマルチモーダルなエージェントも同様で、コンピューター操作の軌跡、全二重の音声対話、動画の時間的グラウンディングが独立したスキーマとして用意されています。
判断を集めるだけでなく測定する
プロジェクトの中でいちばん遅れて表れる違いは、2人のアノテーターの意見が分かれたあとに何が起きるかです。Potatoは不一致を解消すべき衝突ではなく測定値として扱うため、テキストのアノテーション調査で使うのと同じ一致度統計、裁定キュー、トレーニングフェーズ、ゴールドアイテムが、追加の設定なしでエージェントトレースにも適用されます。Potato自身のツール比較は、2026-06-24時点の確認として、トレーシングプラットフォームは人間の判断をスコアとして集めるよう作られていて、その判断に対する信頼性の統計を文書化しているものはないこと、またLangfuseは同じトレースに対する以前のアノテーションを置き換えるため、独立した二重アノテーションには回避策が必要なことを記録しています。
これは評価が証拠になる場合に重要です。レビューされていない単独の判断から作った成功率には誤差範囲がなく、判断基準がずれてきたレビュアーは、改善したエージェントとまったく同じように見えます。
実行中のエージェントを観察する
Potatoは記録を再生する代わりに、アノテーションページの中でエージェントを実行することもできます。live_agentブロックは視覚モデルをヘッドレスブラウザに接続し、セッションをアノテーターにストリーミングします。アノテーターはセッションを一時停止したり、指示を送ったり、手動操作に切り替えたりできます。
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
事後のレビューに比べてこのセットアップに見合う価値がある状況は3つあります。破壊的な操作の前に実行を止めることは、記録済みのトレースでは提供できない安全策です。実行の途中で人間が操作を引き継いだ記録は、デモンストレーションデータになります。そして、介入からエージェントがどう立て直すかを観察すると、完了したトレースには含まれない問いに答えられます。
組み合わせて使う
本番環境でよくある構成は両方を使うもので、ツールが求めるものが異なるため役割分担ははっきりしています。LangSmithかLangfuseでエージェントを計装し、すべての実行をトレースします。人間の意見に値する実行をサンプリングします。通常は失敗、エッジケース、ランダムな対照サンプルです。それらをPotato用に変換し、1つのトレースに複数のアノテーターを割り当ててアノテーション調査を行い、一致度レポートをスコアとあわせて読みます。エラー分類体系の集計を開発にフィードバックすると、サブタイプの分布から、1つの系統的な失敗があるのか、ロングテールなのかが分かります。
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
選び方
アプリケーションがLangChainやLangGraph上に構築されていて、本番環境の可視性が必要ならLangSmithを選んでください。計装の作業なしでトレースが届き、マネージドサービスなのでインフラの問題もなくなります。同じ可視性を複数のプロバイダーにまたがってオープンソースで得たい、プロンプトのバージョン管理も同じツールで行いたいという場合はLangfuseです。必要な成果物が根拠を示せる人間のラベルのセットである場合、調査で1アイテムあたり複数のアノテーターと一致度の数値が必要な場合、エージェントがコーディング、マルチエージェント、身体性を持つものでトレースに専用の表示が必要な場合、またはデータを自前のインフラに置いておく必要がある場合はPotatoを選んでください。PotatoはGPL-3.0-or-laterのセルフホスト型で、シート単位やトレース単位の費用はかかりません。
ここでのLangSmithとLangfuseに関する記述は、2026-06-24に確認した両者のドキュメントに基づいており、どちらも更新が速いツールです。訂正はGitHubリポジトリで歓迎します。セットアップそのものについてはエージェント評価ガイドを、生のトレースからエクスポートした判断までの一連の例についてはAIエージェントの評価を参照してください。