Anotación de Recompensa de Proceso
Recopila etiquetas de recompensa por paso para modelos de recompensa de proceso con los modos de primer error y por paso, etiquetas neutras opcionales y preetiquetado con LLM verificado por personas.
Novedad en la v2.4.0
Los modelos de recompensa de proceso puntúan los pasos de razonamiento que da un modelo y no solo su respuesta final, así que entrenar uno exige una etiqueta por paso en lugar de una etiqueta por traza. El esquema process_reward recopila esas etiquetas.
Dos modos equilibran velocidad y detalle de forma distinta. El modo de primer error pide un solo clic: el primer paso que sale mal, con todo lo posterior tratado como comprometido. El modo por paso pide un juicio sobre cada paso, lo que cuesta más y captura casos que el primer error no puede, como un agente que se recupera de su propio error.
Ambos funcionan con las vistas de trazas de coding, trazas de agente y cadena de pensamiento.
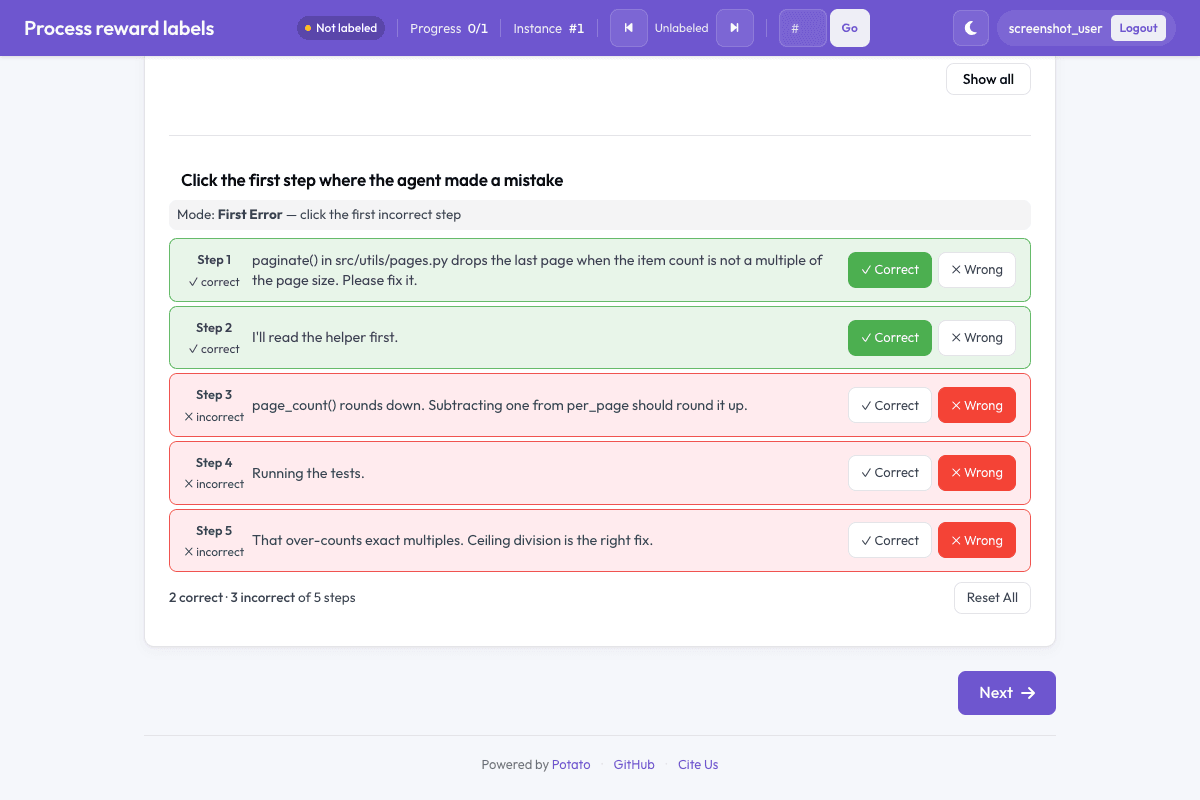 Un clic en el primer paso incorrecto etiqueta toda la traza
Modo de Primer Error
El anotador lee la traza en orden y hace clic en el primer paso incorrecto. Los pasos anteriores se registran como correctos, y el paso señalado y todos los siguientes como incorrectos. Eso produce la secuencia de etiquetas que espera el entrenamiento binario de PRM: 1 hasta el error y -1 desde el error en adelante.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent made a mistake"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
steps_key nombra el campo que contiene la lista de pasos, y step_text_key nombra el campo de cada paso que se muestra.
Flujo de Anotación
- Los pasos empiezan sin marcar
- El anotador hace clic en el primer paso incorrecto
- Todo lo anterior se pone en verde
- Ese paso se marca como el primer error
- Todo lo posterior se marca como comprometido
Los colores hacen visible la cascada, que es el objetivo del modo: un solo juicio etiqueta toda la traza.
Modo por Paso
Cada paso se juzga por separado. Añade allow_neutral para la etiqueta de tres vías al estilo PRM800K, en la que un paso puede no ser ni correcto ni incorrecto:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
allow_neutral solo se aplica en el modo por paso. La cascada del primer error no tiene posición para un paso neutro, así que la opción se ignora ahí.
inline_with_trace: true coloca los controles de valoración en cada paso de la vista en lugar de reunirlos en un panel aparte, lo que conviene en una traza larga donde el anotador perdería el hilo.
Renombrar las Etiquetas
Los tres botones se llaman Correct, Neutral y Wrong de forma predeterminada. reward_labels los renombra para los dominios en los que esas palabras no encajan:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    reward_labels:
      correct: "Valid"
      neutral: "Neutral"
      incorrect: "Flawed"
Segmentar una Cadena de Pensamiento
Las trazas de razonamiento suelen llegar como una única cadena larga y no como una lista de pasos. cot_segmentation la divide antes de que empiece la anotación:
cot_segmentation:
  source_key: reasoning      # the item field holding the long CoT string
  strategy: auto             # blank_line | numbered | markers | sentence | llm | auto
  target_key: cot_steps      # where the step list is written
  min_step_chars: 30         # merge anything shorter into the previous step
  max_steps: 200

instance_display:
  fields:
    - key: cot_steps
      type: cot_trace
      label: "Reasoning"

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
Conviene fijar min_step_chars. Sin él, la segmentación por oraciones y por líneas en blanco produce fragmentos de una línea que los anotadores no pueden juzgar de forma aislada, y la etiqueta resultante es ruido.
Preetiquetado con LLM
Un modelo puede proponer las etiquetas por paso y el anotador confirma o corrige cada una, lo que es más rápido que etiquetar desde cero en trazas largas:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Verify or correct each suggested reward"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
    ai_prelabel: true
    require_verification: true

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    max_tokens: 768
    temperature: 0.1
    include:
      all: true
ai_prelabel añade el botón que solicita sugerencias. require_verification impide aceptar la anotación hasta que cada sugerencia se haya confirmado o cambiado, lo que mantiene la salida como una etiqueta humana y no como la de un modelo.
Deja a max_tokens un margen real. Una cadena de pensamiento larga más un veredicto por paso es una respuesta grande, y una respuesta truncada se muestra como ausencia total de sugerencias.
Qué Contiene la Salida
La anotación se guarda bajo el nombre del esquema como una lista steps junto con el mode en que se recopiló:
{
  "step_rewards": {
    "mode": "per_step",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": 0, "source": "ai", "verified": true, "ai_reward": 0},
      {"reward": null, "source": null, "verified": false}
    ]
  }
}
reward es 1 para correcto, -1 para incorrecto y 0 para neutro. Un paso omitido es null y no 0, de modo que un paso que nadie juzgó se distingue de uno juzgado como ni correcto ni incorrecto. Esa distinción importa cuando las etiquetas pasan a ser datos de entrenamiento, ya que tratar las omisiones como neutras inventa señal sin avisar.
source registra si el valor vino de una persona o de un modelo, y verified si una persona lo confirmó. Con ai_prelabel activado, ai_reward conserva la sugerencia original del modelo incluso después de que un anotador la corrija, lo que permite informar con qué frecuencia acertó el modelo sin una segunda pasada.
Exportación
Potato no tiene un formato de exportación PRM ni DPO integrado. Exporta las anotaciones y dales forma tú mismo:
python -m potato.export -c config.yaml -f jsonl -o ./export/Convertir las anotaciones de primer error en etiquetas de entrenamiento por paso es sencillo, y escribirlo tú mismo te permite decidir cómo se tratan los pasos omitidos:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "steps": [
                    {"content": src, "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_training_data.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Análisis
import json
from collections import Counter
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

print(f"Traces annotated: {len(traces)}")

all_correct = sum(
    1 for t in traces
    if all(s.get("reward") == 1 for s in t.get("steps", []))
)
print(f"Traces with no errors: {all_correct} ({all_correct / len(traces):.1%})")

# Where the first error lands
first_error_positions = []
for t in traces:
    for i, s in enumerate(t.get("steps", [])):
        if s.get("reward") == -1:
            first_error_positions.append(i)
            break

if first_error_positions:
    avg = sum(first_error_positions) / len(first_error_positions)
    print(f"Average first-error position: step {avg:.1f}")
    print("By position:", Counter(first_error_positions).most_common(10))
Cuando ai_prelabel está activado, los mismos registros indican con qué frecuencia sobrevivió la sugerencia del modelo a la revisión:
kept = changed = 0
for t in traces:
    for s in t.get("steps", []):
        if s.get("ai_reward") is None:
            continue
        if s.get("reward") == s.get("ai_reward"):
            kept += 1
        else:
            changed += 1

total = kept + changed
if total:
    print(f"AI suggestions kept: {kept}/{total} ({kept / total:.1%})")
Esa tasa de aceptación es el número que conviene vigilar antes de confiar en el preetiquetado en un dominio nuevo. Una tasa cercana al 100 % suele indicar que los anotadores confirman en lugar de comprobar, no que el modelo acierte.
Contexto de Investigación
La anotación de recompensa de proceso existe para apoyar el trabajo sobre modelos de recompensa para sistemas de varios pasos, donde el hallazgo que motiva todo el enfoque es que una respuesta final correcta puede apoyarse en un razonamiento defectuoso. Las etiquetas por paso separan ambas cosas, y los modos de primer error y por paso de aquí se corresponden con los formatos de etiqueta que usa esa línea de trabajo.
Para el diseño de la taxonomía y las cuestiones de acuerdo que la acompañan, consulta la localización de errores por paso, que cubre las mismas trazas desde el lado de la clasificación de errores.
Véase También
- Anotación de Agentes de Coding - muestra y anota trazas de agentes de coding
- Anotación Agéntica - anotación general de trazas de agentes
- Formatos de Exportación - los formatos que Potato sí exporta
- Control de Calidad - acuerdo y adjudicación
- Ajuste fino de un LLM con tus anotaciones - entrenar un modelo de recompensa de procesos con las valoraciones de pasos mediante
prm-reward
Para detalles de implementación, consulta la documentación fuente.