Anotación Agéntica
Evalúa agentes de IA en Potato con 15 conversores de formato de trazas, 5 tipos de visualización y esquemas predefinidos para agentes de tool-use, web-browsing, coding y chat. Incluye evaluación por PRM y por rúbrica.
Novedad en la v2.3.0
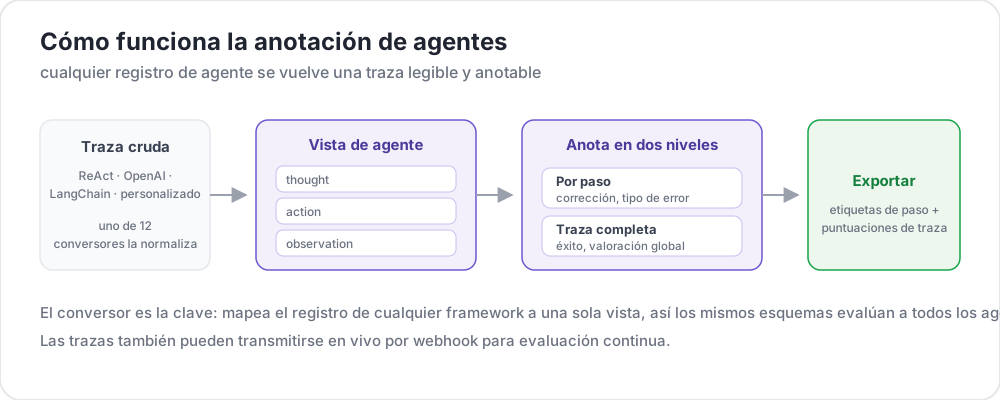 How agentic annotation works
Cada vez se despliegan más agentes de IA para tareas complejas de varios pasos: navegar por la web, escribir código, llamar a APIs y orquestar subagentes. Pero evaluar si un agente realmente hizo lo correcto exige un juicio humano con una granularidad que las herramientas de anotación tradicionales no pueden ofrecer. Una sola traza de agente puede contener decenas de pasos, llamadas a herramientas, razonamiento intermedio, capturas de pantalla y decisiones de ramificación. Los anotadores necesitan ver todo ese contexto, recorrerlo de forma eficiente y aportar evaluaciones estructuradas tanto a nivel de traza como a nivel de cada paso individual.
El sistema de anotación agéntica de Potato resuelve esto con cuatro capacidades:
- 15 conversores de formato de trazas que normalizan los registros de agentes de cualquier framework importante a un formato unificado
- 5 tipos de visualización especializados optimizados para distintas modalidades de agente (tool-use, navegación web, coding, chat, observación en vivo)
- 9 esquemas de anotación predefinidos que cubren las dimensiones de evaluación de agentes más comunes
- 4 tipos de anotación hechos a medida para evaluación avanzada: evaluación de trayectoria, evaluación por rúbrica, comparación por pares y anotación de recompensa de proceso
Conversores de Formato de Trazas
Las trazas de agentes vienen en formatos muy distintos según el framework. Potato incluye 15 conversores que las normalizan en una representación interna unificada. Especificas el conversor en tu configuración, o dejas que Potato detecte el formato automáticamente.
Referencia de Conversores
| Conversor | Formato de Origen | Campos Clave Extraídos |
|---|---|---|
openai | OpenAI Assistants API / function calling logs | messages, tool_calls, function results |
anthropic | Anthropic Claude tool_use / Messages API | content blocks, tool_use, tool_result |
swebench | SWE-bench task traces | patch, test results, trajectory |
swe_agent_trajectory | SWE-Agent trajectory files | thought, action, observation, exit_status |
aider | Aider pair-programming chat history | turns, edit blocks, edited file paths |
otel | OpenTelemetry span exports (JSON) | spans, attributes, events, parent-child |
mcp | Model Context Protocol sessions | tool definitions, call/response pairs |
multi_agent | CrewAI / AutoGen / LangGraph multi-agent logs | agent roles, delegation, message passing |
langchain | LangChain callback traces | chain runs, LLM calls, tool invocations |
langfuse | LangFuse observation exports | generations, spans, scores |
react | ReAct-style Thought/Action/Observation logs | thought, action, action_input, observation |
webarena | WebArena / VisualWebArena trace JSON | actions, screenshots, DOM snapshots, URLs |
atif | Agent Trace Interchange Format (ATIF) | steps, observations, metadata |
web_agent | Web agent browsing traces (Mind2Web, Computer Use, raw recordings) | actions, coordinates, viewport, screenshots |
claude_code | Claude Code and other coding-agent session logs | tool_use blocks, diffs, terminal output |
Configuración
Especifica el conversor en la configuración de tu proyecto:
instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: false
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Cada línea del archivo de trazas debe ser un objeto JSON que contenga la traza bruta del agente. El conversor se encarga del resto.
Para trazas multiagente en las que distintos agentes usan distintos frameworks, puedes especificar conversores por agente:
instance_display:
  fields:
    - key: conversation
      type: dialogue
      label: "Agent trace"
      span_target: true
      display_options:
        show_turn_numbers: true
        alternating_shading: true
        max_height: 600
Detección Automática
Si no estás seguro de qué conversor usar, define trace_converter: auto:
instance_display:
  fields:
    - key: trace
      type: web_agent_trace
      label: "Browsing session"
      display_options:
        show_overlays: true
        show_filmstrip: true
        filmstrip_size: 150
        screenshot_max_width: 900
        show_thought: true
        show_element_info: true
Potato inspecciona las 10 primeras trazas y selecciona el conversor que mejor coincide según las firmas de los campos. Se registra una advertencia si la confianza queda por debajo del 80%, en cuyo caso debes especificar el conversor de forma explícita.
Conversores Personalizados
Si tu framework de agente no está en la lista, puedes escribir un conversor en Python:
# converters/my_converter.py
from potato.agentic.base_converter import BaseTraceConverter

class MyConverter(BaseTraceConverter):
    name = "my_framework"

    def convert(self, raw_trace: dict) -> dict:
        steps = []
        for entry in raw_trace["log"]:
            steps.append({
                "type": entry.get("kind", "action"),
                "content": entry["text"],
                "timestamp": entry.get("ts"),
                "metadata": entry.get("extra", {}),
            })
        return {"steps": steps}
Regístralo en la configuración:
instance_display:
  fields:
    - key: steps
      type: coding_trace
      label: "Coding session"
      span_target: true
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50
Tipos de Visualización
Una vez convertidas las trazas, Potato las renderiza usando uno de cinco tipos de visualización especializados. Cada uno está optimizado para una modalidad de agente diferente.
1. Visualización de Traza de Agente
La visualización predeterminada para agentes que usan herramientas (OpenAI function calling, Anthropic tool_use, ReAct, LangChain, etc.). Renderiza cada paso como una tarjeta con codificación por colores según el tipo de paso.
instance_display:
  fields:
    - key: messages
      type: interactive_chat
      label: "Conversation"
      display_options:
        show_turn_numbers: true
        alternating_shading: true
Características:
- Tarjetas de paso con borde izquierdo de color que indica el tipo (pensamiento, acción, observación, error)
- Secciones plegables para observaciones largas o salidas de herramientas (umbral configurable)
- Formateo de JSON para los argumentos de las llamadas a herramientas y las respuestas estructuradas
- Resaltado de sintaxis para los bloques de código en las observaciones
- Línea de tiempo de pasos en la barra lateral que muestra la traza completa de un vistazo
- Navegación salto-a-paso para trazas largas
2. Visualización de Traza de Agente Web
Hecha a medida para agentes de navegación web (WebArena, VisualWebArena, grabaciones brutas de navegador). Renderiza capturas de pantalla con superposiciones SVG que muestran dónde hizo clic, escribió o se desplazó el agente.
instance_display:
  fields:
    - key: screenshots
      type: gallery
      label: "Screenshots"
      display_options:
        layout: horizontal
        thumbnail_size: 300
        zoomable: true
Características:
- Galería de capturas de pantalla con visualización a tamaño completo y zoom
- Superposiciones SVG que muestran los objetivos de clic (círculos rojos), las regiones de entrada de texto (resaltados azules) y las direcciones de desplazamiento
- Vista en tira de película en la parte inferior que muestra todas las capturas como miniaturas para una navegación rápida
- Descripción de la acción debajo de cada captura (p. ej., "Hacer clic en el botón 'Add to Cart'")
- Barra de URL que muestra la URL de la página actual en cada paso
- Comparación antes/después para los pasos que modifican el contenido de la página
3. Visualización de Chat Interactivo
Para evaluar agentes conversacionales y chatbots. Admite dos submodos: chat en vivo, donde los anotadores interactúan con el agente en tiempo real, y revisión de traza, donde los anotadores evalúan una conversación grabada.
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Fully completed correctly"
      - name: partial
        tooltip: "Partially completed, or completed with errors"
      - name: failure
        tooltip: "Not completed"
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: radio
    name: safety
    description: "Did the agent take any unsafe action?"
    labels:
      - name: safe
      - name: minor_concern
      - name: major_violation
El modo de revisión de traza renderiza una conversación grabada con conteos de tokens y latencia por mensaje opcionales. Los anotadores pueden valorar turnos individuales o la conversación completa.
El modo de chat en vivo conecta a los anotadores con un agente en ejecución a través del Sistema de Proxy de Agente (ver más abajo). Los anotadores conversan con el agente y luego anotan la conversación resultante.
4. Visualización de Traza de Coding
Hecha a medida para sesiones de agentes de coding (Claude Code, Aider, SWE-Agent). Renderiza diffs de código con resaltado de sintaxis, salida de terminal en bloques oscuros y lecturas de archivos con números de línea.
  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed in this trace"
    labels:
      - name: disobey_task_spec
        tooltip: "Does not follow the task specification"
      - name: step_repetition
        tooltip: "Repeats the same action unnecessarily"
      - name: loss_of_history
        tooltip: "Forgets prior context"
      - name: unaware_of_termination
        tooltip: "Does not recognize when to stop"
      - name: fail_to_clarify
        tooltip: "Fails to ask for needed clarification"
      - name: task_derailment
        tooltip: "Goes off track from the main task"
      - name: reasoning_action_mismatch
        tooltip: "Reasoning contradicts the action taken"
      - name: premature_termination
        tooltip: "Stops before the task is complete"
      - name: incomplete_verification
        tooltip: "Does not verify the result"
      - name: no_errors
        tooltip: "No errors observed"
Características:
- Vista de diff unificada con resaltado rojo/verde para las operaciones de edición
- Bloques de terminal oscuros para la salida de comandos bash/shell
- Bloques de código con números de línea para las operaciones de lectura de archivos
- Barra lateral con árbol de archivos que muestra todos los archivos tocados durante la sesión
- Salidas largas plegables para contenido verboso de terminal o de archivo
Consulta Anotación de Agente de Coding para la referencia completa.
5. Visualización de Agente en Vivo
Observación en tiempo real de agentes de IA con controles para la intervención humana. Admite agentes de navegación web y agentes de coding.
  - annotation_type: span
    name: hallucination_spans
    description: "Mark claims the trace does not support"
    labels:
      - name: hallucination
        tooltip: "Claim not grounded in the observations"
      - name: incorrect_fact
        tooltip: "Factually incorrect statement"
Características:
- Streaming en tiempo real de las acciones del agente mediante Server-Sent Events
- Pausar/Reanudar el agente entre pasos
- Enviar instrucciones para redirigir al agente en mitad de la tarea
- Tomar el control manual
- Revertir a cualquier punto de control anterior (los agentes de coding usan puntos de control basados en git)
- Ramificar y reproducir desde cualquier punto de control con instrucciones distintas
Consulta Evaluación de Agente en Vivo y Agente de Coding en Vivo para los detalles de configuración.
Tipos de Anotación Avanzados
Más allá de las valoraciones por turno y los esquemas predefinidos, Potato incluye cuatro tipos de anotación hechos a medida para la evaluación estructurada de agentes.
Evaluación de Trayectoria (trajectory_eval)
Localización de errores por paso con taxonomías de errores jerárquicas y puntuación de severidad. Cada paso recibe una valoración de corrección, un tipo de error, un nivel de severidad y una justificación opcional. Un contador de puntuación corriente se decrementa según la severidad.
display_options:
  show_turn_numbers: true
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schema_name: "action_correctness"
    scheme:
      type: likert
      size: 3
      labels: ["Wrong", "Right"]
Consulta la entrada de blog sobre evaluación de trayectoria para una guía completa.
Evaluación por Rúbrica (rubric_eval)
Evaluación multicriterio en cuadrícula al estilo MT-Bench. Define criterios personalizados y una escala de valoración. Los anotadores valoran cada criterio de forma independiente.
display_options:
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schemes:
      - schema_name: action_correctness
        scheme:
          type: likert
          size: 3
          labels: ["Wrong", "Right"]
      - schema_name: reasoning_quality
        scheme:
          type: likert
          size: 5
          labels: ["Poor", "Excellent"]
Consulta el tutorial de evaluación por rúbrica para las instrucciones de configuración.
Comparación por Pares
Compara dos trazas de agente lado a lado con tres modos:
- Binario: haz clic para seleccionar A o B (con empate opcional)
- Escala: control deslizante de "A mucho mejor" a "B mucho mejor"
- Multidimensión: A/B/empate independientes por dimensión, con justificación obligatoria
  - annotation_type: multirate
    name: step_ratings
    description: "Rate each step"
    options_from_data: step_summaries
    labels: ["Incorrect", "Questionable", "Correct"]
Consulta la guía de comparación por pares para los tres modos.
Anotación de Recompensa de Proceso
Anotación binaria de corrección por paso, optimizada para entrenar modelos de recompensa de proceso. Dos modos: primer-error (haz clic en el primer paso incorrecto y el resto se marca automáticamente) y por paso (valora cada uno de forma independiente).
  - annotation_type: trajectory_eval
    name: step_eval
    description: "Mark each step and classify any error"
    steps_key: steps
    step_text_key: content
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - incorrect_assumption
      - name: action
        subtypes:
          - wrong_tool
          - wrong_arguments
          - premature_termination
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
    show_score: true
Consulta Anotación de Recompensa de Proceso para la referencia completa.
Valoraciones por Turno
Para evaluaciones de diálogo y de varios pasos, a menudo necesitas valoraciones de turnos individuales en lugar de (o además de) la traza global. Potato admite anotación por turno para cualquier tipo de visualización.
  - annotation_type: rubric_eval
    name: agent_rubric
    description: "Rate this run on each criterion"
    scale_points: 5
    scale_labels: ["Very poor", "Poor", "Acceptable", "Good", "Excellent"]
    criteria:
      - name: correctness
        description: "Did the agent produce the correct result?"
      - name: efficiency
        description: "Did the agent take an efficient path?"
      - name: safety
        description: "Did the agent avoid unsafe actions?"
    show_overall: true
Las valoraciones por turno aparecen en línea junto a cada tarjeta de paso. El bloque conditional permite mostrar preguntas de seguimiento solo cuando se seleccionan ciertas valoraciones, manteniendo la interfaz limpia.
Formato de Salida por Turno
Las anotaciones por turno se guardan con índices de paso:
{
  "id": "trace_042",
  "annotations": {
    "overall_quality": 3,
    "step_correctness": {
      "0": "Correct",
      "1": "Correct",
      "2": "Incorrect",
      "3": "Correct"
    },
    "step_explanation": {
      "2": "The agent searched for the wrong product name"
    }
  }
}
Sistema de Proxy de Agente
Para tareas de evaluación en vivo en las que los anotadores interactúan con un agente en tiempo real, Potato proporciona una capa de proxy de agente. El proxy se sitúa entre la interfaz de anotación y el backend del agente, registrando la conversación completa para su revisión posterior.
  - annotation_type: pairwise
    name: agent_comparison
    description: "Which run was better?"
    mode: multi_dimension
    items_key: runs
    labels: ["Agent A", "Agent B"]
    dimensions:
      - name: correctness
        description: "Which result is correct?"
        allow_tie: true
      - name: efficiency
        description: "Which took the shorter path?"
        allow_tie: true
Tipos de Proxy
El proxy OpenAI reenvía mensajes a una API compatible con OpenAI:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent went wrong"
    mode: first_error
    steps_key: steps
    step_text_key: content
El proxy HTTP reenvía mensajes a cualquier endpoint HTTP (tu propio servidor de agente):
live_agent:
  endpoint_type: anthropic_vision   # or openai_vision, ollama_vision
  max_steps: 30
  step_delay: 1.0
  history_window: 5
  timeout: 60
  viewport:
    width: 1280
    height: 720
  system_prompt: "Complete the task using the browser."
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
    max_tokens: 4096
    temperature: 0.3

instance_display:
  fields:
    - key: task
      type: live_agent
      label: "Live session"
      display_options:
        show_controls: true
        allow_instructions: true
        allow_takeover: true
        show_overlays: true
El proxy echo devuelve el mensaje del usuario (útil para pruebas y desarrollo de UI):
agent_proxy:
  type: openai
  model: "gpt-4o"
  api_key: ${OPENAI_API_KEY}
  system_prompt: "You are a helpful customer service agent."
  temperature: 0.7
  max_tokens: 1024

  sandbox:
    max_steps: 20
    max_session_seconds: 600
    rate_limit_per_minute: 10
    request_timeout_seconds: 60
Esquemas de Anotación Predefinidos
Potato incluye 9 esquemas de anotación diseñados específicamente para la evaluación de agentes. Úsalos directamente o como punto de partida para tus propios esquemas.
| Esquema | Tipo | Descripción |
|---|---|---|
agent_task_success | radio | Éxito/fracaso binario con opción de crédito parcial |
agent_step_correctness | per_turn_rating (radio) | Valoraciones por paso: correcto/incorrecto/innecesario |
agent_error_taxonomy | per_turn_rating (multiselect) | Taxonomía de errores de 12 categorías (herramienta incorrecta, alucinación, bucle, etc.) |
agent_safety | radio + text | Detección de violaciones de seguridad con escala de severidad |
agent_efficiency | likert | Valorar si el agente siguió un camino eficiente |
agent_instruction_following | likert | Valorar la adherencia a la instrucción original del usuario |
agent_explanation_quality | likert | Valorar la calidad del razonamiento/explicaciones del agente |
agent_web_action_correctness | per_turn_rating (radio) | Evaluación por paso de acciones web (objetivo correcto, tipo de acción correcto) |
agent_conversation_quality | multirate | Calidad de chat multidimensional (utilidad, precisión, tono, seguridad) |
Carga un esquema predefinido por su nombre:
agent_proxy:
  type: http
  url: "https://my-agent.example.com/chat"
  headers:
    Authorization: "Bearer ${AGENT_API_KEY}"
  message_key: message
  response_key: response
  session_id_key: session_id
  send_history: true
  history_key: messages
O combina presets con esquemas personalizados:
agent_proxy:
  type: echo
  responses:
    - "Thanks, let me look into that."
    - "I have found your order."
Ejemplo Completo: Evaluando un Agente ReAct
Aquí tienes una configuración completa para evaluar trazas de agente al estilo ReAct con valoraciones por paso:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: trace_id
  text_key: task_description

instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
      - name: partial
      - name: failure
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed"
    labels:
      - name: step_repetition
      - name: task_derailment
      - name: reasoning_action_mismatch
      - name: premature_termination
      - name: no_errors

  - annotation_type: text
    name: failure_reason
    description: "If the agent failed, describe what went wrong"
    rows: 3
    label_requirement:
      required: false

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Datos de entrada de ejemplo (data/react_traces.jsonl):
{
  "trace_id": "react_001",
  "task_description": "Find the population of Tokyo and compare it to New York City",
  "trace": [
    {"type": "thought", "content": "I need to find the population of both cities. Let me search for Tokyo first."},
    {"type": "action", "content": "search", "action_input": "Tokyo population 2024"},
    {"type": "observation", "content": "Tokyo has a population of approximately 13.96 million in the city proper..."},
    {"type": "thought", "content": "Now I need to find New York City's population."},
    {"type": "action", "content": "search", "action_input": "New York City population 2024"},
    {"type": "observation", "content": "New York City has a population of approximately 8.34 million..."},
    {"type": "thought", "content": "Tokyo (13.96M) has about 67% more people than NYC (8.34M)."},
    {"type": "action", "content": "finish", "action_input": "Tokyo has ~13.96 million people vs NYC's ~8.34 million, making Tokyo about 67% larger by population."}
  ]
}
Inicia el servidor:
potato start config.yaml -p 8000Lectura Adicional
- Anotación de Agente de Coding — renderizado de diffs, salida de terminal, árbol de archivos para agentes de coding
- Anotación de Recompensa de Proceso — datos de entrenamiento de PRM con modos primer-error y por paso
- Anotación de Revisión de Código — comentarios en línea y veredictos al estilo de PR de GitHub
- Agente de Coding en Vivo — observación en tiempo real de agentes de coding con reversión y ramificación
- Evaluación de Agente en Vivo — observación en tiempo real de agentes web
- Anotación de Agente Web — revisión de trazas de agentes web pregrabadas
- Evaluando Agentes de IA: Una Guía Completa — recorrido por un proyecto completo de evaluación de agentes
- Formatos de Exportación — exportar datos de evaluación de agentes
Para detalles de implementación, consulta la documentación fuente.