Aprendizaje Activo
Reordena la cola de anotación de Potato según la incertidumbre del modelo, con cinco estrategias de consulta, clasificadores de sklearn, manejo del arranque en frío y persistencia del modelo entre reinicios.
El aprendizaje activo reordena la cola de anotación para que los anotadores vean las instancias sobre las que un modelo tiene menos certeza, en lugar de recorrer el corpus en el orden en que llegó.
Cómo Funciona
- Recopila un conjunto inicial de anotaciones
- Entrena un clasificador con lo que se ha etiquetado hasta el momento
- Puntúa la incertidumbre del conjunto sin etiquetar
- Reordena la cola para poner primero las instancias más inciertas
- Anota las instancias priorizadas
- Reentrena periódicamente a medida que se acumulan las anotaciones
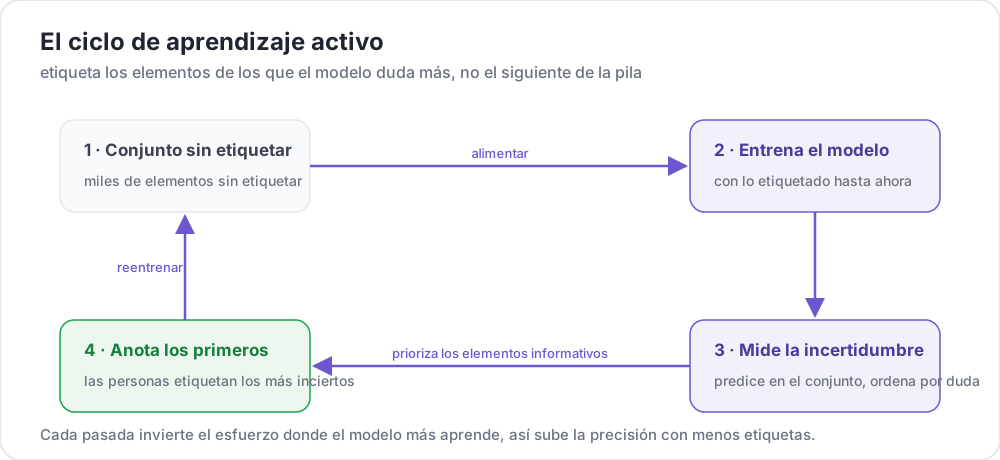 Invierte el esfuerzo de anotación donde el modelo más aprende
Configuración
Configuración Básica
active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000
min_instances_for_training tiene como valor predeterminado 10, y update_frequency, 5. Ambos valores son lo bastante bajos como para que convenga subirlos en un proyecto real, ya que reentrenar cada cinco anotaciones gasta cómputo en un modelo que apenas ha cambiado.
Configuración Completa
active_learning:
  enabled: true

  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000

  # How disagreement between annotators resolves into one training label
  resolution_strategy: majority_vote

  # Fraction of the queue left in random order, so the model does not
  # only ever see what it already found interesting
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
Los bloques anidados classifier, vectorizer y model_persistence son la forma documentada y la que reconoce potato validate --strict. Sus subclaves son name y hyperparameters en los dos primeros, y enabled, save_directory y retention_count en el tercero. Un bloque que use otros nombres de subclave se ignora sin ningún aviso, y la ejecución vuelve en silencio a los valores predeterminados.
Estrategias de Consulta
| Estrategia | Descripción |
|---|---|
uncertainty | Instancias en las que el modelo tiene menos confianza. Es la opción predeterminada |
diversity | Instancias menos parecidas a lo que ya se ha anotado |
badge | Batch Active learning by Diverse Gradient Embeddings |
bald | Bayesian Active Learning by Disagreement |
hybrid | Una combinación ponderada de incertidumbre y diversidad |
active_learning:
  query_strategy: uncertainty
Un nombre de estrategia no reconocido vuelve a uncertainty con una advertencia en lugar de impedir el arranque, así que revisa el registro si una estrategia parece no tener efecto.
Ajuste de Hybrid y BALD
hybrid usa por defecto un 70% de incertidumbre y un 30% de diversidad:
active_learning:
  query_strategy: hybrid
  hybrid_weights:
    uncertainty: 0.7
    diversity: 0.3
bald entrena un pequeño ensamble y ordena según el desacuerdo entre sus miembros:
active_learning:
  query_strategy: bald
  bald_params:
    n_estimators: 5
    bootstrap_fraction: 0.8
Clasificadores
Los clasificadores se nombran por su ruta de importación de sklearn. El predeterminado es sklearn.linear_model.LogisticRegression.
| Clasificador | Ruta | Ideal para | Velocidad |
|---|---|---|---|
| Regresión logística | sklearn.linear_model.LogisticRegression | La mayoría de las tareas de texto | Rápida |
| Random Forest | sklearn.ensemble.RandomForestClassifier | Patrones no lineales | Media |
| SVC | sklearn.svm.SVC | Conjuntos de datos pequeños | Lenta |
| Multinomial NB | sklearn.naive_bayes.MultinomialNB | Clasificación de texto sencilla | Muy rápida |
Regresión logística, el punto de partida recomendado:
active_learning:
  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000
Random forest, cuando la frontera de decisión no se aproxima a una lineal:
active_learning:
  classifier:
    name: sklearn.ensemble.RandomForestClassifier
    hyperparameters:
      n_estimators: 100
      max_depth: 10
A un SVC hay que indicarle que produzca probabilidades, ya que la puntuación de incertidumbre depende de ellas:
active_learning:
  classifier:
    name: sklearn.svm.SVC
    hyperparameters:
      kernel: rbf
      probability: true
Naive Bayes, cuando la velocidad importa más que el último punto de precisión:
active_learning:
  classifier:
    name: sklearn.naive_bayes.MultinomialNB
    hyperparameters:
      alpha: 1.0
calibrate_probabilities está activado por defecto. Esto importa porque el muestreo por incertidumbre ordena según la probabilidad predicha, y un clasificador sin calibrar trata los elementos en los que se equivoca con mucha confianza como si ya estuvieran resueltos.
Vectorizadores
El predeterminado es sklearn.feature_extraction.text.TfidfVectorizer.
TF-IDF, características ponderadas:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]
      stop_words: english
Conteos simples:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.CountVectorizer
    hyperparameters:
      max_features: 3000
      ngram_range: [1, 1]
Hashing, para un vocabulario demasiado grande para guardarlo en memoria:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.HashingVectorizer
    hyperparameters:
      n_features: 10000
ngram_range se escribe como una lista YAML y se convierte en la tupla que espera sklearn, así que [1, 2] es correcto aquí y no requiere ninguna sintaxis especial.
Arranque en Frío
Antes de que exista un modelo no hay nada sobre lo que tener incertidumbre, así que el primer lote se elige sin él:
active_learning:
  cold_start_strategy: random
  cold_start_batch_size: 20
Selección Asistida por LLM
Un LLM puede puntuar instancias durante el periodo de arranque en frío o junto al clasificador:
active_learning:
  enabled: true
  schema_names:
    - sentiment

  llm:
    enabled: true
    endpoint_type: vllm
    base_url: http://localhost:8000/v1
    model: meta-llama/Llama-3.2-3B-Instruct
    confidence_method: verbalized
confidence_method determina cómo se obtiene la puntuación de confianza, y la elección importa porque esa puntuación guía la selección:
| Método | Cómo funciona | Compromiso |
|---|---|---|
verbalized | El modelo informa su propia confianza en una escala de 1 a 10 | Funciona con cualquier modelo, pero es poco fiable en algunos |
logprobs | Se calcula a partir de las log-probabilidades de los tokens | La mejor calibrada, requiere un endpoint que devuelva logprobs |
consistency | Se consulta la misma instancia varias veces y se puntúa según el acuerdo entre respuestas | Funciona en cualquier sitio, a costa de N llamadas por instancia |
logprobs recurre a la confianza verbalizada cuando el endpoint no las devuelve.
Persistencia del Modelo
Los modelos entrenados pueden sobrevivir a un reinicio en lugar de reconstruirse desde cero:
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
retention_count tiene como valor predeterminado 2 y limita cuántos modelos guardados se conservan.
La persistencia respaldada por base de datos ya no es configurable. Las claves database_enabled y database_config se eliminaron porque la capa que había detrás era un stub que registraba éxito y no almacenaba nada. El historial de ejecuciones ahora se registra siempre y no necesita configuración, y ambas claves se ignoran si una configuración todavía las incluye.
Múltiples Esquemas
schema_names enumera los esquemas cuyas anotaciones entrenan el modelo. Si no se define, toma por defecto los esquemas etiquetables del proyecto:
annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels: [Positive, Negative, Neutral]

  - annotation_type: radio
    name: topic
    description: "What is the topic?"
    labels: [Politics, Sports, Tech, Entertainment]

active_learning:
  enabled: true
  schema_names:
    - sentiment
    - topic
Configuración Completa de Ejemplo
annotation_task_name: "Sentiment Analysis with Active Learning"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 30
  update_frequency: 50
  max_instances_to_reorder: 500
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5

output_annotation_dir: "output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Combinación con Soporte de IA
El aprendizaje activo decide qué mostrar a continuación. El soporte de IA ayuda al anotador con lo que tenga en pantalla. Son independientes y se pueden combinar:
active_learning:
  enabled: true
  schema_names:
    - sentiment
  min_instances_for_training: 30

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true
Interpreta el resultado con cuidado. Si el modelo sugiere una etiqueta y el anotador la acepta, y un modelo de la misma familia eligió la instancia, el acuerdo que midas al final es en parte el modelo coincidiendo consigo mismo.
Monitoreo
El panel de administración muestra la precisión del modelo, el número de ciclos de entrenamiento, cómo se distribuye la incertidumbre y cuántas instancias quedan. Para acceder a él se necesita la clave de administrador o un rol que tenga view_admin_dashboard.
Mejores Prácticas
Recopila Primero una Línea Base
No se puede entrenar nada con un conjunto vacío, y un modelo entrenado con veinte anotaciones sobre todo reordena ruido:
active_learning:
  min_instances_for_training: 50
Vigila el Equilibrio de Clases
El muestreo por incertidumbre se concentra en la frontera de decisión, lo que desvía la distribución de etiquetas respecto a la del corpus. Eso está bien para entrenar un modelo, pero induce a error si presentas la muestra anotada como una descripción de los datos. random_sample_percent mantiene sin sesgo una parte de la cola precisamente por este motivo.
No Reentrenes con Demasiada Frecuencia
active_learning:
  update_frequency: 100
Conserva los Modelos entre Reinicios
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
Solución de Problemas
El entrenamiento nunca empieza
Comprueba que las anotaciones hayan alcanzado min_instances_for_training y que cada clase tenga al menos un ejemplo. Con un conjunto de entrenamiento de una sola clase no se puede ajustar un clasificador.
El reordenamiento parece no hacer nada
Busca en el registro un query_strategy desconocido, que vuelve a uncertainty en silencio. Confirma que está enabled: true y que schema_names nombra esquemas que existen de verdad.
Lentitud con un conjunto grande
Reduce max_instances_to_reorder, aumenta update_frequency o cambia a HashingVectorizer para un vocabulario muy grande.
Lectura Adicional
- Soporte de IA - Asistencia de LLM durante la anotación
- Asignación de Tareas - Las demás estrategias de asignación
- Panel de Administración - Monitoreo del ciclo de entrenamiento
- Ordenamiento por Diversidad - Ordenamiento basado en embeddings sin clasificador
Para detalles de implementación, consulta la documentación fuente.