Evaluación de agentes de IA: anotación humana de trazas de agentes
Cómo configurar en Potato la evaluación humana de la salida de agentes de IA, desde la importación de trazas y el diseño de esquemas a nivel de traza y por paso hasta el análisis de los resultados exportados.
Convierte las trazas de agentes con python -m potato.trace_converter, muéstralas en un campo de visualización agent_trace y recoge un veredicto a nivel de traza junto con un juicio trajectory_eval por paso. El juicio por paso es la parte que localiza el paso en el que la ejecución se torció.
Una tasa de éxito te dice con qué frecuencia un agente termina la tarea y nada sobre por qué fallaron los fallos. Dos agentes con la misma tasa de éxito del 62% pueden estar fallando por razones completamente distintas, uno porque elige la herramienta equivocada y el otro porque razona correctamente sobre una recuperación mala, y la corrección es diferente en cada caso. La evaluación humana a nivel de paso los separa, porque el anotador marca qué paso se rompió y qué tipo de rotura fue.
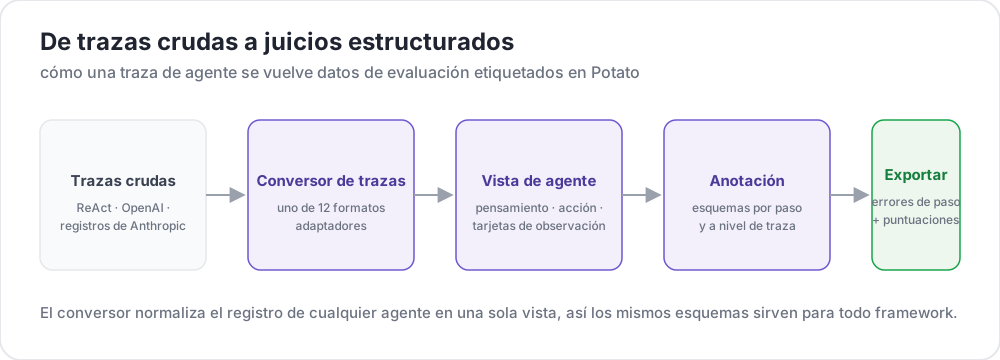 De las trazas en bruto a juicios estructurados
Esta guía construye el pipeline para un agente de estilo ReAct que responde preguntas buscando en la web. Las configuraciones están comprobadas contra Potato 2.9.1:
pip install --upgrade potato-annotationPaso 1: convertir las trazas
Potato registra 15 convertidores de trazas, y la CLI los lista con sus descripciones:
python -m potato.trace_converter --list-formatsLa lista incluye react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code y aider. Las exportaciones de ejecuciones de LangSmith pasan por langchain, y los logs de CrewAI, AutoGen y LangGraph pasan por multi_agent.
El convertidor react lee una traza cuyos pasos llevan las claves thought, action y observation:
{
  "id": "trace_001",
  "task": "What is the capital of Australia and what is its population?",
  "steps": [
    {"thought": "I need the capital of Australia and then its population.",
     "action": "search('capital of Australia')",
     "observation": "Canberra is the capital city of Australia."},
    {"thought": "Now I need Canberra's population.",
     "action": "search('Canberra population 2025')",
     "observation": "Canberra has a population of approximately 467,000 as of 2025."},
    {"thought": "I have both pieces of information.",
     "action": "finish('Canberra, approximately 467,000')"}
  ],
  "metadata": {"agent": "GPT-4", "tokens": 2340}
}
Un solo comando convierte el archivo:
python -m potato.trace_converter \
  --input raw_traces.json \
  --input-format react \
  --output data/traces.jsonl
Pasa --auto-detect en lugar de --input-format cuando no tengas claro qué convertidor encaja, y el registro elegirá uno a partir de las firmas de los campos. Indica el formato explícitamente en cuanto lo conozcas, porque la detección toma el primer convertidor que coincide y varios formatos se solapan en los campos que llevan.
Todos los convertidores escriben la misma forma canónica, y eso es lo que permite que una misma configuración funcione con distintos frameworks. Cada línea lleva id, task_description y conversation, una lista de turnos con un speaker y un text. Un convertidor que disponga de ellos escribe también agent_name, metadata_table y screenshots:
{
  "id": "trace_001",
  "task_description": "What is the capital of Australia and what is its population?",
  "agent_name": "GPT-4",
  "metadata_table": [{"Property": "Steps", "Value": "3"},
                     {"Property": "tokens", "Value": "2340"}],
  "conversation": [
    {"speaker": "Agent (Thought)", "text": "I need the capital of Australia and then its population."},
    {"speaker": "Agent (Action)", "text": "search('capital of Australia')"},
    {"speaker": "Environment", "text": "Canberra is the capital city of Australia."}
  ]
}
Paso 2: mostrar la traza
La visualización agent_trace muestra cada turno como una tarjeta, con un color según el tipo de paso, de modo que el anotador lee la ejecución y no un bloque de JSON:

instance_display decide qué aparece en la página y en qué orden. La descripción de la tarea va arriba porque el anotador tiene que saber qué se le pidió al agente antes de que cualquier paso signifique algo, y la tabla de metadatos va debajo en un campo compacto de hoja de cálculo:
instance_display:
  layout:
    direction: vertical
    gap: 16px

  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120

    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Colapsar las observaciones evita que los resultados de búsqueda largos empujen el resto de la traza fuera de la pantalla, ya que una traza con una docena de resultados de búsqueda completos es sobre todo desplazamiento, y el anotador pierde la cuenta de en qué punto de la ejecución está. Poner span_target: true en el mismo campo permite que un esquema de spans marque las palabras exactas de una afirmación alucinada dentro de un turno, un registro más fino que marcar el paso entero como erróneo.
Paso 3: el juicio a nivel de traza
Tres preguntas cubren la traza en su conjunto. El éxito de la tarea es la cifra principal, la corrección de la respuesta separa una respuesta correcta a la que se llegó mal de una respuesta incorrecta, y la eficiencia es lo que distingue a dos agentes que tienen éxito los dos:
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
        tooltip: "Fully completed correctly"
      - name: "Partial success"
        tooltip: "Completed with errors or omissions"
      - name: "Failure"
        tooltip: "Not completed"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3
"Cannot determine" se gana su sitio. Sin esa opción, un anotador que no tiene forma de comprobar la respuesta o adivina o la marca como incorrecta, y cualquiera de las dos elecciones mete ruido en la cifra que más te importa.
Paso 4: el juicio por paso
trajectory_eval muestra cada paso como una tarjeta con sus propios controles, y lleva la etiqueta de corrección, la taxonomía de errores y la gravedad en un solo esquema en lugar de en tres. Apunta steps_key al campo que contiene los pasos, que en una traza convertida es conversation, y step_text_key a la clave dentro de cada paso que debe mostrarse:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options:
      - correct
      - partially_correct
      - incorrect
      - unnecessary
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - factual_error
          - planning_error
      - name: execution
        subtypes:
          - wrong_tool
          - wrong_args
          - api_error
      - name: termination
        subtypes:
          - premature_stop
          - redundant_step
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100
Los pesos de gravedad convierten una lista de pasos marcados en un único número comparable por traza, y conviene cambiar los valores por defecto en lugar de aceptarlos. Un peso dice cuánto peor es un error crítico que uno menor para tu tarea, y en una evaluación de seguridad esa proporción es mucho más pronunciada que en una tarea de búsqueda.
Mantener unnecessary separado de incorrect es la otra decisión que conviene tomar deliberadamente. Un paso desperdiciado cuesta tokens y tiempo sin introducir un error, y juntar los dos oculta la diferencia entre un agente que da rodeos y uno que se equivoca.
Paso 5: la configuración completa
Todo lo anterior, en un solo archivo:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."
output_annotation_dir: "output/"

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: task_description

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120
    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
      - name: "Partial success"
      - name: "Failure"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3

  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options: [correct, partially_correct, incorrect, unnecessary]
    error_types:
      - name: reasoning
        subtypes: [logical_error, factual_error, planning_error]
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
      - name: termination
        subtypes: [premature_stop, redundant_step]
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

export_annotation_format: jsonl
Inicia el servidor y abre http://localhost:8000:
potato start config.yaml -p 8000Cómo es la sesión de anotación
La página muestra la tarea, la tabla de información de la traza y las tarjetas de pasos, con los controles por paso unidos a cada tarjeta y los esquemas a nivel de traza debajo de la traza. El orden en que trabajan los anotadores importa más de lo que parece. Calificar primero los pasos y después la traza mantiene el veredicto global anclado en lo que la ejecución hizo realmente, mientras que calificar primero el éxito tiende a teñir cada juicio de paso que viene después.
Hay tres hábitos que merece la pena escribir en las instrucciones para los anotadores. Expandir las observaciones colapsadas en lugar de fiarse de la línea de resumen, ya que un resultado de búsqueda mal leído es la fuente más común de una respuesta incorrecta que parece bien razonada. Comprobar la respuesta final contra la referencia antes de calificar el éxito de la tarea, cuando el conjunto de datos la tiene. Usar la línea temporal de pasos para volver a un paso cuando un paso posterior revela que el anterior ya estaba mal.
Paso 6: exportar y analizar
El exportador JSONL escribe annotations.jsonl, con un registro por instancia y anotador:
python -m potato.export --config config.yaml --format jsonl --output ./export/Cada registro lleva instance_id, user_id, labels, spans y links, y las respuestas de los esquemas están bajo labels, indexadas por el nombre del esquema:
import json
import pandas as pd

records = [json.loads(line) for line in open("export/annotations.jsonl")]

df = pd.DataFrame([
    {"trace": r["instance_id"], "annotator": r["user_id"], **r["labels"]}
    for r in records
])

print(df["task_success"].value_counts())
Para cualquier cosa por encima de unos cientos de trazas, exporta a Parquet y consulta el archivo sin moverlo. La exportación Parquet escribe annotations.parquet con instance_id, user_id y una columna por esquema de anotación, así que el nombre del esquema es una columna y no un valor:
python -m potato.export --config config.yaml --format parquet --output ./export/import duckdb
print(duckdb.sql("""
SELECT task_success, COUNT(*) AS n
FROM 'export/annotations.parquet'
GROUP BY task_success
ORDER BY n DESC
"""))Los juicios a nivel de paso son los que conviene leer primero. Contar los subtipos de error a lo largo de las trazas te dice si el agente tiene un fallo sistemático o una larga cola de fallos sin relación entre sí, y solo el primer caso merece una corrección dirigida.
Paso 7: más anotadores y una fase de cualificación
La evaluación de agentes es lo bastante subjetiva como para que una sola calificación por traza sea una medida sin barra de error. Tres anotadores por traza te dan una cifra de acuerdo, y la asignación aleatoria evita que el solapamiento se concentre en las trazas que están al principio del archivo:
num_annotators_per_item: 3
assignment_strategy: random
Una fase de cualificación detecta a los anotadores que no han entendido la taxonomía de errores antes de que pasen un día aplicándola de forma inconsistente. El bloque de entrenamiento los mantiene en trazas con respuesta conocida hasta que aprueban:
training:
  enabled: true
  data_file: "data/training_traces.jsonl"
  passing_criteria:
    min_correct: 4
  allow_retry: true
  failure_action: "repeat_training"
Otros frameworks de agentes
La visualización y los esquemas son los mismos en todos los frameworks, y solo cambia el convertidor. Las trazas de OpenAI Chat Completions y los mensajes de Anthropic con bloques tool_use tienen cada uno su propio convertidor, y los logs multiagente de CrewAI, AutoGen y LangGraph comparten uno:
python -m potato.trace_converter --input runs.json --input-format openai --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format anthropic --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format multi_agent --output data/traces.jsonl
Los agentes de programación necesitan otra visualización, porque un diff leído como cadena JSON no se puede revisar. La visualización coding_trace muestra diffs unificados con un árbol de archivos y colapsa la salida larga del terminal:

instance_display:
  fields:
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
Los agentes de navegación web necesitan las capturas de pantalla, las superposiciones de acciones y una tira de fotogramas para recorrerlas:
instance_display:
  fields:
    - key: steps
      type: web_agent_trace
      label: "Agent Browsing Trace"
      display_options:
        show_overlays: true
        show_filmstrip: true
        show_thought: true
        screenshot_max_width: 900
Anotación de agentes de navegación web cubre el formato de las superposiciones y el modo de creación que graba trazas nuevas.
Para los detalles de implementación que hay detrás de todo esto, consulta la guía de evaluación de agentes y la documentación de trazas de agentes. Si estás preparando tu primera evaluación, convierte diez trazas, ejecuta la configuración de arriba y anótalas tú mismo antes de escribir las pautas, ya que la taxonomía de errores que necesitas no suele ser la que habrías escrito de antemano.
Lectura adicional
- Documentación de anotación agéntica
- Anotación de agentes de navegación web
- Modo individual, para combinar la anotación agéntica con la evaluación colaborativa entre humanos y LLM
- Best-Worst Scaling, para clasificar salidas de agentes de forma comparativa
- Exportación Parquet, para el análisis a gran escala