將質性編碼引入 Potato:碼本、備忘錄與原生碼
瞭解 QDA 模式——即將隨 Potato 2.6 推出的質性資料分析工作區:動態碼本、原生編碼、分析備忘錄、案例,以及面向整個語料庫的全文檢索。
如果你曾經編碼過訪談轉錄稿,那你一定熟悉這套軟體的故事。那些嚴肅的質性資料分析(QDA)工具,比如 NVivo、ATLAS.ti、MAXQDA 和 Dedoose,功能強大但價格不菲。它們只能在桌面端執行,把你的項目鎖進專有檔案格式裡,還讓協作變成一場授權談判。於是不少研究者乾脆改用電子表格編碼,結果做到一半就理不清頭緒,因為電子表格根本不知道什麼叫"碼"。
Potato 出身於另一邊的陣營,最初是一款面向 NLP 和機器學習資料集的文本標註工具。在最近幾個版本里,它逐漸長出了質性工作流所需的部件:覆蓋段落的跨度(span)、共享的碼本、一致性指標。即將釋出的 2.6 版本把這些部件整合成一個模式,貼合質性研究者真實的工作方式。
本文將帶你瞭解 QDA 模式:它會啟用什麼、各部件如何協同,以及配置檔案長什麼樣。如果你想查閱參考資料,QDA 模式文件列出了完整的選項清單。
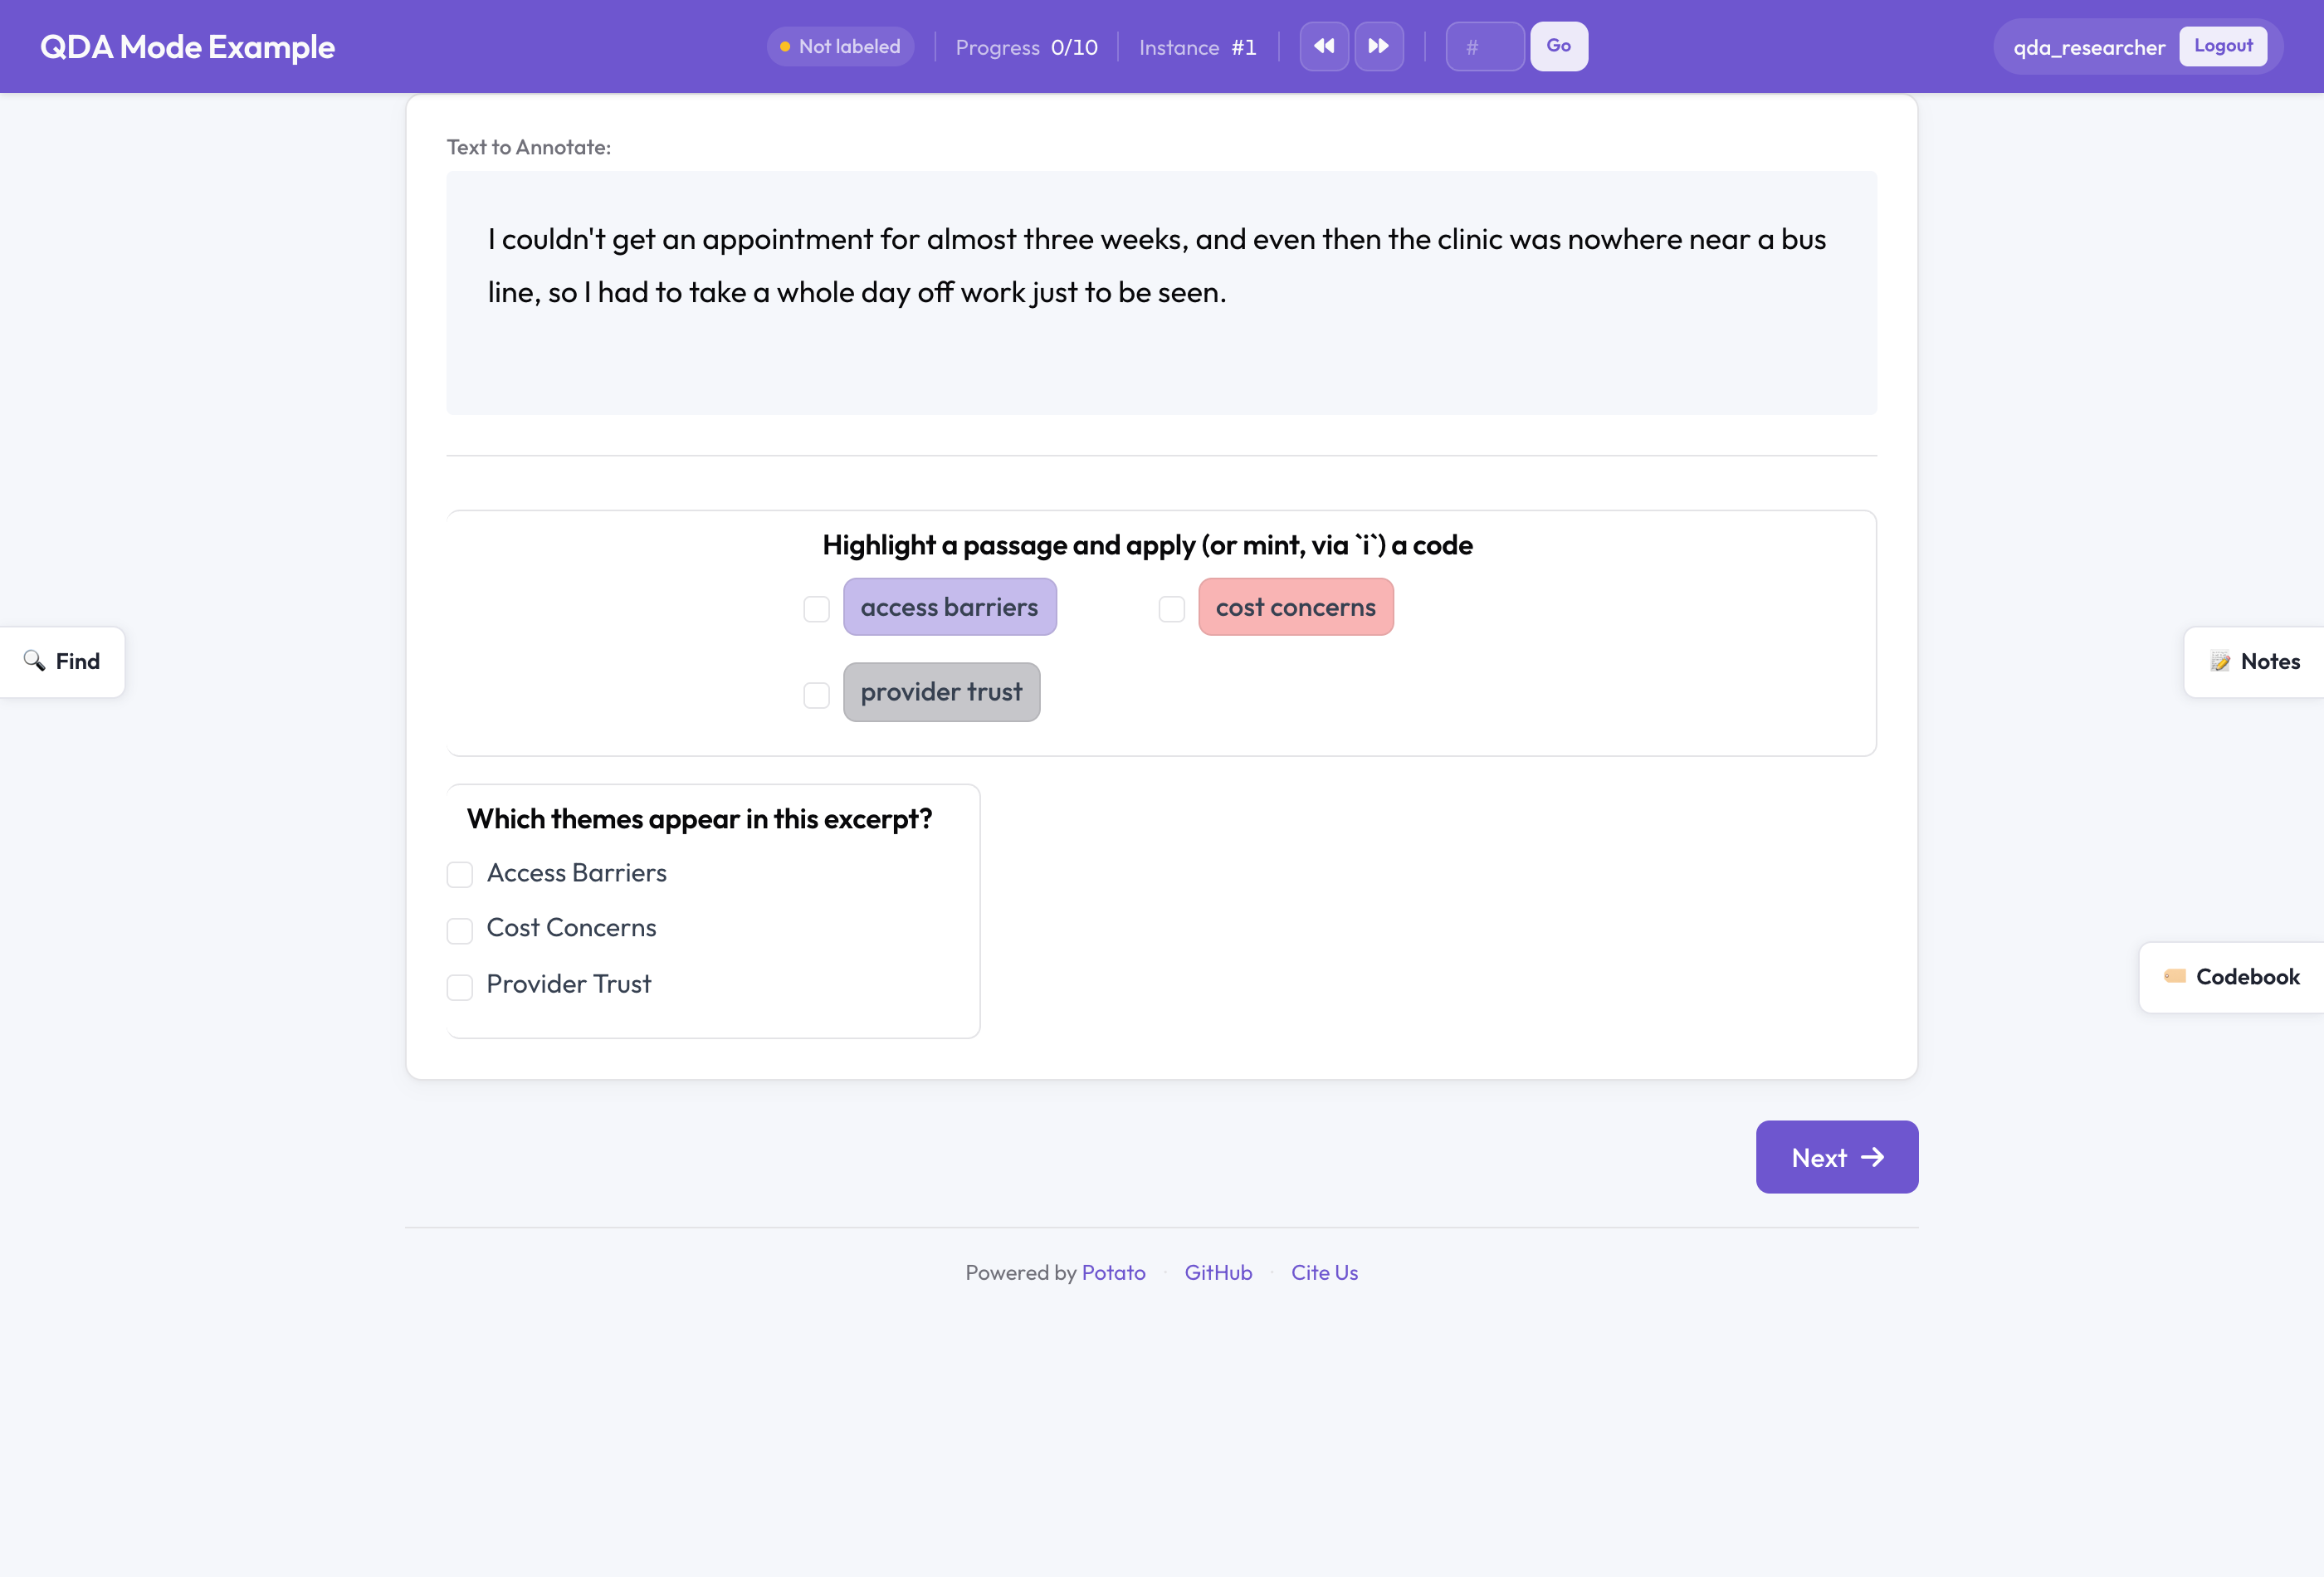 處於 QDA 模式下的 Potato
一個開關,質性的預設值
Potato 的大部分機制在差異極大的任務之間是共享的。同一套跨度方案,既能為 NER 資料集標註命名實體,也能為訪談中的段落打標。這兩項工作的區別不在於功能集,而在於姿態。一個眾包的 NER 項目想要的是固定的標籤集,以及用於測量一致性的重疊抽樣;而一位獨自編碼二十份訪談的研究者,想要的是邊讀邊發明碼,並對自己的觀察保留私人筆記。
QDA 模式就是那個假定採取第二種姿態的單一開關:
qda_mode:
  enabled: true            # compose codebook + memos + cases + search
設定 qda_mode.enabled: true 會把 Potato 的通用功能切換到它們的質性預設值。碼本變得可以邊編碼邊編輯,而不再被鎖定。備忘錄側邊欄開啟。案例開啟,並帶自動檢測。在任何你標記為以碼本為支撐的跨度方案上,原生編碼都變得可用。
| 功能 | 標準預設值 | QDA 模式下 |
|---|---|---|
| 碼本模式 | fixed | open:隨時新增、重新命名、改色、移動或刪除碼 |
| 備忘錄側邊欄 | 關閉 | 開啟 |
| 案例 | 關閉 | 開啟,帶自動檢測 |
| 標註者檢索並認領 | 關閉 | 可用(search.annotator_claim: true) |
| 原生編碼快捷鍵 | i | 在任何以碼本為支撐的跨度方案上啟用 |
這些都不是寫死的。QDA 模式只改變起點;每一項預設值都可以被覆蓋。唯一的例外是一道護欄:如果你接入了 Prolific 或 Mechanical Turk 這類眾包後端,Potato 會強制把碼本鎖定為 fixed,這樣付費標註者就無法在你不知情的情況下重塑共享方案。
各個部件
動態碼本
在紮根理論式的編碼中,碼本不是你事先寫好的東西。它隨著你的閱讀而生長。你注意到一個反覆出現的想法,給它命名,一週後又發現其中兩個碼其實是同一個,於是把它們合併。
當你為一個跨度方案打上標記時,它就成了碼本的一部分:
annotation_schemes:
- annotation_type: span    # span + codebook = qualitative coding
  name: codes
  description: Highlight a passage and apply (or mint, via `i`) a code
  codebook: true
  labels: [access barriers, cost concerns, provider trust]
這些 labels 是一組起點,而不是牢籠。在 open 碼本模式下,你可以邊工作邊新增、重新命名、改色、移動和刪除碼。extensible 模式允許編碼者新增碼,但不能刪除共享的碼;fixed 則是那個鎖定的經典模式,適用於你已經確定好方案的情況。
原生編碼
原生編碼(in-vivo coding)直接把參與者自己的話語當作碼。有人說"我就是等不到回電",於是"等不到回電"就原封不動地成了碼。
在以碼本為支撐的跨度方案上選中一段文字,按下原生編碼快捷鍵(codebook_invivo_key,預設為 i)。Potato 會直接從高亮的文本中鑄造出一個碼。當你在整個語料庫中反覆這樣做時,碎片化就成了大敵:你會得到"沒回電""等不到回電"和"始終沒人回"這三個碼,指向的卻是同一個想法。程式碼合成器會反向制衡這一點——在你輸入時浮現出近似重複的碼,讓你複用已有的碼,而不是再生出一個新的。
備忘錄
沒有筆記的編碼會丟失碼背後的推理。備忘錄是附在某個實例上、或附在某段具體文本選區上的分析性筆記。你可以把它們保密,也可以與團隊共享。"我當初為什麼這樣編碼"就活在這裡,而且它們會與引文一同匯出,讓你的審計軌跡在項目結束後依然留存。
案例
案例把若干摘錄歸併為一個分析單位:一位參與者、一份文件、一次實地訪問。摘錄歸組之後,案例層級的屬性會被提升上來,於是你就能將碼與參與者變數進行交叉列表。如果每份訪談都帶有一個 condition 欄位,管理端的交叉表就能顯示某個碼在不同條件之間的分佈。
cases:
  enabled: true
  key: participant_id
  attributes: [condition]
檢索
只有當你能跳轉到某個詞的任意一處出現時,語料庫才是可導航的。QDA 模式內建了面向整個資料集的 FTS5 全文檢索。在 annotator_claim: true 的情況下,編碼者可以把任意檢索命中項直接拉進自己的佇列——這正是一位分析者按主題而非嚴格從頭到尾通讀來推進整個語料庫的方式。
search:
  enabled: true
  annotator_claim: true
各部件如何協同
在底層,碼本、備忘錄、案例和檢索讀寫的都是同一個項目資料庫,因此在某一處鑄造的碼,會立即在其他每一處變得可檢索、可匯出。
 QDA 模式如何在共享儲存之上組合其各個部件
 The living codebook converges instead of fragmenting
一份完整的配置
下面是一項小而完整的研究。cases、search 和備忘錄程式碼塊都是可選的(QDA 模式本已開啟案例和備忘錄),所以你只在需要調整某個預設值(如案例鍵)時才寫它們。
annotation_task_name: My Qualitative Study
task_dir: .
output_annotation_dir: annotation_output/
data_files:
- data/interviews.json
item_properties:
  id_key: id
  text_key: text

qda_mode:
  enabled: true

codebook_invivo_key: i

cases:
  enabled: true
  key: participant_id
  attributes: [condition]

search:
  enabled: true
  annotator_claim: true

annotation_schemes:
- annotation_type: span
  name: codes
  description: Highlight a passage and apply (or mint, via `i`) a code
  labels: [access barriers, cost concerns, provider trust]
安裝好 2.6 後,從倉庫根目錄執行它:
python potato/flask_server.py start examples/advanced/qda-mode-example/config.yaml -p 8000把你的編碼成果匯出來
兩個匯出器能把已編碼的資料轉化為質性論文所需的交付物:
codebook為每個碼輸出一行,包含其層級、描述、顏色和使用計數。quotation_report為每個已編碼的跨度輸出一行:引文、其字元偏移量、來源實例以及編碼者。加上include_memos=true即可附上你的備忘錄。
python -m potato.export config.yaml --format quotation_report \
  --option include_memos=true -o quotations.csv
如果同一份材料由不止一人編碼,你會需要一個信度數值。Potato 會針對這些碼報告 Cohen's 和 Fleiss' kappa,這一功能隨 2.5 版本與上述匯出器一同推出。
它的定位
QDA 模式並不打算在每一個維度上都超越 NVivo 的功能。它提供的是一種不同的權衡:免費、開源、基於 Web、可協作,並且與你的機器學習標註和智慧體評估棲身於同一款工具之中。如果你的實驗室已經在用 Potato 做標註,那麼質性編碼現在只差一個配置程式碼塊,而不再是一套需要授權的獨立桌面軟體。