Formatos de transcrição
Todos os formatos de transcrição e de legenda que o Potato lê: Whisper, WhisperX, Deepgram, AssemblyAI, AWS Transcribe, SRT, WebVTT, TTML, legendas do YouTube, CTM, Praat TextGrid e ELAN EAF, além de arquivos auxiliares e do modelo de turnos normalizado.
O Potato lê 21 entradas de transcrição e de legenda e converte todas elas para o mesmo modelo de turnos antes de exibir qualquer coisa. Seja qual for a saída do seu pipeline de ASR ou da sua ferramenta de legendagem, você pode apontar o Potato para ela sem escrever um script de conversão. Esta página é a referência do que funciona, de como cada formato é reconhecido e do que cada um traz. Para o passo a passo, veja Como anotar transcrições do Whisper e Como anotar legendas do YouTube.
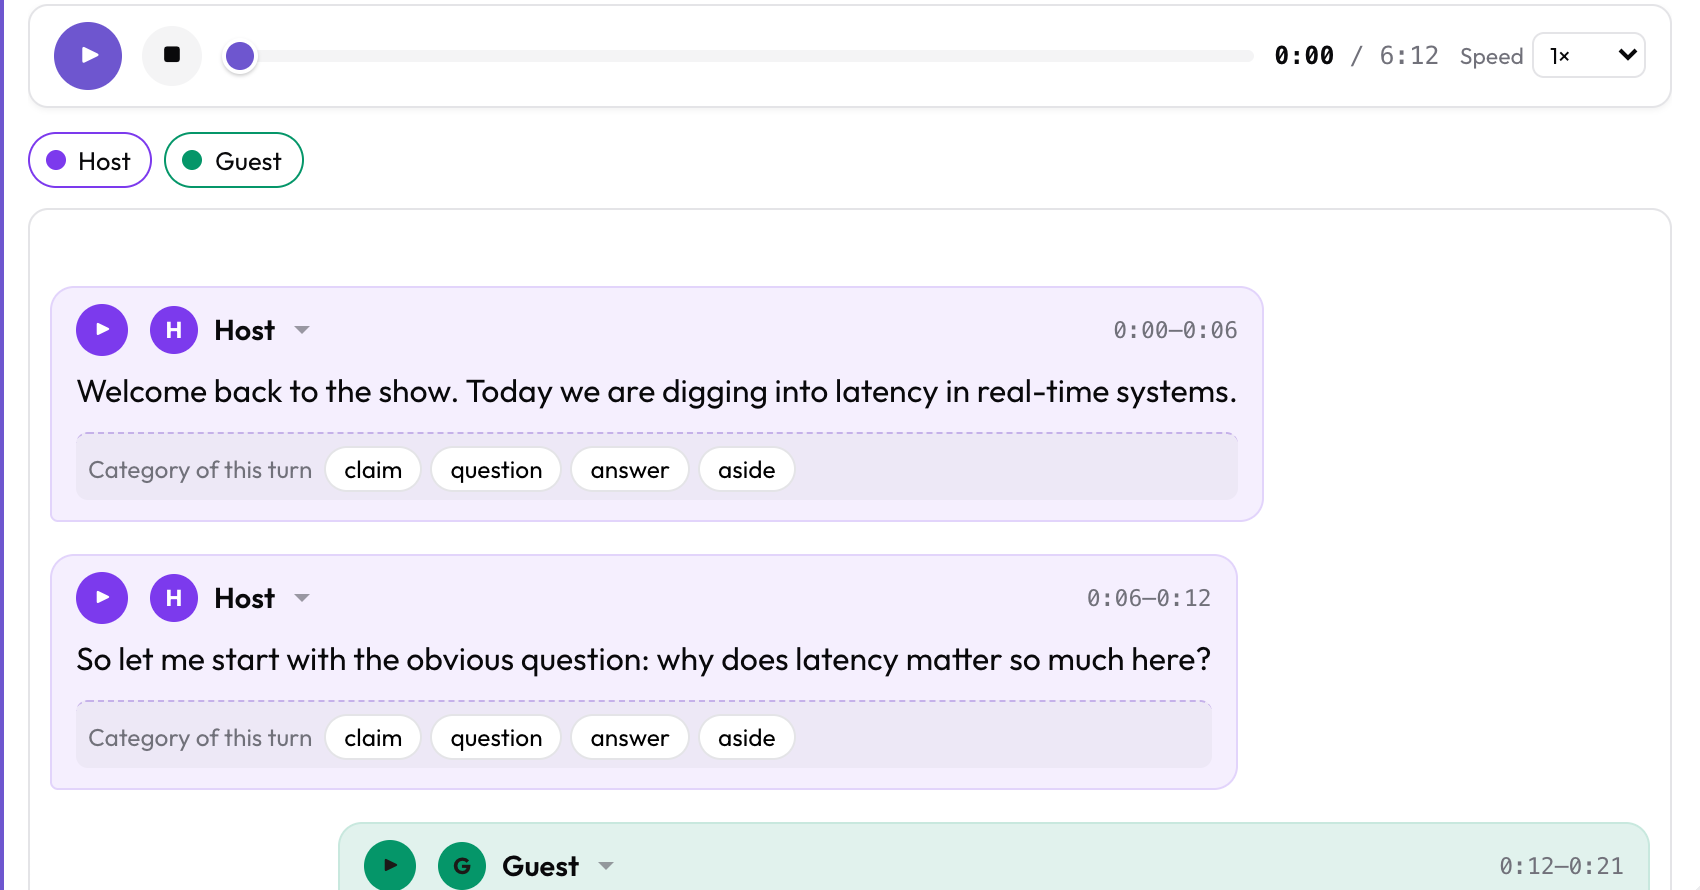 Um arquivo auxiliar SRT exibido como balões de locutor, com uma pergunta por turno associada a cada um
De onde vêm as transcrições
O reconhecimento de fala e a diarização de locutores produzem a transcrição, e os parsers desta página a leem. Rode o Whisper, o WhisperX, o pyannote ou uma API na nuvem, ou, a partir da versão 2.9, deixe o potato transcripts --transcribe --diarize fazer as duas coisas na sua própria máquina, como descrito em Transcrever localmente. A detecção de formato e o parsing não rodam nenhum modelo.
Observação: o Modo Think-Aloud de fato roda um modelo Whisper local, mas com outra finalidade. Ele grava os anotadores falando enquanto trabalham. Isso é um recurso de captura, não de ingestão de transcrições.
A detecção é pelo conteúdo, não pela extensão do arquivo
O Potato examina o que há dentro do arquivo em vez de confiar no nome dele. Um arquivo WebVTT chamado captions.txt continua sendo lido como WebVTT. Na prática, isso significa que a mesma transcrição funciona tanto embutida no seu arquivo de dados quanto lida de um arquivo auxiliar no disco, sem nenhuma mudança de configuração.
Formatos suportados
Saída de ASR
| Formato | Detectado por | Locutores | Tempos por palavra |
|---|---|---|---|
| Whisper JSON | Array segments | Não | Sim, com --word_timestamps |
| WhisperX / JSON diarizado | segments com speaker | Sim | Sim |
| whisper.cpp JSON | Array transcription | Não | Não |
| Whisper TSV | Cabeçalho start/end/text | Não | Não |
| AWS Transcribe | results.items ou results.audio_segments | Sim | Sim |
| Deepgram | results.channels ou results.utterances | Sim, com diarize=true | Sim |
| AssemblyAI | text mais words/utterances | Sim, com speaker_labels | Sim |
| Rev.ai | Array monologues | Sim | Sim |
| SPoRC | Linhas turn_text/turnText | Sim, inferidos | Não |
Legendas e closed captions
| Formato | Detectado por | Locutores |
|---|---|---|
SubRip (.srt) | Setas dos blocos de legenda, separador ,mmm | A partir de um prefixo Name: |
WebVTT (.vtt) | Cabeçalho WEBVTT | A partir de tags <v Name> ou de um prefixo Name: |
SubStation Alpha (.ass, .ssa) | [Script Info] / Dialogue: | A partir do campo Name |
| TTML / DFXP | Elemento raiz <tt> | A partir de um atributo speaker/agent |
| YouTube srv1/srv2/srv3 | XML <transcript><text> | A partir de um prefixo Name: |
| YouTube json3 | Array events | Nenhum; legendas automáticas não têm locutores |
O SubRip e o WebVTT cobrem a maior parte do que você vai encontrar. O TTML aparece em acervos de radiodifusão e em arquivos exportados de ferramentas profissionais de legendagem.
Alinhamento e anotação linguística
| Formato | Detectado por | Locutores |
|---|---|---|
| NIST CTM | Colunas separadas por espaço, início/duração numéricos | A partir do campo de canal |
| Praat TextGrid | File type = "ooTextFile" | Um tier por locutor |
| ELAN EAF | Raiz ANNOTATION_DOCUMENT | A partir de PARTICIPANT, senão do id do tier |
As serializações longa e curta do TextGrid são lidas. Para arquivos do ELAN, o Potato resolve ALIGNABLE_ANNOTATION e REF_ANNOTATION em relação à tabela TIME_ORDER e lê a referência de mídia no cabeçalho.
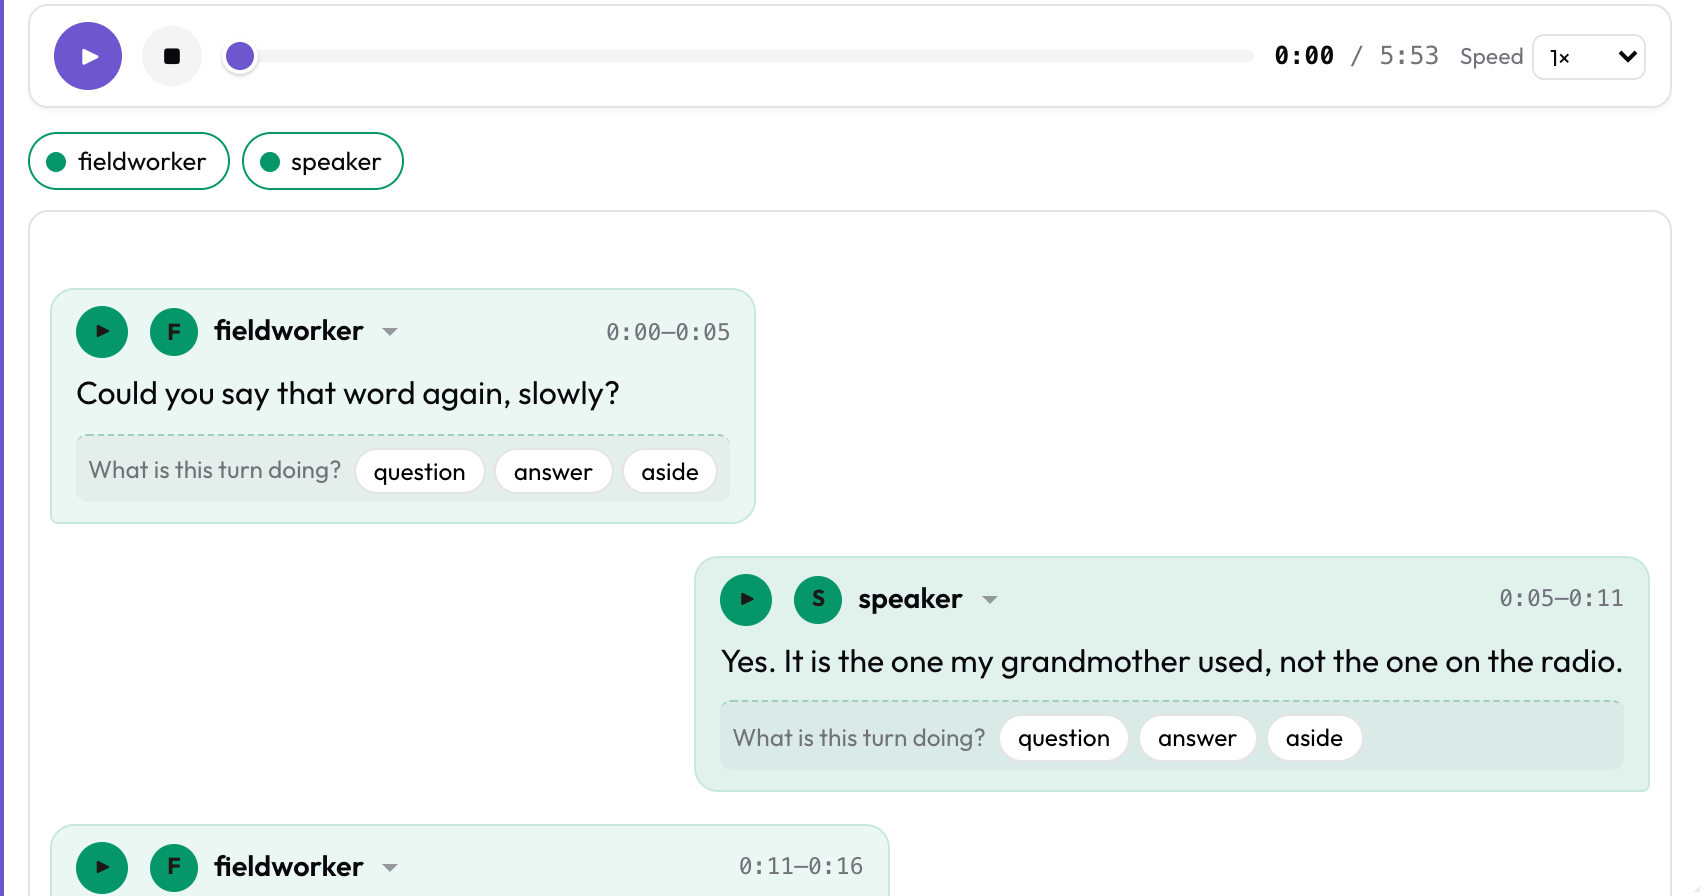 Cada tier do TextGrid vira um locutor, e os intervalos vazios entre eles são ignorados
Todo o resto
Três formatos genéricos completam os 21:
- Uma lista simples de dicionários
{speaker, start, end, text}. - Um objeto
{"audio": ..., "turns": [...]}. - Um parágrafo simples sem nenhum tempo, que é exibido como um único balão.
Não suportados
Não existe parser para estes. Converta-os antes.
- SAMI (
.smi), MicroDVD (.sub), SubViewer (.sbv) - Transcriber (
.trs), EXMARaLDA, CHAT/CHILDES (.cha) - Saída nativa do Montreal Forced Aligner e do Gentle. Exporte CTM ou TextGrid dessas ferramentas.
- Azure Speech, Google Speech-to-Text e
verbose_jsonda API do Whisper dentro de invólucros incomuns - Arquivos de diarização RTTM isolados
A confiança por palavra é lida e mantida no modelo de dados sempre que a fonte a fornece, mas no momento não há interface para visualizá-la.
O modelo de turnos normalizado
Todos os formatos acima viram isto:
{
  "audio": "media/interview_01.mp3",
  "turns": [
    {
      "turn_id": "t0",
      "speaker": "host",
      "start": 0.0,
      "end": 6.5,
      "text": "Welcome back.",
      "words": [{"word": "Welcome", "start": 0.0, "end": 0.4, "confidence": 0.99}],
      "confidence": 0.97
    }
  ]
}
words e confidence só aparecem quando a fonte os trazia. speaker é null em turnos não diarizados, que são exibidos como Unassigned com um seletor para que os anotadores os preencham.
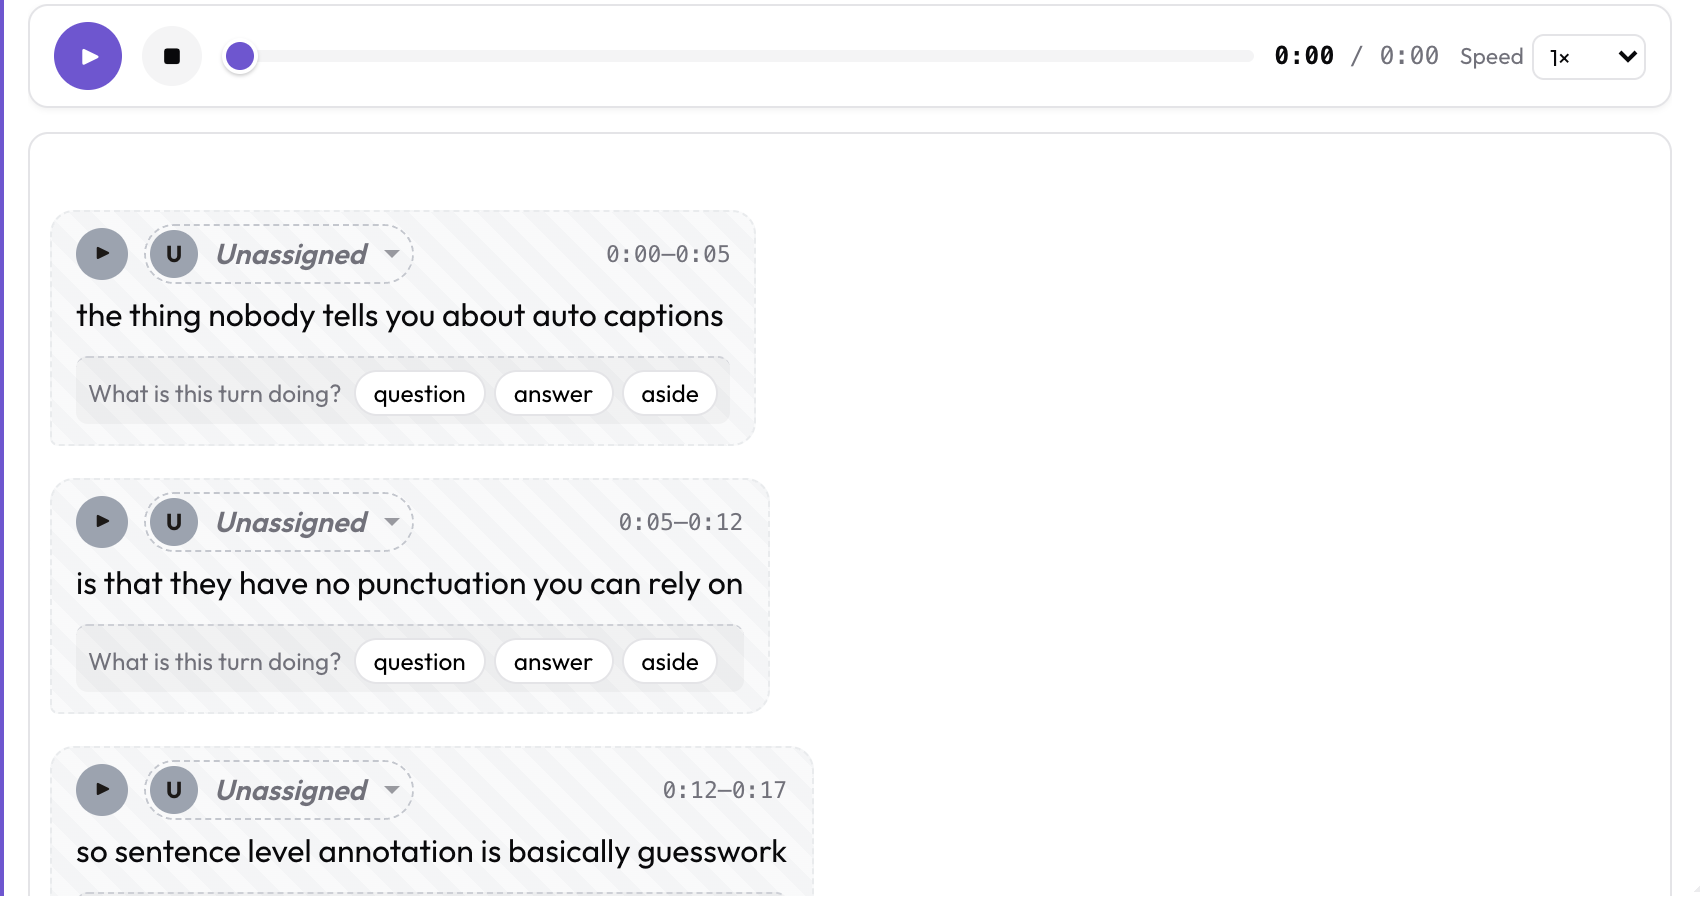 As legendas automáticas do YouTube chegam sem locutores, então cada turno fica como Unassigned até que um anotador escolha um
turn_id é a chave de persistência das anotações por turno e das atribuições de locutor. Ele vem de uma string turn_id ou step_id explícita na fonte, quando existe, ou então de t{index}. O mesmo arquivo sempre produz os mesmos ids, então as anotações sobrevivem a um recarregamento.
Aviso: as unidades de tempo variam entre ferramentas. O Whisper e o Deepgram usam segundos em ponto flutuante; o AssemblyAI, os offsets do whisper.cpp e a saída TSV do Whisper usam milissegundos inteiros. O Potato converte na entrada, para que tudo dali em diante esteja em segundos. Se o seu próprio pré-processamento misturar os dois, os tempos saem 1000× errados.
Arquivos auxiliares
Um valor de campo que seja um caminho curto, de uma única linha, terminado em uma extensão de transcrição conhecida é lido do disco em vez de ser tratado como texto. Assim, o layout que a sua ferramenta de ASR já produziu, com os arquivos de mídia ao lado dos respectivos .srt ou .json, funciona sem nenhuma etapa de pré-processamento:
{
  "id": "int_001",
  "conversation": {
    "audio": "media/int_001.mp3",
    "transcript": "media/int_001.srt"
  }
}
Os caminhos são resolvidos em relação a task_dir e passam pela mesma validação de segurança de caminhos que qualquer outro caminho configurado, de modo que um arquivo de dados não consegue ler fora do projeto.
Extensões reconhecidas: .srt .vtt .webvtt .json .json3 .srv1 .srv2 .srv3 .ttml .dfxp .xml .ass .ssa .tsv .ctm .TextGrid .eaf .txt
Se os seus dados de fato contêm transcrições embutidas de uma linha que por acaso parecem nomes de arquivo, desligue a heurística:
display_options:
  transcript_is_path: auto   # auto (default) | true | false
Configuração
Exibição: audio_dialogue
A exibição de diálogo em áudio mostra os turnos como balões de locutor sincronizados com o áudio, com um botão de reprodução em cada turno.
instance_display:
  fields:
    - key: conversation
      type: audio_dialogue
      label: "Transcript"
      span_target: true
      display_options:
        audio_key: audio
        turns_key: turns
        speaker_key: speaker
        text_key: text
        transcript_is_path: auto
        show_timestamps: true
        allow_speaker_assignment: auto
scroll_height: 460px| Opção | Padrão | O que faz |
|---|---|---|
audio_key | audio | Subchave do valor do campo que contém a URL ou o caminho do áudio. |
turns_key | turns | Subchave que contém a lista de turnos. Também aceita segments. |
speaker_key / text_key | speaker / text | Chaves por turno. |
speakers | [] | Lista de {id, name, color, side}. Locutores fora da lista recebem uma cor determinística e um lado alternado. |
allow_speaker_assignment | auto | auto ativa a atribuição por clique quando há turnos não diarizados ou uma lista de locutores para corrigir. true força a ativação, false desativa. |
transcript_is_path | auto | Se o valor do campo deve ser lido como caminho de um arquivo auxiliar. |
show_timestamps | true | Mostra mm:ss–mm:ss em cada turno. |
scroll_height | 480px | Altura do painel rolável da transcrição. |
playback_rates | [1, 1.25, 1.5, 2] | Opções do seletor de velocidade. |
Esquemas
A partir da versão 2.7.1, speech_transcript, voice_interaction e tiered_annotation leem a transcrição diretamente do registro da instância e aceitam todos os formatos desta página. Antes disso, só a exibição audio_dialogue fazia isso.
annotation_schemes:
  - annotation_type: speech_transcript
    name: transcript_review
    description: "Mark transcription errors"
    segments_key: segments       # record field holding the transcript

  - annotation_type: voice_interaction
    name: barge_in
    description: "Mark overlaps and barge-in"
    turns_key: turns
A anotação em tiers pode pré-preencher um tier a partir da transcrição, de modo que os anotadores corrigem um alinhamento existente em vez de segmentar a fala à mão do zero:
  - annotation_type: tiered_annotation
    name: tiers
    source_field: audio_url
    media_type: audio
    tiers:
      - name: utterance
        labels:
          - name: speech
            color: "#7c3aed"
As anotações pré-preenchidas só são gravadas quando o anotador faz uma edição real, então nada é atribuído a alguém que apenas abriu a instância.
Transcrever localmente
Desde o Potato 2.9, o potato transcripts pode produzir a própria transcrição em vez de ler uma. Instale o extra e aponte o comando para uma pasta de gravações:
pip install 'potato-annotation[transcribe]'
potato transcripts ./interviews --transcribe --diarize --num-speakers 2 -o data/interviews.json
A transcrição roda o faster-whisper e a diarização roda o sherpa-onnx, ambos na sua própria máquina, sem PyTorch e sem token do Hugging Face. Os turnos diarizados voltam como SPEAKER_00, SPEAKER_01, os mesmos rótulos que o WhisperX produz. Passe --num-speakers quando você souber quantos são.
Os pesos dos modelos são baixados no primeiro uso, então a primeira execução precisa de rede. Para rodar sem conexão (air-gapped), prepare-os uma vez a partir de uma máquina conectada: um diretório local de modelo CTranslate2 para o Whisper e POTATO_MODEL_CACHE para a diarização.
A detecção de atividade de voz roda primeiro, para que o Whisper não invente texto sobre o silêncio. Ela também pode descartar fala baixa ou sussurrada sem nenhum aviso. Se um áudio que você sabe que contém fala voltar curto, rode de novo com --asr-no-vad.
Montar um arquivo de dados com potato transcripts
Aponte o conversor para uma pasta de saída de ASR e ele grava um arquivo de dados pronto para anotação:
# Pair transcripts to media by basename
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.json

# Media served from elsewhere
potato transcripts './captions/*.vtt' \
  --media-url-prefix https://cdn.example.org/audio -o data/talks.json

# What did it detect? Writes nothing.
potato transcripts ./whisper_out --dry-run
--dry-run relata o que encontrou sem gravar nada, o que é a forma mais rápida de perceber uma pasta com o arquivo de saída errado do Whisper:
Scanned 3 file(s):
  talk_01.srt          SRT                  2 turns      5.0s  2 speaker(s): Alice, Bob
  talk_02.vtt          WebVTT               1 turns      3.0s  undiarized
  talk_03.json         whisper.cpp JSON     1 turns      2.4s  undiarized

3 item(s), 4 turn(s).
1 item(s) have no media. Pass --media-dir or --media-url-prefix to enable playback.
| Opção | Finalidade |
|---|---|
-o, --output | Onde gravar. Obrigatória, exceto com --dry-run. |
--format | json (padrão) ou jsonl. |
--media-dir | Diretório de mídia a parear pelo nome base. |
--media-url-prefix | URL base da mídia, em vez de arquivos locais. |
--field | Campo do item sob o qual a transcrição fica. Padrão conversation. |
--id-prefix | String adicionada no início de cada id gerado. |
--speaker-key | Chave da fonte que contém o rótulo do locutor. |
-r, --recursive | Percorre os subdiretórios. |
--dry-run | Relata o formato detectado e o número de turnos de cada arquivo. |
--emit-config | Também imprime um trecho de config.yaml correspondente. |
-q, --quiet | Suprime o relatório por arquivo. |
Os ids dos itens vêm do nome do arquivo, sem uma extensão de mídia no final, então o interview_01.mp3.json do Whisper vira interview_01 e não interview_01.mp3.
Exportar de volta
As anotações em tiers são exportadas para ELAN EAF e Praat TextGrid, de modo que uma transcrição pode fazer o caminho de ida e volta: você a importa, anota no Potato, exporta, refina no ELAN ou no Praat e lê o resultado de novo.
python -m potato.export --config config.yaml --format eaf --output ./out/
python -m potato.export --config config.yaml --format textgrid --output ./out/
Os dois exportadores partem da saída de tiered_annotation. Os outros esquemas são exportados pelos formatos padrão.
Solução de problemas
| Sintoma | O que aconteceu |
|---|---|
| Tudo aparece em um único balão grande | O formato não foi reconhecido e caiu no fallback de parágrafo simples. Rode potato transcripts <file> --dry-run; se ele relatar plain text, os tempos nunca foram lidos. Em geral o arquivo é um .txt do Whisper, que não tem tempos, em vez do .json ou do .srt. |
| Sem locutores, tudo aparece como Unassigned | A fonte não tem rótulos de locutor. O Whisper sozinho não faz diarização, e as legendas automáticas do YouTube também não. Rode a diarização antes ou deixe os anotadores atribuírem os locutores na interface. |
| Os tempos estão 1000× errados | Segundos e milissegundos foram misturados antes de chegar ao Potato. Os offsets do whisper.cpp, o AssemblyAI e o TSV do Whisper estão todos em milissegundos. |
| O caminho da transcrição aparece como o texto da transcrição | O arquivo auxiliar não pôde ser lido, então o caminho foi exibido como conteúdo. Verifique se ele é resolvido dentro de task_dir. Os logs do servidor registram o motivo exato. |
| Uma transcrição embutida de uma linha é lida como nome de arquivo | Defina transcript_is_path: false no campo de exibição. |
Projeto de exemplo
examples/audio/transcript-formats/, no repositório do Potato, exibe seis formatos lado a lado, cada um carregado de um arquivo auxiliar: SubRip, WebVTT, Whisper JSON, YouTube json3, Praat TextGrid e Deepgram. Os seis produzem os mesmos balões de locutor.
python potato/flask_server.py start examples/audio/transcript-formats/config.yaml -p 8000A mesma tarefa está disponível como um design do showcase para download: Ingestão de formatos de transcrição.
Para detalhes de implementação, veja a documentação do código-fonte.
Leitura adicional
- Como anotar transcrições do Whisper, o passo a passo completo
- Como anotar legendas do YouTube, para legendas e as ressalvas sobre as janelas de legenda
- Anotação de Diálogo, a exibição em balões de locutor
- Anotação de Áudio, segmentação da forma de onda do zero
- Como projetar formatos de dados para anotação