Como anotar transcrições do Whisper
Como transformar a saída do Whisper ou do WhisperX em um projeto de anotação funcionando: qual arquivo de saída guardar, quando você precisa de diarização, como atribuir locutores e como exportar com os tempos preservados.
O Whisper entrega segmentos com tempos, e uma ferramenta de anotação deve lê-los como estão. Guarde a saída .json em vez do .txt, rode o WhisperX se precisar de rótulos de locutor e depois aponte o Potato para a pasta. Sem script de conversão, sem etapa de reformatação. Para os detalhes formato por formato, veja Formatos de transcrição.
O Whisper é o modelo de reconhecimento de fala de código aberto da OpenAI e virou o primeiro passo padrão para quem tem uma pilha de áudio para processar. O que ele produz é um conjunto de segmentos com tempos, que é a maior parte do que um projeto de anotação precisa. A lacuna é tudo o que fica entre "tenho transcrições" e "os anotadores estão rotulando".
Observação: este guia parte de transcrições que você já tem, produzidas por um pipeline de ASR que você mesmo rodou. A partir da versão 2.9, o Potato pode em vez disso rodar o Whisper e a diarização de locutores na sua própria máquina com potato transcripts --transcribe --diarize, como descrito em Transcrever localmente. De um jeito ou de outro, a transcrição termina antes de a anotação começar, então as escolhas anteriores abaixo decidem o que os seus anotadores podem rotular.
Qual arquivo de saída do Whisper devo guardar?
O Whisper grava vários arquivos, e a escolha importa mais do que parece:
whisper interview_01.mp3 --model medium --output_format json --word_timestamps True| Arquivo | Contém | Usar? |
|---|---|---|
.json | Segmentos com tempos de início e fim e, opcionalmente, tempos por palavra | Sim, este |
.srt / .vtt | Segmentos com tempos, sem metadados | Sim, funciona bem |
.tsv | Início e fim em milissegundos, mais o texto | Sim |
.txt | Só o texto, sem tempos | Não, não há nada para sincronizar com o áudio |
Se você guardou só o .txt, o alinhamento se perdeu e não dá para recuperá-lo sem rodar o modelo de novo. Esse é o motivo mais comum para uma transcrição chegar ao Potato como um único bloco de texto indiferenciado.
O Whisper rotula os locutores?
Não. O Whisper puro transcreve, mas não diz quem está falando. Todos os turnos chegam sem atribuição, o que não atrapalha a anotação de conteúdo e complica qualquer coisa relacionada aos locutores.
A diarização de locutores é uma etapa separada. Há três formas de lidar com ela:
Rode o WhisperX, que envolve o Whisper com a diarização do pyannote:
whisperx interview_01.mp3 --model medium --diarize --output_format jsonA saída dele traz um campo speaker por segmento (SPEAKER_00, SPEAKER_01 e assim por diante), e o Potato o lê diretamente.
Use uma API na nuvem com a diarização ativada. O Deepgram com diarize=true, o AssemblyAI com speaker_labels, o AWS Transcribe e o Rev.ai produzem rótulos de locutor, e o Potato lê os quatro nativamente.
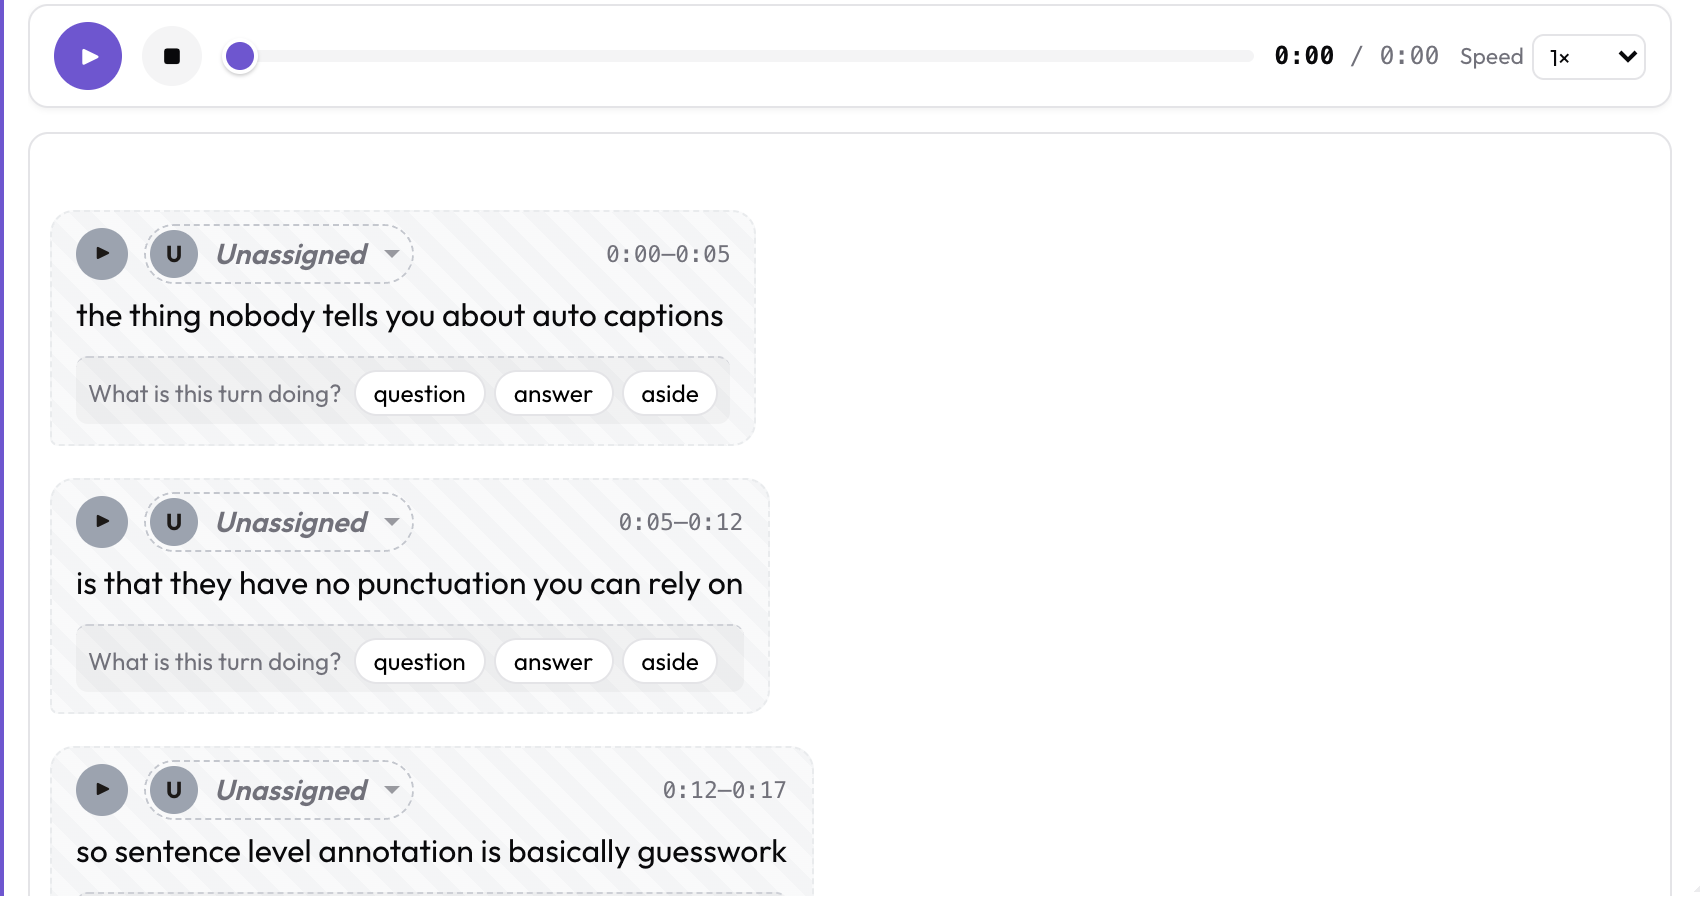 Os turnos não diarizados aparecem como Unassigned, com um seletor de locutor
Deixe os anotadores fazerem isso. Quando os turnos chegam sem diarização, cada balão aparece como Unassigned com um seletor. Em áudio ruim, com fala sobreposta ou em uma sala com ruído de fundo, uma pessoa ouvindo costuma ser mais precisa do que a diarização automática. Para um corpus pequeno, essa é uma troca razoável, e não um plano B.
Como monto o arquivo de dados?
Aponte o conversor para a pasta de saída do Whisper:
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.jsonAs transcrições são pareadas com a mídia pelo nome base, então interview_01.json encontra interview_01.mp3. Os ids dos itens vêm do nome do arquivo, e a extensão dupla interview_01.mp3.json do Whisper é tratada sem produzir o id interview_01.mp3.
Confira o que ele entendeu antes de seguir adiante:
potato transcripts ./whisper_out --dry-runScanned 3 file(s):
interview_01.json Whisper JSON 42 turns 891.4s undiarized
interview_02.json WhisperX JSON 51 turns 1120.8s 2 speaker(s): SPEAKER_00, SPEAKER_01
interview_03.json Whisper JSON 38 turns 754.2s undiarized
3 item(s), 131 turn(s).
Um arquivo que aparece como plain text ou com zero turnos é o seu arquivo problemático. Quase sempre é um .txt que se misturou à saída .json.
Posso pular a etapa de conversão?
Sim. Um arquivo de dados pode apontar diretamente para os arquivos de transcrição no disco:
{"id": "int_001", "conversation": {"audio": "media/int_001.mp3",
                                   "transcript": "media/int_001.srt"}}
O Potato lê o arquivo, detecta o formato pelo conteúdo e o normaliza quando a instância é exibida. As suas transcrições continuam sendo arquivos que você pode comparar com diff e exportar de novo, em vez de ficarem embutidas em um blob de dados.
Como fica a configuração?
O arquivo de dados gerado tem este formato:
{
  "id": "interview_01",
  "conversation": {
    "audio": "audio/interview_01.mp3",
    "turns": [
      {"turn_id": "t0", "speaker": "SPEAKER_00", "start": 0.0, "end": 6.5,
       "text": "Welcome back."}
    ]
  }
}
E a configuração correspondente, que o potato transcripts --emit-config imprime para você:
annotation_task_name: "Interview Annotation"
task_dir: .
data_files:
- data/interviews.json
item_properties:
id_key: id
text_key: conversation
instance_display:
fields:
- key: conversation
type: audio_dialogue
label: "Transcript"
span_target: true
display_options:
show_timestamps: true
allow_speaker_assignment: auto
annotation_schemes:
- annotation_type: span
name: topics
description: "Highlight topic mentions"
labels:
- name: policy
- name: personal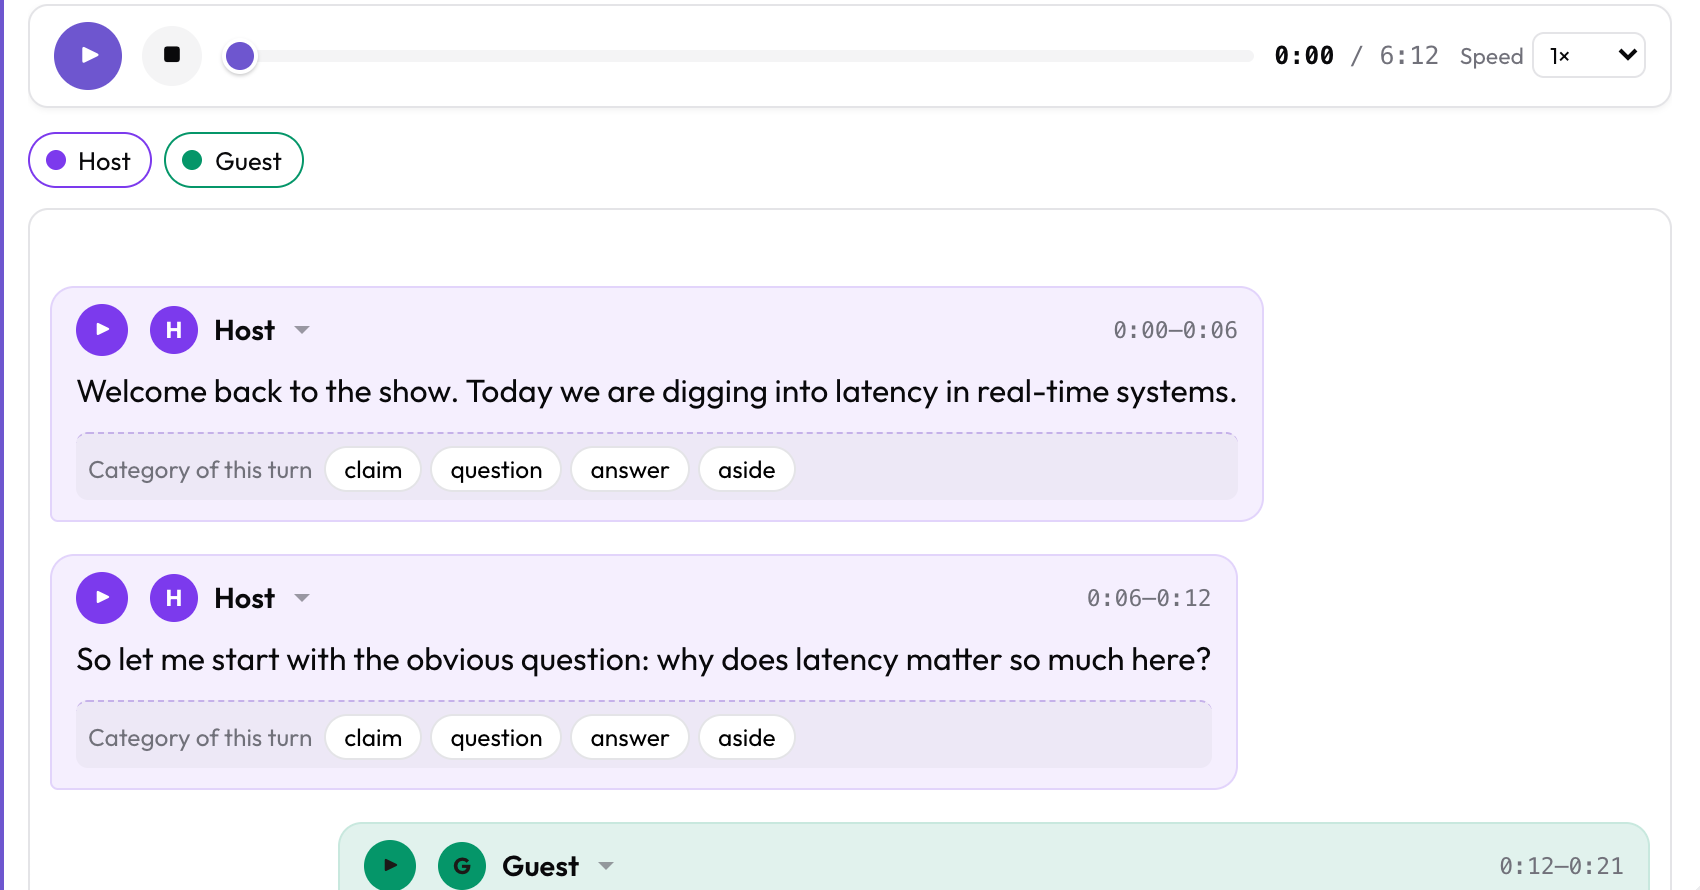 A exibição audio_dialogue, com uma pergunta por turno associada a cada turno
A exibição audio_dialogue mostra os turnos como balões de locutor sincronizados com o áudio, com um botão de reprodução em cada turno que toca só aquele turno. span_target: true permite que os spans atravessem as fronteiras entre turnos, e os offsets continuam estáveis quando um locutor é reatribuído.
Se você prefere que os anotadores revisem a própria transcrição em vez de rotular o conteúdo dela, o speech_transcript oferece cartões de segmento com tags de erro e uma caixa de correção. Para trabalhos sobre sobreposição e interrupção, o voice_interaction oferece uma linha do tempo com duas trilhas. Os dois leem os mesmos arquivos.
Como os anotadores atribuem os locutores?
Defina uma lista de locutores para que eles recebam nomes, cores e lados estáveis:
display_options:
  allow_speaker_assignment: auto
  speakers:
    - id: interviewer
      name: "Interviewer"
      color: "#7c3aed"
      side: left
    - id: participant
      name: "Participant"
      color: "#059669"
      side: right
auto ativa o seletor quando há turnos não diarizados para rotular. Defina true para permitir a reatribuição mesmo quando a fonte já rotulou os locutores, que é o que você quer se estiver corrigindo erros de diarização em vez de preencher lacunas.
As atribuições são salvas junto com as anotações, vinculadas a um id de turno estável, então sobrevivem a um recarregamento.
Como exporto as anotações?
A exportação para JSON, JSONL e CSV funciona normalmente. Quando o alinhamento temporal precisa ser preservado, exporte as anotações em tiers para ELAN EAF ou Praat TextGrid:
python -m potato.export --config config.yaml --format eaf --output ./out/
python -m potato.export --config config.yaml --format textgrid --output ./out/
Os dois fazem o caminho de ida e volta. O Potato também lê EAF e TextGrid como entrada, então você pode anotar no Potato, refinar no ELAN ou no Praat e ler o resultado de novo.
Leitura adicional
- Formatos de transcrição, todos os formatos suportados e como cada um é detectado
- Como anotar legendas do YouTube, a versão deste fluxo para arquivos de legenda
- Anotação de Áudio, para trabalho na forma de onda que não parte de uma transcrição
- Ingestão de formatos de transcrição, um design do showcase pronto para rodar, com seis formatos lado a lado
- Diarização de locutores, um design do showcase pronto para rodar
- Concordância entre anotadores, para medir a concordância em rótulos por turno