Span एनोटेशन
Potato में named entity recognition के लिए text span हाइलाइट और लेबल करें, प्रति-लेबल रंगों, कीबोर्ड शॉर्टकट, tooltip और discontinuous span के साथ।
Span annotation एनोटेटर्स को टेक्स्ट के हिस्से चुनने और उन्हें लेबल करने देता है, और Potato में named entity recognition (NER), part-of-speech tagging और text highlighting कार्य इसी से बनाए जाते हैं। लेबल या तो एक साधारण string के रूप में लिखा जाता है या एक object के रूप में, जिसमें उसका अपना color, key_value और tooltip होता है। Potato इन तीनों को हर लेबल की property के रूप में पढ़ता है, इसलिए span स्कीम पर स्कीम-स्तरीय colors, key_values या tooltips map का कोई असर नहीं होता।
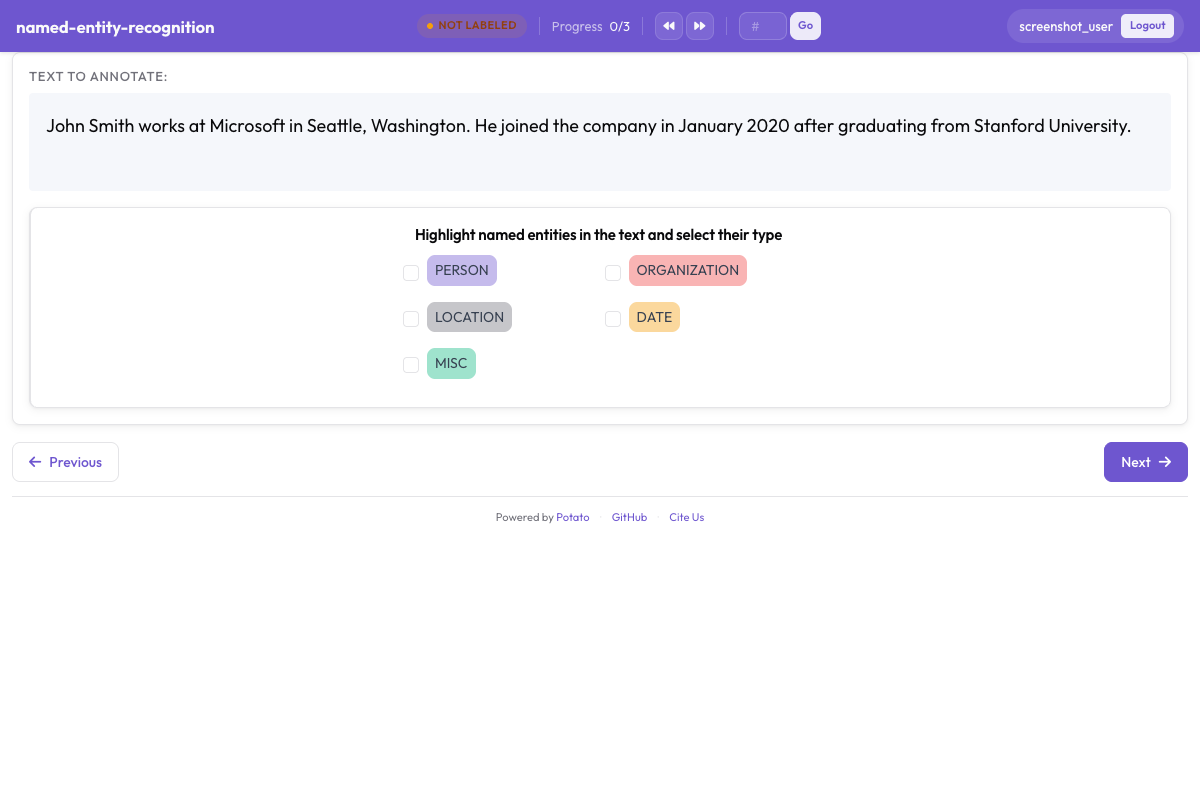 Potato में रंग-कोडित entity लेबल के साथ span एनोटेशन
बुनियादी कॉन्फ़िगरेशन
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
description हर स्कीम पर आवश्यक है और लेबल बटनों के ऊपर उस निर्देश के रूप में दिखता है जिसे एनोटेटर पढ़ता है, इसलिए इसमें स्कीम का नाम दोहराने के बजाय लेबलिंग का निर्णय लिखा होना चाहिए। साधारण string के रूप में लिखे गए लेबल Potato के palette से रंग उसी क्रम में लेते हैं जिसमें वे सूचीबद्ध हैं।
कॉन्फ़िगरेशन विकल्प
Entity लेबल
Span कार्य में लेबल सेट ही मुख्य डिज़ाइन निर्णय है, क्योंकि recall, agreement और बाद का हर माप इसी के सापेक्ष परिभाषित होता है। इसे इतना छोटा रखें कि एनोटेटर हर span पर दिशानिर्देश देखे बिना इसे याद रख सकें, जिसका व्यवहार में अर्थ है अधिकांश NER कार्य के लिए चार से आठ प्रकार। ऊपर वाली स्कीम में लेबल जोड़ें:
labels:
  - PERSON
  - ORGANIZATION
  - LOCATION
  - DATE
  - EVENT
रंग
Potato हर लेबल को सूची के क्रम में palette का एक रंग देता है, इसलिए रंग लिखना तभी सार्थक है जब कोई विशेष जोड़ी मायने रखती हो, जैसे दो प्रकार जो अक्सर एक ही वाक्य में आते हैं और जिन्हें एक नज़र में आपस में भ्रमित नहीं होना चाहिए। रंग लेबल का हिस्सा होता है:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - name: PERSON
        color: "#3b82f6"
      - name: ORGANIZATION
        color: "#10b981"
      - name: LOCATION
        color: "#f59e0b"
      - DATE
मान hex (#3b82f6) या rgb(255, 0, 0) होते हैं। साधारण string के रूप में छोड़ा गया लेबल, जैसे ऊपर DATE, palette का अगला रंग लेता है, इसलिए कोई स्कीम केवल उन्हीं लेबलों के रंग लिख सकती है जिन्हें उनकी ज़रूरत है और बाकी को वैसा ही छोड़ सकती है।
कई स्कीमों के रंग एक ही जगह, ui.label_colors के अंतर्गत, भी सेट किए जा सकते हैं, पहले स्कीम के नाम और फिर लेबल के अनुसार:
ui:
  label_colors:
    entities:
      PERSON: "#3b82f6"
      ORGANIZATION: "#10b981"
स्कीम पर ही लिखा गया colors: map ऐसी key नहीं है जिसे Potato पढ़ता हो। ऐसे map वाली स्कीम palette के रंगों के साथ रेंडर होती है, मानो वह block मौजूद ही न हो।
कीबोर्ड शॉर्टकट
दो से अधिक लेबल वाले किसी भी span कार्य पर शॉर्टकट सक्षम करना सार्थक है, क्योंकि जो एनोटेटर हर span के लिए माउस को बटन तक ले जाता है वह उस एनोटेटर की गति के एक अंश पर काम करता है जो दोनों हाथ टेक्स्ट पर रखता है। sequential_key_binding: true सेट करने से लेबलों को उसी क्रम में key मिलती हैं जिसमें वे सूचीबद्ध हैं:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - DATE
  sequential_key_binding: true
जब पेज पर किसी कार्य की कई स्कीम हों, तो Potato हर स्कीम को एक अलग pool से key देता है, पहले number row, फिर ऊपर की letter row, फिर home row, ताकि अलग-अलग स्कीमों के शॉर्टकट कभी आपस में न टकराएँ।
किसी लेबल को सूची में उसकी स्थिति के बजाय किसी विशेष key से बाँधने के लिए, लेबल को key_value दें। Allocator कुछ भी अपने आप असाइन करने से पहले स्पष्ट key_value का पालन करता है, और mnemonic key लेबल सूची के बाद में क्रम बदलने पर भी बनी रहती हैं, जबकि स्थिति-आधारित key नहीं बनी रहतीं:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      key_value: "p"
    - name: ORGANIZATION
      key_value: "o"
    - LOCATION
  sequential_key_binding: true
स्कीम-स्तरीय key_values: map पढ़ा नहीं जाता, और न ही sequential_key_binding के मान के रूप में लिखा गया mapping, जिसे Potato केवल एक flag मानता है।
Tooltip
लेबल के सीमांत मामले tooltip में लिखे जाने चाहिए, ताकि एनोटेटर कार्य छोड़े बिना जाँच सके कि ORGANIZATION में क्या गिना जाता है। Tooltip हर लेबल की property होते हैं:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      tooltip: "Names of people, characters, or personas"
    - name: ORGANIZATION
      tooltip: "Companies, agencies, institutions"
    - name: LOCATION
      tooltip_file: "config/tooltips/location.html"
tooltip साधारण टेक्स्ट लेता है और tooltip_file किसी HTML फ़ाइल का path लेता है, जो तब बेहतर विकल्प है जब मार्गदर्शन में उदाहरण, bold टेक्स्ट या सूची की ज़रूरत हो। स्कीम-स्तरीय tooltips: map केवल hierarchical_multiselect पढ़ता है और span स्कीम पर उसका कोई असर नहीं होता।
ओवरलैपिंग Span
ओवरलैपिंग की अनुमति दें
Span को ओवरलैप करने की अनुमति है और इस व्यवहार को चालू करने के लिए कोई सेटिंग नहीं है। ओवरलैप तब चाहिए जब टेक्स्ट का एक ही हिस्सा एक साथ दो लेबल रखता हो, जैसे "Dr. Smith", जो PERSON भी है और ROLE भी। संस्करण 2.9.0 से ऐसा selection भी स्वीकार किया जाता है जो किसी मौजूदा span के अंत पर शुरू होता हो या उसकी शुरुआत पर खत्म होता हो, इसलिए आंशिक रूप से ओवरलैप करने वाले span बनाए जा सकते हैं; पुराने संस्करण ऐसे selection को अस्वीकार कर देते थे।
ओवरलैपिंग अक्षम करें (डिफ़ॉल्ट)
Span schema में ऐसी कोई key नहीं है जो ओवरलैप को रोकती हो, इसलिए जिस कार्य में span कभी ओवरलैप नहीं होने चाहिए उसे यह बात अपने एनोटेशन दिशानिर्देशों में कहनी होगी। जब यह अंतर एनोटेटर के बजाय export के लिए मायने रखता हो, तो दो span स्कीम लेबल सेटों को अलग रखती हैं, क्योंकि हर स्कीम अपने span अपने नाम के अंतर्गत संग्रहीत करती है:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: roles
    description: "Label professional roles"
    labels:
      - ROLE
Span चयन मोड
Potato हर span को आइटम टेक्स्ट में character offset के रूप में संग्रहीत करता है, और कोई भी कॉन्फ़िगरेशन key selection को word और character granularity के बीच नहीं बदलती। नीचे के दो मोड बताते हैं कि एनोटेटर क्या कर सकता है, ये ऐसी सेटिंग्स नहीं हैं जिन्हें आप चालू करते हैं।
शब्द-स्तरीय चयन
व्यवहार में अधिकांश NER कार्य पूरे शब्दों पर drag करने जैसा ही दिखता है, और परिणाम चुने गए पहले और आखिरी character के offset के रूप में संग्रहीत होता है। कॉन्फ़िगरेशन में कुछ भी शब्द-सीमाओं को लागू नहीं करता, इसलिए यदि आपके डेटा के लिए पूरे शब्दों वाले span मायने रखते हैं, तो यह आवश्यकता दिशानिर्देशों में लिखें और export में इसकी जाँच करें, इंटरफ़ेस से आंशिक शब्द को अस्वीकार करने की अपेक्षा न रखें।
वर्ण-स्तरीय चयन
किसी शब्द का हिस्सा चुनना हमेशा उपलब्ध है और इसके लिए किसी कॉन्फ़िगरेशन की ज़रूरत नहीं है, और morphological तथा sub-token कार्य इसी पर निर्भर करते हैं। Potato रेंडर करने से पहले spaces और tabs की लगातार श्रृंखलाओं को एक कर देता है ताकि उसके संग्रहीत offset वही हों जो browser मापता है, और यह तब मायने रखता है जब आपके टेक्स्ट में अर्थपूर्ण indentation हो। जब horizontal whitespace को ठीक वैसा ही बना रहना हो, तो instance_display घोषित करें।
पूर्व-एनोटेट Span
किसी कार्य को मॉडल आउटपुट से seed करने पर लेबलिंग सुधार में बदल जाती है, और जब कोई मॉडल पहले से ही अधिकांश corpus पर सही हो, तो यह तेज़ कार्यप्रवाह है। Potato seed एनोटेशन हर आइटम के एक field से पढ़ता है, जिसका नाम pre_annotation.field देता है:
pre_annotation:
  enabled: true
  field: "predictions"
  allow_modification: true
  show_confidence: true
  highlight_low_confidence: 0.7
allow_modification: true ही कार्य को समीक्षा के बजाय सुधार बनाता है, क्योंकि इसके बिना एनोटेटर मॉडल के प्रस्ताव को बदल नहीं सकते। highlight_low_confidence: 0.7 उन आइटमों को चिह्नित करता है जिनके बारे में मॉडल सबसे कम आश्वस्त था, ताकि ध्यान उन span पर जाए जिनके गलत होने की संभावना सबसे अधिक है।
Field में हर स्कीम नाम के लिए एक entry होती है, और span स्कीम offset की एक सूची लेती है:
{
  "id": "item_002",
  "text": "Apple announced new iPhone in California.",
  "predictions": {
    "entities": [
      {"start": 0, "end": 5, "label": "ORG", "confidence": 0.85},
      {"start": 27, "end": 37, "label": "LOC", "confidence": 0.91}
    ]
  }
}
पूर्व-एनोटेशन एक शुरुआती बिंदु हैं, एनोटेशन नहीं, इसलिए जिस आइटम को कोई नहीं खोलता वह खाली export होता है, भले ही वह predictions के साथ आया हो।
सामान्य NER कॉन्फ़िगरेशन
मानक NER (4 प्रकार)
चार-प्रकार वाला सेट CoNLL-2003 परंपरा का पालन करता है, और जब आपके परिणामों की तुलना प्रकाशित NER आँकड़ों से होनी हो, तो यही सही विकल्प है:
- annotation_type: span
  name: ner
  description: "Label named entities"
  labels:
    - PER    # Person
    - ORG    # Organization
    - LOC    # Location
    - MISC   # Miscellaneous
  sequential_key_binding: true
विस्तारित NER (OntoNotes शैली)
अठारह प्रकार बारीक अंतर देते हैं, पर agreement में इसकी वास्तविक कीमत चुकानी पड़ती है, क्योंकि NORP, ORG और GPE के बीच की सीमाएँ ही वह जगह हैं जहाँ एनोटेटर सबसे अधिक असहमत होते हैं। विस्तारित सेट तब उपयोग करें जब downstream कार्य को इन अंतरों की ज़रूरत हो, और लंबे प्रशिक्षण के लिए समय रखें:
- annotation_type: span
  name: ner_extended
  description: "Label named entities using the OntoNotes type set"
  labels:
    - PERSON
    - NORP        # Nationalities, religious/political groups
    - FAC         # Facilities
    - ORG
    - GPE         # Geopolitical entities
    - LOC
    - PRODUCT
    - EVENT
    - WORK_OF_ART
    - LAW
    - LANGUAGE
    - DATE
    - TIME
    - PERCENT
    - MONEY
    - QUANTITY
    - ORDINAL
    - CARDINAL
जैव चिकित्सा NER
जैव चिकित्सा span लंबे और अक्सर nested होते हैं, इसलिए हर प्रकार के लिए एक worked example वाले tooltip यहाँ सामान्य-डोमेन कार्य की तुलना में अधिक फ़ायदा देते हैं:
- annotation_type: span
  name: bio_ner
  description: "Label biomedical entities"
  labels:
    - GENE
    - PROTEIN
    - DISEASE
    - DRUG
    - SPECIES
सोशल मीडिया NER
सोशल मीडिया टेक्स्ट ऐसे entity प्रकार लाता है जिनके लिए newswire सेटों में कोई जगह नहीं है, और CREATIVE_WORK तथा GROUP वे दो प्रकार हैं जो अपना लेबल न होने पर सबसे अधिक बार गलती से ORG में दर्ज हो जाते हैं:
- annotation_type: span
  name: social_ner
  description: "Label named entities in social media text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - PRODUCT
    - CREATIVE_WORK
    - GROUP
गुण के साथ Span
Span स्कीम के साथ एक दूसरी स्कीम पूरे आइटम के बारे में एक निर्णय एकत्र करती है। Potato दोनों को अलग-अलग संग्रहीत करता है, इसलिए radio उत्तर किसी एक span पर नहीं, बल्कि पूरे document पर लागू होता है:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: radio
    name: entity_type
    description: "What type of entity is this?"
    labels:
      - Named
      - Nominal
      - Pronominal
एकाधिक Span स्कीमा
एक ही टेक्स्ट के अलग-अलग पहलुओं को एनोटेट करने का तरीका दो span स्कीम हैं, ताकि एनोटेटर्स को एक संयुक्त लेबल सेट याद न रखना पड़े। हर स्कीम को बटनों की अपनी पंक्ति, अपना key pool और export में अपना field मिलता है:
annotation_schemes:
  # Named entities
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION

  # Sentiment expressions
  - annotation_type: span
    name: sentiment_spans
    description: "Highlight sentiment expressions"
    labels:
      - POSITIVE
      - NEGATIVE
Multi-Field Span Annotation
v2.1.0 में नया
Span annotation target_field विकल्प के ज़रिए multi-field डेटा में किसी विशिष्ट टेक्स्ट field को लक्षित कर सकता है, और इसकी ज़रूरत तब होती है जब किसी आइटम में एक source document और एक summary हो और span उनमें से किसी एक का हो।
कॉन्फ़िगरेशन
हर स्कीम उस field का नाम देती है जिसे वह एनोटेट करती है, ताकि दोनों लेबल सेट सही टेक्स्ट से जुड़े रहें:
annotation_schemes:
  - annotation_type: span
    name: source_entities
    description: "Label entities in the source text"
    target_field: source_text
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: summary_entities
    description: "Label entities in the summary"
    target_field: summary
    labels:
      - PERSON
      - ORGANIZATION
Multi-Field डेटा फॉर्मेट
आपके डेटा में अलग-अलग टेक्स्ट field शामिल होने चाहिए:
{
  "id": "doc1",
  "source_text": "John Smith works at Microsoft in Seattle.",
  "summary": "Smith is employed by Microsoft."
}
आउटपुट फॉर्मेट
target_field का उपयोग करते समय, एनोटेशन field के अनुसार कुंजीबद्ध होते हैं:
{
  "id": "doc1",
  "source_entities": {
    "source_text": [
      {"start": 0, "end": 10, "text": "John Smith", "label": "PERSON"},
      {"start": 20, "end": 29, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  },
  "summary_entities": {
    "summary": [
      {"start": 0, "end": 5, "text": "Smith", "label": "PERSON"},
      {"start": 22, "end": 31, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  }
}
एक पूर्ण कार्यशील उदाहरण के लिए, Potato रिपॉजिटरी में project-hub/simple_examples/simple-multi-span/ देखें।
प्रदर्शन विकल्प
Span में लेबल दिखाएँ
Potato डिफ़ॉल्ट रूप से हर हाइलाइट किए गए span के भीतर लेबल छापता है। कई छोटे span वाले घने document पर लेबल का टेक्स्ट वाक्य को भीड़भाड़ वाला बना देता है, और show_span_labels: false टेक्स्ट को पठनीय रखता है जबकि हाइलाइट का रंग लेबल की जानकारी देता रहता है:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  show_span_labels: false
रेखांकन शैली
Span schema में हाइलाइट शैली के लिए कोई key नहीं है, और span हमेशा रंगीन पृष्ठभूमि के रूप में रेंडर होते हैं। रेखांकन और bracket रेंडरिंग coreference प्रकार के विकल्प हैं, visual_display.highlight_mode के ज़रिए, इसलिए जिस कार्य को इनमें से किसी की ज़रूरत हो उसे Coreference शृंखलाएँ का उपयोग करना चाहिए।
आउटपुट फॉर्मेट
Span एनोटेशन character offset के साथ सहेजे जाते हैं:
{
  "id": "doc1",
  "entities": [
    {
      "start": 0,
      "end": 10,
      "text": "John Smith",
      "label": "PERSON"
    },
    {
      "start": 20,
      "end": 29,
      "text": "Microsoft",
      "label": "ORGANIZATION"
    }
  ]
}
पूर्ण उदाहरण: NER कार्य
item_properties उन fields के नाम देता है जिन्हें Potato आइटम id और उसके टेक्स्ट के लिए पढ़ता है, और इसके बिना config शुरू नहीं होगा। पाँच entity प्रकारों को sequential_key_binding के ज़रिए number row से key मिलती हैं, और अंत की radio स्कीम कठिनाई का एक निर्णय दर्ज करती है जो बाद में यह समझाने में उपयोगी होता है कि agreement कहाँ गिरा:
annotation_task_name: "Named Entity Recognition"

data_files:
  - data/documents.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight and label all named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
      - DATE
      - MONEY
    sequential_key_binding: true
    allow_discontinuous: false

  - annotation_type: radio
    name: difficulty
    description: "How difficult was this document to annotate?"
    labels:
      - Easy
      - Medium
      - Hard

output_annotation_dir: annotation_output
export_annotation_format: jsonl
Discontinuous Span
v2.2.0 में नया
allow_discontinuous: true एनोटेटर को टेक्स्ट के कई गैर-सन्निकट हिस्से चुनकर उन्हें एक span के रूप में दर्ज करने देता है, और split antecedents तथा discontinuous constituents को इसी की ज़रूरत होती है। Discontinuity ओवरलैप से अलग चीज़ है, और इस key का इस पर कोई असर नहीं होता कि दो span एक ही characters को ढक सकते हैं या नहीं:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  allow_discontinuous: true
यह विकल्प चालू होने पर, एनोटेटर और टेक्स्ट को मौजूदा span में जोड़ने के लिए उसे चुनते समय Windows और Linux पर Ctrl, या Mac पर Cmd, दबाए रखता है। आउटपुट में हर खंड के लिए start और end की एक जोड़ी होती है।
Entity Linking एकीकरण
v2.2.0 में नया
Span स्कीम में entity_linking block जोड़कर span एनोटेशन को बाहरी knowledge bases (Wikidata, UMLS, या कस्टम REST APIs) से जोड़ा जा सकता है। हर span पर लिंकिंग का अतिरिक्त चरण तब सार्थक है जब दो entities का surface form एक जैसा हो और अकेला लेबल उन्हें अलग न कर सके:
- annotation_type: span
  name: entities
  description: "Highlight and link named entities"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
  entity_linking:
    enabled: true
    knowledge_bases:
      - name: wikidata
        type: wikidata
        language: en
    auto_search: true
    required: false
auto_search: true span बनते ही खोज चला देता है, जिससे उन कार्यों में एक क्लिक बचता है जहाँ अधिकांश span लिंक किए जाते हैं। required: true बिना लिंक वाले span को सहेजने से मना कर देता है, इसलिए इसे तब तक बंद रखें जब तक आपके डेटा की हर entity के knowledge base में होने की अपेक्षा न हो। जब entity linking सक्षम होती है, तो हर span के control bar पर एक लिंक आइकन दिखाई देता है, और उस पर क्लिक करने से एक search modal खुलता है। पूर्ण विवरण के लिए Entity लिंकिंग दस्तावेज़ीकरण देखें।
सर्वोत्तम प्रथाएँ
- जिन लेबलों को रंग की ज़रूरत है, उन्हीं पर रंग लिखें और बाकी palette पर छोड़ दें
- सीमांत मामले
tooltipयाtooltip_fileमें रखें, हर लेबल के लिए एक, स्कीम के description में नहीं - दो से अधिक लेबल वाली किसी भी स्कीम के लिए
sequential_key_bindingचालू करें, और जहाँ mnemonic key मदद करे वहाँkey_valueजोड़ें - ओवरलैप नीति दिशानिर्देशों में तय करें, क्योंकि schema कोई नीति लागू नहीं करता
- सुधार कार्यप्रवाह के लिए
pre_annotationसे seed करें, औरallow_modification: trueरखें - लेबल सेट छोटा रखें और असंबंधित पहलुओं को अलग span स्कीमों में बाँटें
अधिक पढ़ें
- Entity लिंकिंग - Span को knowledge base से जोड़ें
- Coreference शृंखलाएँ - सह-संदर्भित उल्लेखों को समूहित करें
- घटना एनोटेशन - Span argument के साथ N-ary event संरचनाएँ
- Span लिंकिंग - Span के बीच संबंध बनाएँ
- इंस्टेंस डिस्प्ले - Span लक्ष्य के साथ multi-field सामग्री प्रदर्शन
- UI कॉन्फ़िगरेशन - Span रंग कस्टमाइज़ करें
- उत्पादकता सुविधाएँ - कीबोर्ड शॉर्टकट
कार्यान्वयन विवरण के लिए, स्रोत दस्तावेज़ीकरण देखें।