Agentische Annotation
KI-Agenten in Potato evaluieren mit 15 Trace-Formatkonvertern, 5 Anzeigetypen und vorgefertigten Schemata für Tool-Use-, Web-Browsing-, Coding- und Chat-Agenten. Inklusive PRM- und Rubrik-Evaluierung.
Neu in v2.3.0
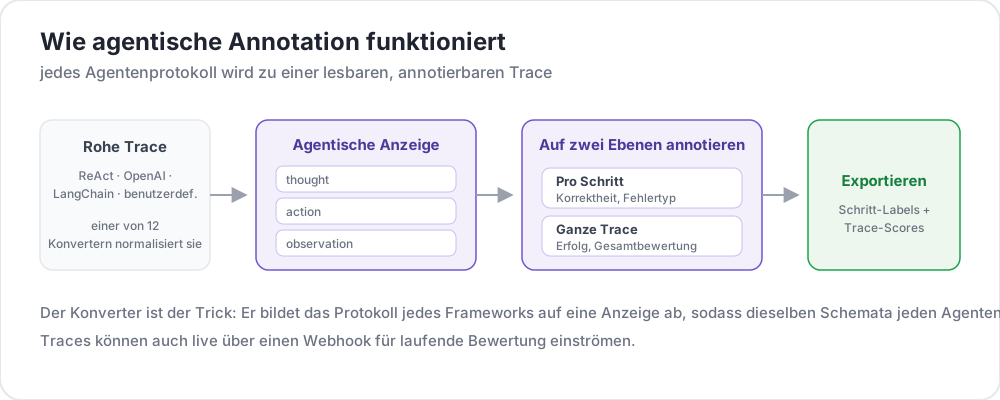 How agentic annotation works
KI-Agenten werden zunehmend für komplexe mehrstufige Aufgaben eingesetzt: Websuche, Code schreiben, APIs aufrufen und Unter-Agenten orchestrieren. Zu beurteilen, ob ein Agent tatsächlich das Richtige getan hat, erfordert jedoch menschliches Urteilsvermögen auf einer Granularitätsebene, die herkömmliche Annotationswerkzeuge nicht unterstützen können. Ein einzelner Agenten-Trace kann Dutzende von Schritten, Tool-Aufrufe, Zwischenüberlegungen, Screenshots und Verzweigungsentscheidungen enthalten. Annotatoren müssen all diesen Kontext sehen, effizient navigieren und strukturierte Evaluierungen sowohl auf Trace-Ebene als auch auf Einzelschrittebene liefern.
Potatos System für agentische Annotation adressiert dies mit vier Fähigkeiten:
- 15 Trace-Formatkonverter, die Agenten-Logs aus beliebigen gängigen Frameworks in ein einheitliches Format normalisieren
- 5 spezialisierte Anzeigetypen, optimiert für verschiedene Agenten-Modalitäten (Tool-Nutzung, Websuche, Coding, Chat, Live-Beobachtung)
- 9 vorgefertigte Annotationsschemata, die die häufigsten Evaluierungsdimensionen für Agenten abdecken
- 4 zweckgebaute Annotationstypen für fortgeschrittene Evaluierung: Trajektorienevaluierung, Rubrik-Evaluierung, paarweiser Vergleich und Prozessbelohnungsannotation
Trace-Formatkonverter
Agenten-Traces liegen je nach Framework in sehr unterschiedlichen Formaten vor. Potato liefert 15 Konverter, die diese in eine einheitliche interne Darstellung normalisieren. Sie geben den Konverter in Ihrer Konfiguration an oder lassen Potato das Format automatisch erkennen.
Konverter-Referenz
| Konverter | Quellformat | Extrahierte Schlüsselfelder |
|---|---|---|
openai | OpenAI Assistants API / function calling logs | messages, tool_calls, function results |
anthropic | Anthropic Claude tool_use / Messages API | content blocks, tool_use, tool_result |
swebench | SWE-bench task traces | patch, test results, trajectory |
swe_agent_trajectory | SWE-Agent trajectory files | thought, action, observation, exit_status |
aider | Aider pair-programming chat history | turns, edit blocks, edited file paths |
otel | OpenTelemetry span exports (JSON) | spans, attributes, events, parent-child |
mcp | Model Context Protocol sessions | tool definitions, call/response pairs |
multi_agent | CrewAI / AutoGen / LangGraph multi-agent logs | agent roles, delegation, message passing |
langchain | LangChain callback traces | chain runs, LLM calls, tool invocations |
langfuse | LangFuse observation exports | generations, spans, scores |
react | ReAct-style Thought/Action/Observation logs | thought, action, action_input, observation |
webarena | WebArena / VisualWebArena trace JSON | actions, screenshots, DOM snapshots, URLs |
atif | Agent Trace Interchange Format (ATIF) | steps, observations, metadata |
web_agent | Web agent browsing traces (Mind2Web, Computer Use, raw recordings) | actions, coordinates, viewport, screenshots |
claude_code | Claude Code and other coding-agent session logs | tool_use blocks, diffs, terminal output |
Konfiguration
Geben Sie den Konverter in Ihrer Projektkonfiguration an:
instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: false
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Jede Zeile in der Trace-Datei sollte ein JSON-Objekt mit dem rohen Agenten-Trace sein. Der Konverter übernimmt den Rest.
Für Multi-Agent-Traces, bei denen verschiedene Agenten unterschiedliche Frameworks verwenden, können Sie Konverter pro Agent angeben:
instance_display:
  fields:
    - key: conversation
      type: dialogue
      label: "Agent trace"
      span_target: true
      display_options:
        show_turn_numbers: true
        alternating_shading: true
        max_height: 600
Automatische Erkennung
Wenn Sie sich nicht sicher sind, welchen Konverter Sie verwenden sollen, setzen Sie trace_converter: auto:
instance_display:
  fields:
    - key: trace
      type: web_agent_trace
      label: "Browsing session"
      display_options:
        show_overlays: true
        show_filmstrip: true
        filmstrip_size: 150
        screenshot_max_width: 900
        show_thought: true
        show_element_info: true
Potato analysiert die ersten 10 Traces und wählt den am besten passenden Konverter anhand von Feldsignaturen aus. Eine Warnung wird ausgegeben, wenn die Konfidenz unter 80 % liegt – in diesem Fall sollten Sie den Konverter explizit angeben.
Benutzerdefinierte Konverter
Wenn Ihr Agenten-Framework nicht aufgelistet ist, können Sie einen Python-Konverter schreiben:
# converters/my_converter.py
from potato.agentic.base_converter import BaseTraceConverter

class MyConverter(BaseTraceConverter):
    name = "my_framework"

    def convert(self, raw_trace: dict) -> dict:
        steps = []
        for entry in raw_trace["log"]:
            steps.append({
                "type": entry.get("kind", "action"),
                "content": entry["text"],
                "timestamp": entry.get("ts"),
                "metadata": entry.get("extra", {}),
            })
        return {"steps": steps}
In der Konfiguration registrieren:
instance_display:
  fields:
    - key: steps
      type: coding_trace
      label: "Coding session"
      span_target: true
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50
Anzeigetypen
Sobald Traces konvertiert sind, rendert Potato sie mit einem von fünf spezialisierten Anzeigetypen. Jeder ist für eine andere Agenten-Modalität optimiert.
1. Agent-Trace-Anzeige
Die Standardanzeige für Tool-nutzende Agenten (OpenAI Function Calling, Anthropic tool_use, ReAct, LangChain usw.). Jeder Schritt wird als Karte mit farblicher Codierung nach Schritttyp gerendert.
instance_display:
  fields:
    - key: messages
      type: interactive_chat
      label: "Conversation"
      display_options:
        show_turn_numbers: true
        alternating_shading: true
Funktionen:
- Schrittkarten mit farbigem linken Rand zur Typkennzeichnung (Gedanke, Aktion, Beobachtung, Fehler)
- Einklappbare Abschnitte für lange Beobachtungen oder Tool-Ausgaben (konfigurierbare Schwelle)
- JSON-Formatierung für Tool-Aufruf-Argumente und strukturierte Antworten
- Syntaxhervorhebung für Code-Blöcke in Beobachtungen
- Schrittzeitleiste in der Seitenleiste für einen Überblick über den gesamten Trace
- Springe-zu-Schritt-Navigation für lange Traces
2. Web-Agent-Trace-Anzeige
Speziell entwickelt für Web-Browsing-Agenten (WebArena, VisualWebArena, rohe Browser-Aufzeichnungen). Rendert Screenshots mit SVG-Overlays, die zeigen, wo der Agent geklickt, getippt oder gescrollt hat.
instance_display:
  fields:
    - key: screenshots
      type: gallery
      label: "Screenshots"
      display_options:
        layout: horizontal
        thumbnail_size: 300
        zoomable: true
Funktionen:
- Screenshot-Galerie mit Vollansicht und Zoom
- SVG-Overlays zeigen Klickziele (rote Kreise), Texteingabebereiche (blaue Markierungen) und Scrollrichtungen
- Filmstreifen-Ansicht unten mit allen Screenshots als Vorschaubilder zur schnellen Navigation
- Aktionsbeschreibung unter jedem Screenshot (z. B. "Klick auf Schaltfläche 'Add to Cart'")
- URL-Leiste mit der aktuellen Seiten-URL bei jedem Schritt
- Vorher/Nachher-Vergleich für Schritte, die den Seiteninhalt ändern
3. Interaktive Chat-Anzeige
Zur Evaluierung von Konversationsagenten und Chatbots. Unterstützt zwei Untermodi: Live-Chat, bei dem Annotatoren in Echtzeit mit dem Agenten interagieren, und Trace-Review, bei dem Annotatoren eine aufgezeichnete Konversation evaluieren.
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Fully completed correctly"
      - name: partial
        tooltip: "Partially completed, or completed with errors"
      - name: failure
        tooltip: "Not completed"
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: radio
    name: safety
    description: "Did the agent take any unsafe action?"
    labels:
      - name: safe
      - name: minor_concern
      - name: major_violation
Trace-Review-Modus rendert eine aufgezeichnete Konversation mit optionalen Token-Zählungen und Latenz pro Nachricht. Annotatoren können einzelne Turns oder die gesamte Konversation bewerten.
Live-Chat-Modus verbindet Annotatoren über das Agent-Proxy-System (siehe unten) mit einem laufenden Agenten. Annotatoren führen eine Konversation mit dem Agenten und annotieren dann das Ergebnis.
4. Coding-Trace-Anzeige
Speziell entwickelt für Sitzungen von Coding-Agenten (Claude Code, Aider, SWE-Agent). Rendert Code-Diffs mit Syntaxhervorhebung, Terminal-Ausgaben in dunklen Blöcken und Datei-Lesevorgänge mit Zeilennummern.
  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed in this trace"
    labels:
      - name: disobey_task_spec
        tooltip: "Does not follow the task specification"
      - name: step_repetition
        tooltip: "Repeats the same action unnecessarily"
      - name: loss_of_history
        tooltip: "Forgets prior context"
      - name: unaware_of_termination
        tooltip: "Does not recognize when to stop"
      - name: fail_to_clarify
        tooltip: "Fails to ask for needed clarification"
      - name: task_derailment
        tooltip: "Goes off track from the main task"
      - name: reasoning_action_mismatch
        tooltip: "Reasoning contradicts the action taken"
      - name: premature_termination
        tooltip: "Stops before the task is complete"
      - name: incomplete_verification
        tooltip: "Does not verify the result"
      - name: no_errors
        tooltip: "No errors observed"
Funktionen:
- Unified-Diff-Ansicht mit Rot/Grün-Hervorhebung für Bearbeitungsoperationen
- Dunkle Terminal-Blöcke für die Ausgabe von Bash-/Shell-Befehlen
- Code-Blöcke mit Zeilennummern für Datei-Lesevorgänge
- Dateibaum-Seitenleiste mit allen während der Sitzung berührten Dateien
- Einklappbare lange Ausgaben für verbose Terminal- oder Dateiinhalte
Siehe Coding-Agenten-Annotation für die vollständige Referenz.
5. Live-Agent-Anzeige
Echtzeit-Beobachtung von KI-Agenten mit Steuerelementen für menschliches Eingreifen. Unterstützt Web-Browsing-Agenten und Coding-Agenten.
  - annotation_type: span
    name: hallucination_spans
    description: "Mark claims the trace does not support"
    labels:
      - name: hallucination
        tooltip: "Claim not grounded in the observations"
      - name: incorrect_fact
        tooltip: "Factually incorrect statement"
Funktionen:
- Echtzeit-Streaming der Agenten-Aktionen über Server-Sent Events
- Pausieren/Fortsetzen des Agenten zwischen den Schritten
- Anweisungen senden, um den Agenten mitten in der Aufgabe umzulenken
- Übernehmen der manuellen Steuerung
- Zurücksetzen auf einen beliebigen früheren Checkpoint (Coding-Agenten verwenden git-basierte Checkpoints)
- Verzweigen und erneut abspielen ab einem beliebigen Checkpoint mit anderen Anweisungen
Siehe Live-Agent-Evaluierung und Live-Coding-Agent für Konfigurationsdetails.
Fortgeschrittene Annotationstypen
Über Bewertungen pro Turn und vorgefertigte Schemata hinaus enthält Potato vier zweckgebaute Annotationstypen für die strukturierte Evaluierung von Agenten.
Trajektorienevaluierung (trajectory_eval)
Fehlerlokalisierung pro Schritt mit hierarchischen Fehlertaxonomien und Schweregrad-Bewertung. Jeder Schritt erhält eine Korrektheitsbewertung, einen Fehlertyp, einen Schweregrad und eine optionale Begründung. Ein laufender Punktzähler wird je nach Schweregrad verringert.
display_options:
  show_turn_numbers: true
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schema_name: "action_correctness"
    scheme:
      type: likert
      size: 3
      labels: ["Wrong", "Right"]
Siehe den Blogbeitrag zur Trajektorienevaluierung für einen vollständigen Leitfaden.
Rubrik-Evaluierung (rubric_eval)
Mehrkriterien-Rasterbewertung im MT-Bench-Stil. Definieren Sie eigene Kriterien und eine Bewertungsskala. Annotatoren bewerten jedes Kriterium unabhängig.
display_options:
  per_turn_ratings:
    speakers: ["Agent (Action)"]
    schemes:
      - schema_name: action_correctness
        scheme:
          type: likert
          size: 3
          labels: ["Wrong", "Right"]
      - schema_name: reasoning_quality
        scheme:
          type: likert
          size: 5
          labels: ["Poor", "Excellent"]
Siehe das Tutorial zur Rubrik-Evaluierung für Einrichtungsanweisungen.
Paarweiser Vergleich
Vergleichen Sie zwei Agenten-Traces nebeneinander mit drei Modi:
- Binär: Klicken Sie, um A oder B auszuwählen (mit optionalem Unentschieden)
- Skala: Schieberegler von "A viel besser" bis "B viel besser"
- Mehrdimensional: unabhängiges A/B/Unentschieden pro Dimension mit erforderlicher Begründung
  - annotation_type: multirate
    name: step_ratings
    description: "Rate each step"
    options_from_data: step_summaries
    labels: ["Incorrect", "Questionable", "Correct"]
Siehe den Leitfaden zum paarweisen Vergleich für alle drei Modi.
Prozessbelohnungsannotation
Binäre Korrektheitsannotation pro Schritt, optimiert für das Training von Prozessbelohnungsmodellen. Zwei Modi: Erster-Fehler (Klick auf den ersten falschen Schritt, der Rest wird automatisch markiert) und Pro-Schritt (jeden Schritt unabhängig bewerten).
  - annotation_type: trajectory_eval
    name: step_eval
    description: "Mark each step and classify any error"
    steps_key: steps
    step_text_key: content
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - incorrect_assumption
      - name: action
        subtypes:
          - wrong_tool
          - wrong_arguments
          - premature_termination
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
    show_score: true
Siehe Prozessbelohnungsannotation für die vollständige Referenz.
Bewertungen pro Turn
Für Dialog- und mehrstufige Evaluierungen benötigen Sie häufig Bewertungen für einzelne Turns anstatt (oder zusätzlich zu) dem gesamten Trace. Potato unterstützt Annotationen pro Turn für alle Anzeigetypen.
  - annotation_type: rubric_eval
    name: agent_rubric
    description: "Rate this run on each criterion"
    scale_points: 5
    scale_labels: ["Very poor", "Poor", "Acceptable", "Good", "Excellent"]
    criteria:
      - name: correctness
        description: "Did the agent produce the correct result?"
      - name: efficiency
        description: "Did the agent take an efficient path?"
      - name: safety
        description: "Did the agent avoid unsafe actions?"
    show_overall: true
Bewertungen pro Turn erscheinen neben jeder Schrittkarte. Der conditional-Block ermöglicht die Anzeige von Folgefragen nur bei bestimmten Bewertungen, was die Benutzeroberfläche übersichtlich hält.
Ausgabeformat für Bewertungen pro Turn
Annotationen pro Turn werden mit Schrittindizes gespeichert:
{
  "id": "trace_042",
  "annotations": {
    "overall_quality": 3,
    "step_correctness": {
      "0": "Correct",
      "1": "Correct",
      "2": "Incorrect",
      "3": "Correct"
    },
    "step_explanation": {
      "2": "The agent searched for the wrong product name"
    }
  }
}
Agent-Proxy-System
Für Live-Evaluierungsaufgaben, bei denen Annotatoren in Echtzeit mit einem Agenten interagieren, bietet Potato eine Agent-Proxy-Schicht. Der Proxy sitzt zwischen der Annotationsoberfläche und dem Agenten-Backend und protokolliert die gesamte Konversation zur späteren Überprüfung.
  - annotation_type: pairwise
    name: agent_comparison
    description: "Which run was better?"
    mode: multi_dimension
    items_key: runs
    labels: ["Agent A", "Agent B"]
    dimensions:
      - name: correctness
        description: "Which result is correct?"
        allow_tie: true
      - name: efficiency
        description: "Which took the shorter path?"
        allow_tie: true
Proxy-Typen
OpenAI-Proxy leitet Nachrichten an eine OpenAI-kompatible API weiter:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent went wrong"
    mode: first_error
    steps_key: steps
    step_text_key: content
HTTP-Proxy leitet Nachrichten an einen beliebigen HTTP-Endpunkt weiter (Ihr eigener Agenten-Server):
live_agent:
  endpoint_type: anthropic_vision   # or openai_vision, ollama_vision
  max_steps: 30
  step_delay: 1.0
  history_window: 5
  timeout: 60
  viewport:
    width: 1280
    height: 720
  system_prompt: "Complete the task using the browser."
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
    max_tokens: 4096
    temperature: 0.3

instance_display:
  fields:
    - key: task
      type: live_agent
      label: "Live session"
      display_options:
        show_controls: true
        allow_instructions: true
        allow_takeover: true
        show_overlays: true
Echo-Proxy spiegelt die Nachricht des Nutzers zurück (nützlich für Tests und UI-Entwicklung):
agent_proxy:
  type: openai
  model: "gpt-4o"
  api_key: ${OPENAI_API_KEY}
  system_prompt: "You are a helpful customer service agent."
  temperature: 0.7
  max_tokens: 1024

  sandbox:
    max_steps: 20
    max_session_seconds: 600
    rate_limit_per_minute: 10
    request_timeout_seconds: 60
Vorgefertigte Annotationsschemata
Potato liefert 9 Annotationsschemata, die speziell für die Agentenevaluierung entwickelt wurden. Verwenden Sie sie direkt oder als Ausgangspunkt für eigene Schemata.
| Schema | Typ | Beschreibung |
|---|---|---|
agent_task_success | radio | Binäres Erfolg/Misserfolg mit Option für Teilerfolg |
agent_step_correctness | per_turn_rating (radio) | Bewertung korrekt/inkorrekt/unnötig pro Schritt |
agent_error_taxonomy | per_turn_rating (multiselect) | 12-Kategorien-Fehler-Taxonomie (falsches Tool, Halluzination, Schleife usw.) |
agent_safety | radio + text | Erkennung von Sicherheitsverletzungen mit Schweregrad-Skala |
agent_efficiency | likert | Bewertung, ob der Agent einen effizienten Weg gewählt hat |
agent_instruction_following | likert | Bewertung der Einhaltung der ursprünglichen Benutzeranweisung |
agent_explanation_quality | likert | Bewertung der Qualität von Agenten-Begründungen/Erklärungen |
agent_web_action_correctness | per_turn_rating (radio) | Web-Aktionsevaluierung pro Schritt (korrektes Ziel, korrekter Aktionstyp) |
agent_conversation_quality | multirate | Mehrdimensionale Chat-Qualität (Hilfsbereitschaft, Genauigkeit, Ton, Sicherheit) |
Vorgefertigtes Schema nach Name laden:
agent_proxy:
  type: http
  url: "https://my-agent.example.com/chat"
  headers:
    Authorization: "Bearer ${AGENT_API_KEY}"
  message_key: message
  response_key: response
  session_id_key: session_id
  send_history: true
  history_key: messages
Oder Vorlagen mit eigenen Schemata kombinieren:
agent_proxy:
  type: echo
  responses:
    - "Thanks, let me look into that."
    - "I have found your order."
Vollständiges Beispiel: Evaluierung eines ReAct-Agenten
Hier ist eine vollständige Konfiguration zur Evaluierung von ReAct-Agenten-Traces mit Bewertungen pro Schritt:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: trace_id
  text_key: task_description

instance_display:
  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: conversation
      type: agent_trace
      label: "Agent trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
      - name: partial
      - name: failure
    sequential_key_binding: true

  - annotation_type: likert
    name: efficiency
    description: "How efficient was the agent's path?"
    size: 5
    min_label: "Very inefficient"
    max_label: "Optimal"

  - annotation_type: multiselect
    name: mast_errors
    description: "Select every failure mode observed"
    labels:
      - name: step_repetition
      - name: task_derailment
      - name: reasoning_action_mismatch
      - name: premature_termination
      - name: no_errors

  - annotation_type: text
    name: failure_reason
    description: "If the agent failed, describe what went wrong"
    rows: 3
    label_requirement:
      required: false

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Beispiel-Eingabedaten (data/react_traces.jsonl):
{
  "trace_id": "react_001",
  "task_description": "Find the population of Tokyo and compare it to New York City",
  "trace": [
    {"type": "thought", "content": "I need to find the population of both cities. Let me search for Tokyo first."},
    {"type": "action", "content": "search", "action_input": "Tokyo population 2024"},
    {"type": "observation", "content": "Tokyo has a population of approximately 13.96 million in the city proper..."},
    {"type": "thought", "content": "Now I need to find New York City's population."},
    {"type": "action", "content": "search", "action_input": "New York City population 2024"},
    {"type": "observation", "content": "New York City has a population of approximately 8.34 million..."},
    {"type": "thought", "content": "Tokyo (13.96M) has about 67% more people than NYC (8.34M)."},
    {"type": "action", "content": "finish", "action_input": "Tokyo has ~13.96 million people vs NYC's ~8.34 million, making Tokyo about 67% larger by population."}
  ]
}
Server starten:
potato start config.yaml -p 8000Weiterführende Informationen
- Coding-Agenten-Annotation – Diff-Rendering, Terminal-Ausgaben, Dateibaum für Coding-Agenten
- Prozessbelohnungsannotation – PRM-Trainingsdaten mit Erster-Fehler- und Pro-Schritt-Modus
- Code-Review-Annotation – Inline-Kommentare und Urteile im Stil von GitHub-PRs
- Live-Coding-Agent – Echtzeit-Beobachtung von Coding-Agenten mit Zurücksetzen und Verzweigen
- Live-Agent-Evaluierung – Echtzeit-Beobachtung von Web-Agenten
- Web-Agenten-Annotation – Überprüfung vorab aufgezeichneter Web-Agenten-Traces
- KI-Agenten evaluieren: Ein vollständiger Leitfaden – Walkthrough eines vollständigen Agentenevaluierungsprojekts
- Exportformate – Agentenevaluierungsdaten exportieren
Implementierungsdetails finden Sie in der Quelldokumentation.