Spannen-Annotation
Textspannen in Potato für Named-Entity-Recognition hervorheben und beschriften, mit Farben pro Beschriftung, Tastaturkürzeln, Tooltips und diskontinuierlichen Spannen.
Mit der Spannen-Annotation wählen Annotatoren Textabschnitte aus und beschriften sie. So werden in Potato Aufgaben zur Named-Entity-Recognition (NER), zum Part-of-Speech-Tagging und zur Texthervorhebung aufgebaut. Eine Beschriftung wird entweder als einfacher String geschrieben oder als Objekt mit eigenem color, key_value und tooltip. Potato liest diese drei als Eigenschaften der einzelnen Beschriftung, daher hat eine Map colors, key_values oder tooltips auf Schema-Ebene bei einem Spannen-Schema keine Wirkung.
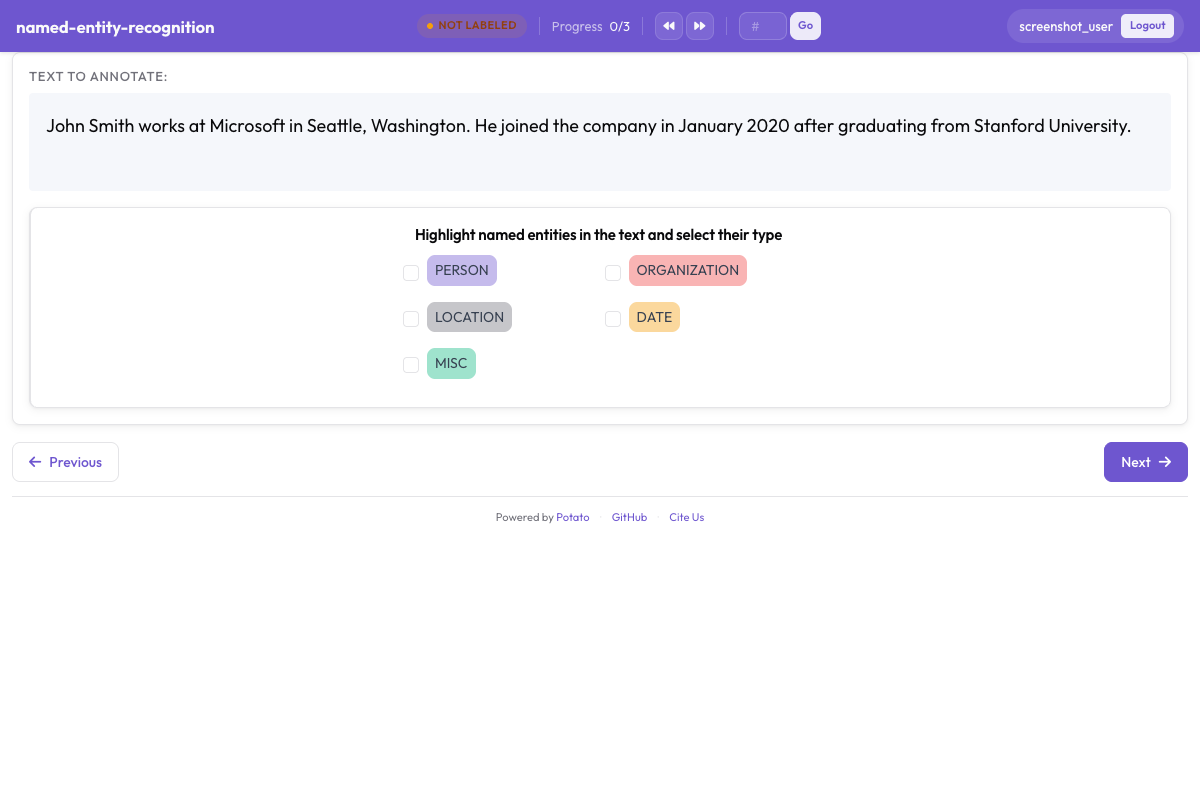 Spannen-Annotation mit farbcodierten Entitätsbeschriftungen in Potato
Grundkonfiguration
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
description ist bei jedem Schema erforderlich und erscheint über den Beschriftungsschaltflächen als die Anweisung, die der Annotator liest. Sie sollte deshalb die Beschriftungsentscheidung benennen, statt den Schemanamen zu wiederholen. Beschriftungen, die als einfache Strings geschrieben sind, erhalten ihre Farben aus Potatos Palette in der Reihenfolge, in der sie aufgeführt sind.
Konfigurationsoptionen
Entitätsbeschriftungen
Der Beschriftungssatz ist die zentrale Designentscheidung bei einer Spannen-Aufgabe, weil Recall, Übereinstimmung und jede spätere Messung an ihm definiert sind. Halten Sie ihn so klein, dass Annotatoren ihn im Kopf behalten können, ohne bei jeder Spanne die Richtlinien nachzuschlagen. In der Praxis heißt das für die meisten NER-Aufgaben vier bis acht Typen. Fügen Sie die Beschriftungen dem obigen Schema hinzu:
labels:
  - PERSON
  - ORGANIZATION
  - LOCATION
  - DATE
  - EVENT
Farben
Potato weist jeder Beschriftung in Listenreihenfolge eine Palettenfarbe zu. Farben lohnt es sich daher nur dann auszuschreiben, wenn eine bestimmte Kombination wichtig ist, etwa bei zwei Typen, die oft im selben Satz vorkommen und auf einen Blick nicht leicht zu verwechseln sein sollen. Eine Farbe gehört zur Beschriftung:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - name: PERSON
        color: "#3b82f6"
      - name: ORGANIZATION
        color: "#10b981"
      - name: LOCATION
        color: "#f59e0b"
      - DATE
Werte sind Hex (#3b82f6) oder rgb(255, 0, 0). Eine Beschriftung, die als einfacher String bleibt, wie DATE oben, erhält die nächste Palettenfarbe. Ein Schema kann also Farben für die Beschriftungen angeben, die sie brauchen, und den Rest unverändert lassen.
Farben für mehrere Schemata lassen sich auch an einer Stelle festlegen, unter ui.label_colors, geschlüsselt nach Schemaname und dann nach Beschriftung:
ui:
  label_colors:
    entities:
      PERSON: "#3b82f6"
      ORGANIZATION: "#10b981"
Eine Map colors:, die direkt im Schema steht, ist kein Schlüssel, den Potato liest. Ein Schema mit einer solchen Map wird mit Palettenfarben dargestellt, als gäbe es den Block nicht.
Tastaturkürzel
Tastaturkürzel lohnen sich bei jeder Spannen-Aufgabe mit mehr als zwei Beschriftungen. Ein Annotator, der für jede Spanne die Maus zu einer Schaltfläche bewegt, arbeitet nur einen Bruchteil so schnell wie einer, der beide Hände am Text behält. Mit sequential_key_binding: true erhalten die Beschriftungen Tasten in der Reihenfolge, in der sie aufgeführt sind:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - DATE
  sequential_key_binding: true
Hat eine Aufgabe mehrere Schemata auf der Seite, teilt Potato jedem Schema Tasten aus einem eigenen Vorrat zu. Zuerst kommt die Zahlenreihe, dann die obere Buchstabenreihe, dann die Grundreihe, sodass Kürzel verschiedener Schemata nie kollidieren.
Um eine Beschriftung an eine bestimmte Taste statt an ihre Position in der Liste zu binden, geben Sie der Beschriftung ein key_value. Die Zuteilung berücksichtigt ein explizites key_value, bevor sie irgendetwas automatisch vergibt, und mnemonische Tasten überstehen eine spätere Umsortierung der Beschriftungsliste, positionsbasierte dagegen nicht:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      key_value: "p"
    - name: ORGANIZATION
      key_value: "o"
    - LOCATION
  sequential_key_binding: true
Eine Map key_values: auf Schema-Ebene wird nicht gelesen, ebenso wenig eine Map als Wert von sequential_key_binding, das Potato nur als Flag behandelt.
Tooltips
In einen Tooltip gehören die Grenzfälle einer Beschriftung, damit ein Annotator nachsehen kann, was als ORGANIZATION zählt, ohne die Aufgabe zu verlassen. Tooltips sind Eigenschaften der einzelnen Beschriftung:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      tooltip: "Names of people, characters, or personas"
    - name: ORGANIZATION
      tooltip: "Companies, agencies, institutions"
    - name: LOCATION
      tooltip_file: "config/tooltips/location.html"
tooltip nimmt einfachen Text, tooltip_file einen Pfad zu einer HTML-Datei. Letzteres ist die bessere Wahl, wenn die Hinweise Beispiele, Fettdruck oder eine Liste brauchen. Eine Map tooltips: auf Schema-Ebene wird nur von hierarchical_multiselect gelesen und bewirkt bei einem Spannen-Schema nichts.
Überlappende Spannen
Überlappungen erlauben
Spannen dürfen sich überlappen, und es gibt keine Einstellung, die dieses Verhalten einschaltet. Überlappung ist gewünscht, wenn ein Textabschnitt zwei Beschriftungen zugleich trägt, wie bei „Dr. Smith“, das sowohl PERSON als auch ROLE ist. Seit Version 2.9.0 wird auch eine Auswahl akzeptiert, die am Ende einer bestehenden Spanne beginnt oder am Anfang einer solchen endet, sodass sich teilweise überlappende Spannen anlegen lassen. Frühere Versionen lehnten eine solche Auswahl ab.
Überlappungen deaktivieren (Standard)
Das Spannen-Schema hat keinen Schlüssel, der Überlappung verbietet. Eine Aufgabe, bei der sich Spannen nie überlappen sollen, muss das daher in ihren Annotationsrichtlinien festhalten. Wenn die Unterscheidung für den Export statt für den Annotator zählt, halten zwei Spannen-Schemata die Beschriftungssätze getrennt, denn jedes Schema speichert seine Spannen unter seinem eigenen Namen:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: roles
    description: "Label professional roles"
    labels:
      - ROLE
Spannen-Auswahlmodi
Potato speichert jede Spanne als Zeichenoffsets im Text des Items, und kein Konfigurationsschlüssel schaltet die Auswahl zwischen Wort- und Zeichengranularität um. Die beiden folgenden Modi beschreiben, was ein Annotator tun kann, nicht Einstellungen, die Sie einschalten.
Wortebene
Das Ziehen über ganze Wörter ist in der Praxis der Normalfall bei NER, und das Ergebnis wird als Zeichenoffsets des ersten und letzten ausgewählten Zeichens gespeichert. Nichts in der Konfiguration erzwingt Wortgrenzen. Wenn ganze Wörter als Spannen für Ihre Daten wichtig sind, schreiben Sie die Anforderung in die Richtlinien und prüfen Sie sie am Export, statt zu erwarten, dass die Oberfläche ein halbes Wort ablehnt.
Zeichenebene
Die Auswahl eines Wortteils ist jederzeit möglich und braucht keine Konfiguration. Darauf stützen sich morphologische Aufgaben und Aufgaben unterhalb der Token-Ebene. Potato fasst Folgen von Leerzeichen und Tabulatoren vor dem Rendern zusammen, damit die gespeicherten Offsets mit dem übereinstimmen, was der Browser misst. Das spielt eine Rolle, wenn Ihr Text bedeutungstragende Einrückungen enthält. Deklarieren Sie instance_display, wenn horizontaler Leerraum exakt erhalten bleiben muss.
Vorannotierte Spannen
Wer eine Aufgabe mit Modellausgaben vorbelegt, macht aus dem Beschriften ein Korrigieren. Das ist der schnellere Arbeitsablauf, sobald ein Modell beim größten Teil des Korpus bereits richtig liegt. Potato liest vorbelegte Annotationen aus einem Feld jedes Items, dessen Name in pre_annotation.field steht:
pre_annotation:
  enabled: true
  field: "predictions"
  allow_modification: true
  show_confidence: true
  highlight_low_confidence: 0.7
allow_modification: true macht die Aufgabe zu einer Korrektur statt zu einer Durchsicht, denn ohne diese Einstellung können Annotatoren nicht ändern, was das Modell vorgeschlagen hat. highlight_low_confidence: 0.7 markiert die Items, bei denen das Modell am unsichersten war, sodass sich die Aufmerksamkeit auf die Spannen richtet, die am wahrscheinlichsten falsch sind.
Das Feld enthält einen Eintrag pro Schemaname, und ein Spannen-Schema nimmt eine Liste von Offsets:
{
  "id": "item_002",
  "text": "Apple announced new iPhone in California.",
  "predictions": {
    "entities": [
      {"start": 0, "end": 5, "label": "ORG", "confidence": 0.85},
      {"start": 27, "end": 37, "label": "LOC", "confidence": 0.91}
    ]
  }
}
Vorannotationen sind ein Ausgangspunkt und keine Annotation. Ein Item, das niemand öffnet, wird deshalb leer exportiert, obwohl es mit angehängten Vorhersagen ankam.
Häufige NER-Konfigurationen
Standard-NER (4 Typen)
Der Satz aus vier Typen folgt der Konvention von CoNLL-2003. Er ist die richtige Wahl, wenn Ihre Ergebnisse mit veröffentlichten NER-Zahlen vergleichbar sein müssen:
- annotation_type: span
  name: ner
  description: "Label named entities"
  labels:
    - PER    # Person
    - ORG    # Organization
    - LOC    # Location
    - MISC   # Miscellaneous
  sequential_key_binding: true
Erweitertes NER (OntoNotes-Stil)
Achtzehn Typen bringen feinere Unterscheidungen zu einem spürbaren Preis bei der Übereinstimmung, denn an den Grenzen zwischen NORP, ORG und GPE sind sich Annotatoren am häufigsten uneinig. Verwenden Sie den erweiterten Satz, wenn nachgelagerte Arbeiten die Unterscheidungen brauchen, und planen Sie längere Schulungen ein:
- annotation_type: span
  name: ner_extended
  description: "Label named entities using the OntoNotes type set"
  labels:
    - PERSON
    - NORP        # Nationalities, religious/political groups
    - FAC         # Facilities
    - ORG
    - GPE         # Geopolitical entities
    - LOC
    - PRODUCT
    - EVENT
    - WORK_OF_ART
    - LAW
    - LANGUAGE
    - DATE
    - TIME
    - PERCENT
    - MONEY
    - QUANTITY
    - ORDINAL
    - CARDINAL
Biomedizinisches NER
Biomedizinische Spannen sind lang und oft verschachtelt. Tooltips mit einem ausgearbeiteten Beispiel pro Typ zahlen sich hier daher stärker aus als bei einer Aufgabe aus dem allgemeinen Bereich:
- annotation_type: span
  name: bio_ner
  description: "Label biomedical entities"
  labels:
    - GENE
    - PROTEIN
    - DISEASE
    - DRUG
    - SPECIES
Social-Media-NER
Social-Media-Texte bringen Entitätstypen mit, für die die Newswire-Sätze keinen Platz haben. CREATIVE_WORK und GROUP sind die beiden, die ohne eigene Beschriftung am häufigsten fälschlich als ORG eingeordnet werden:
- annotation_type: span
  name: social_ner
  description: "Label named entities in social media text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - PRODUCT
    - CREATIVE_WORK
    - GROUP
Spannen mit Attributen
Ein zweites Schema neben dem Spannen-Schema erfasst ein Urteil über das Item als Ganzes. Potato speichert beide getrennt, daher bezieht sich die Radio-Antwort auf das Dokument und nicht auf eine einzelne Spanne:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: radio
    name: entity_type
    description: "What type of entity is this?"
    labels:
      - Named
      - Nominal
      - Pronominal
Mehrere Spannen-Schemata
Mit zwei Spannen-Schemata annotieren Sie verschiedene Aspekte desselben Texts, ohne dass Annotatoren einen kombinierten Beschriftungssatz im Kopf behalten müssen. Jedes Schema erhält eine eigene Schaltflächenreihe, einen eigenen Tastenvorrat und ein eigenes Feld im Export:
annotation_schemes:
  # Named entities
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION

  # Sentiment expressions
  - annotation_type: span
    name: sentiment_spans
    description: "Highlight sentiment expressions"
    labels:
      - POSITIVE
      - NEGATIVE
Mehrfeld-Spannen-Annotation
Neu in v2.1.0
Die Spannen-Annotation kann über die Option target_field ein bestimmtes Textfeld in Mehrfeld-Daten ansteuern. Das brauchen Sie, wenn ein Item ein Quelldokument und eine Zusammenfassung enthält und eine Spanne zu einem der beiden gehört.
Konfiguration
Jedes Schema benennt das Feld, das es annotiert, sodass die beiden Beschriftungssätze am richtigen Text hängen:
annotation_schemes:
  - annotation_type: span
    name: source_entities
    description: "Label entities in the source text"
    target_field: source_text
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: summary_entities
    description: "Label entities in the summary"
    target_field: summary
    labels:
      - PERSON
      - ORGANIZATION
Mehrfeld-Datenformat
Ihre Daten sollten die separaten Textfelder enthalten:
{
  "id": "doc1",
  "source_text": "John Smith works at Microsoft in Seattle.",
  "summary": "Smith is employed by Microsoft."
}
Ausgabeformat
Bei Verwendung von target_field werden Annotationen nach Feld geschlüsselt:
{
  "id": "doc1",
  "source_entities": {
    "source_text": [
      {"start": 0, "end": 10, "text": "John Smith", "label": "PERSON"},
      {"start": 20, "end": 29, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  },
  "summary_entities": {
    "summary": [
      {"start": 0, "end": 5, "text": "Smith", "label": "PERSON"},
      {"start": 22, "end": 31, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  }
}
Ein vollständiges funktionierendes Beispiel finden Sie unter project-hub/simple_examples/simple-multi-span/ im Potato-Repository.
Anzeigeoptionen
Beschriftung in der Spanne anzeigen
Potato zeigt die Beschriftung standardmäßig innerhalb jeder hervorgehobenen Spanne an. In einem dichten Dokument mit vielen kurzen Spannen drängt der Beschriftungstext den Satz zusammen. show_span_labels: false hält den Text lesbar, während die Hervorhebungsfarbe die Beschriftung weiterhin anzeigt:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  show_span_labels: false
Unterstrich-Stil
Das Spannen-Schema hat keinen Schlüssel für den Hervorhebungsstil, und Spannen werden immer mit farbigem Hintergrund dargestellt. Unterstreichung und Klammerdarstellung sind Optionen des Koreferenz-Typs über visual_display.highlight_mode. Eine Aufgabe, die eine davon braucht, sollte daher Koreferenzketten verwenden.
Ausgabeformat
Spannen-Annotationen werden mit Zeichenoffsets gespeichert:
{
  "id": "doc1",
  "entities": [
    {
      "start": 0,
      "end": 10,
      "text": "John Smith",
      "label": "PERSON"
    },
    {
      "start": 20,
      "end": 29,
      "text": "Microsoft",
      "label": "ORGANIZATION"
    }
  ]
}
Vollständiges Beispiel: NER-Aufgabe
item_properties benennt die Felder, aus denen Potato die Item-ID und den Text liest, und eine Konfiguration ohne diesen Block startet nicht. Die fünf Entitätstypen erhalten über sequential_key_binding Tasten aus der Zahlenreihe. Das abschließende Radio-Schema erfasst eine Einschätzung der Schwierigkeit, die später hilft zu erklären, wo die Übereinstimmung abfiel:
annotation_task_name: "Named Entity Recognition"

data_files:
  - data/documents.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight and label all named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
      - DATE
      - MONEY
    sequential_key_binding: true
    allow_discontinuous: false

  - annotation_type: radio
    name: difficulty
    description: "How difficult was this document to annotate?"
    labels:
      - Easy
      - Medium
      - Hard

output_annotation_dir: annotation_output
export_annotation_format: jsonl
Diskontinuierliche Spannen
Neu in v2.2.0
Mit allow_discontinuous: true kann ein Annotator mehrere nicht benachbarte Textabschnitte auswählen und als eine einzige Spanne erfassen. Das brauchen geteilte Antezedenten und diskontinuierliche Konstituenten. Diskontinuität ist etwas anderes als Überlappung, und der Schlüssel hat keinen Einfluss darauf, ob zwei Spannen dieselben Zeichen abdecken dürfen:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  allow_discontinuous: true
Ist die Option aktiv, hält ein Annotator unter Windows und Linux Strg, auf einem Mac Cmd gedrückt, während er weiteren Text auswählt, um ihn der aktuellen Spanne hinzuzufügen. Die Ausgabe enthält für jedes Segment ein Paar aus Start und Ende.
Entitätsverknüpfungs-Integration
Neu in v2.2.0
Spannen-Annotationen lassen sich mit externen Wissensdatenbanken (Wikidata, UMLS oder benutzerdefinierte REST-APIs) verknüpfen, indem Sie dem Spannen-Schema einen Block entity_linking hinzufügen. Der zusätzliche Schritt pro Spanne lohnt sich, wenn zwei Entitäten dieselbe Oberflächenform haben und die Beschriftung allein sie nicht unterscheiden kann:
- annotation_type: span
  name: entities
  description: "Highlight and link named entities"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
  entity_linking:
    enabled: true
    knowledge_bases:
      - name: wikidata
        type: wikidata
        language: en
    auto_search: true
    required: false
auto_search: true startet die Suche, sobald eine Spanne angelegt wird. Das spart einen Klick bei Aufgaben, in denen die meisten Spannen verknüpft werden. required: true verweigert das Speichern einer Spanne ohne Verknüpfung. Lassen Sie es daher ausgeschaltet, es sei denn, jede Entität in Ihren Daten wird in der Wissensdatenbank erwartet. Bei aktivierter Entitätsverknüpfung erscheint in der Steuerleiste jeder Spanne ein Verknüpfungssymbol, und ein Klick darauf öffnet ein Such-Modal. Vollständige Details finden Sie in der Dokumentation zur Entitätsverknüpfung.
Bewährte Vorgehensweisen
- Farben an die Beschriftungen schreiben, die sie brauchen, und den Rest der Palette überlassen
- Grenzfälle in
tooltipodertooltip_fileablegen, eines pro Beschriftung, statt in der Schemabeschreibung sequential_key_bindingeinschalten für jedes Schema mit mehr als zwei Beschriftungen, undkey_valueergänzen, wo eine mnemonische Taste hilft- Die Überlappungsregel in den Richtlinien festlegen, da das Schema keine erzwingt
- Mit
pre_annotationvorbelegen für Korrektur-Workflows, undallow_modification: truebeibehalten - Den Beschriftungssatz klein halten und unabhängige Aspekte auf separate Spannen-Schemata verteilen
Weiterführende Lektüre
- Entitätsverknüpfung - Spannen mit Wissensdatenbanken verknüpfen
- Koreferenzketten - Koreferente Erwähnungen gruppieren
- Ereignis-Annotation - N-äre Ereignisstrukturen mit Spannen-Argumenten
- Spannenverknüpfung - Beziehungen zwischen Spannen erstellen
- Instanzanzeige - Mehrfeld-Inhaltsanzeige mit Spannen-Zielen
- UI-Konfiguration - Spannenfarben anpassen
- Produktivitätsfunktionen - Tastaturkürzel
Implementierungsdetails finden Sie in der Quelldokumentation.