Qualitätskontrolle
Aufmerksamkeitschecks, Gold-Standards und Inter-Annotator-Übereinstimmungsmetriken.
Potato bietet umfassende Qualitätskontrollfunktionen, um hochwertige Annotationen zu gewährleisten. Dazu gehören Aufmerksamkeitschecks, Gold-Standards, Vorausfüll-Unterstützung und Echtzeit-Übereinstimmungsmetriken.
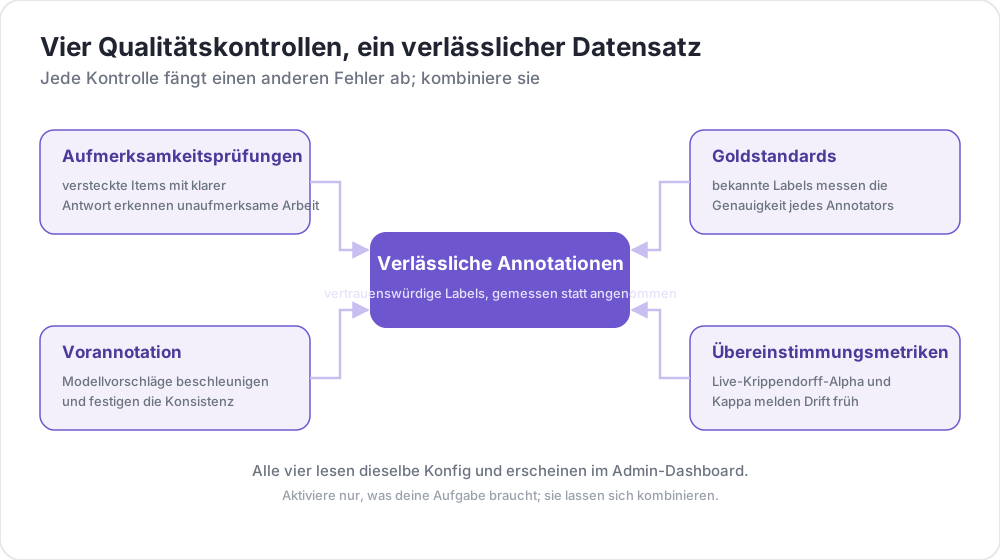 Vier Qualitätskontrollen, ein verlässlicher Datensatz
Übersicht
Qualitätskontrolle in Potato umfasst vier Schlüsselfunktionen:
- Aufmerksamkeitschecks – Annotatorenengagement mit Elementen mit bekannten Antworten überprüfen
- Gold-Standards – Genauigkeit gegenüber expertenannotierten Elementen verfolgen
- Vorausfüll-Unterstützung – Formulare mit Modellvorhersagen vorab ausfüllen
- Übereinstimmungsmetriken – Inter-Annotator-Übereinstimmung in Echtzeit berechnen
Aufmerksamkeitschecks
Aufmerksamkeitschecks sind Elemente mit bekannten richtigen Antworten, die überprüfen, ob Annotatoren aufmerksam sind und nicht zufällig klicken.
Konfiguration
attention_checks:
  enabled: true
  items_file: "attention_checks.json"

  # How often to inject attention checks
  frequency: 10              # Insert one every 10 items
  # OR
  probability: 0.1           # 10% chance per item

  # Optional: flag suspiciously fast responses
  min_response_time: 3.0     # Flag if answered in < 3 seconds

  # Failure handling
  failure_handling:
    warn_threshold: 2        # Show warning after 2 failures
    warn_message: "Please read items carefully before answering."
    block_threshold: 5       # Block user after 5 failures
    block_message: "You have been blocked due to too many incorrect responses."
Aufmerksamkeitscheck-Elementdatei
[
  {
    "id": "attn_001",
    "text": "Please select 'Positive' for this item to verify you are reading carefully.",
    "expected_answer": {
      "sentiment": "positive"
    }
  }
]
Gold-Standards
Gold-Standards sind expertengelabelte Elemente, die zur Messung der Annotatorgenauigkeit verwendet werden. Standardmäßig sind Gold-Standards still – Ergebnisse werden für die Admin-Überprüfung aufgezeichnet, aber Annotatoren erhalten kein Feedback.
Konfiguration
gold_standards:
  enabled: true
  items_file: "gold_standards.json"

  # How to use gold standards
  mode: "mixed"              # Options: training, mixed, separate
  frequency: 20              # Insert one every 20 items

  # Accuracy requirements
  accuracy:
    min_threshold: 0.7       # Minimum required accuracy (70%)
    evaluation_count: 10     # Evaluate after this many gold items

  # Feedback settings (disabled by default)
  feedback:
    show_correct_answer: false
    show_explanation: false

  # Auto-promotion from high-agreement items
  auto_promote:
    enabled: true
    min_annotators: 3
    agreement_threshold: 1.0   # 1.0 = unanimous
Gold-Standard-Elementdatei
[
  {
    "id": "gold_001",
    "text": "The service was absolutely terrible and I will never return.",
    "gold_label": {
      "sentiment": "negative"
    },
    "explanation": "Strong negative language clearly indicates negative sentiment.",
    "difficulty": "easy"
  }
]
Automatische Hochstufung
Elemente können automatisch zu Gold-Standards werden, wenn mehrere Annotatoren übereinstimmen:
gold_standards:
  auto_promote:
    enabled: true
    min_annotators: 3          # Wait for at least 3 annotators
    agreement_threshold: 1.0   # 100% must agree (unanimous)
Vorausfüll-Unterstützung
Vorausfüllen ermöglicht es, Annotationsformulare mit Modellvorhersagen vorab auszufüllen – nützlich für Active-Learning- und Korrektur-Workflows.
Konfiguration
pre_annotation:
  enabled: true
  field: "predictions"        # Field in data containing predictions
  allow_modification: true    # Can annotators change pre-filled values?
  show_confidence: true
  highlight_low_confidence: 0.7
Datenformat
Vorhersagen in Ihren Datenelementen einschließen:
{
  "id": "item_001",
  "text": "I love this product!",
  "predictions": {
    "sentiment": "positive",
    "confidence": 0.92
  }
}
Übereinstimmungsmetriken
Echtzeit-Inter-Annotator-Übereinstimmungsmetriken mit Krippendorffs Alpha sind im Admin-Dashboard verfügbar.
Konfiguration
agreement_metrics:
  enabled: true
  min_overlap: 2             # Minimum annotators per item
  refresh_interval: 60       # Seconds between updates
Interpretation von Krippendorffs Alpha
| Alpha-Wert | Interpretation |
|---|---|
| α ≥ 0,8 | Gute Übereinstimmung – für die meisten Zwecke zuverlässig |
| 0,67 ≤ α ≤ 0,8 | Tentative Übereinstimmung – vorläufige Schlussfolgerungen möglich |
| 0,33 ≤ α ≤ 0,67 | Niedrige Übereinstimmung – Richtlinien überprüfen |
| α ≤ 0,33 | Schlechte Übereinstimmung – erhebliche Probleme |
Admin-Dashboard-Integration
Qualitätskontrollmetriken im Admin-Dashboard unter /admin anzeigen:
- Aufmerksamkeitschecks: Gesamte Bestanden-/Nichtbestanden-Raten, Statistiken je Annotator
- Gold-Standards: Genauigkeit je Annotator, Schwierigkeitsanalyse je Element
- Übereinstimmung: Krippendorffs Alpha pro Schema mit Interpretation
- Automatisch hochgestufte Elemente: Liste der durch hohe Übereinstimmung hochgestuften Elemente
API-Endpunkte
Qualitätskontrollmetriken
GET /admin/api/quality_controlGibt Aufmerksamkeitscheck- und Gold-Standard-Statistiken zurück.
Übereinstimmungsmetriken
GET /admin/api/agreementGibt Krippendorffs Alpha pro Schema mit Interpretation zurück.
Vollständiges Beispiel
annotation_task_name: "Sentiment Analysis with Quality Control"

annotation_schemes:
  - name: sentiment
    annotation_type: radio
    labels: [positive, negative, neutral]
    description: "Select the sentiment of the text"

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 15
  failure_handling:

gold_standards:
  enabled: true
  items_file: "data/gold_standards.json"
  mode: mixed
  frequency: 25
  accuracy:

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60
Fehlerbehebung
Aufmerksamkeitschecks erscheinen nicht
- Sicherstellen, dass der
items_file-Pfad korrekt ist (relativ zum Task-Verzeichnis) - Prüfen, ob Elemente die erforderlichen Felder haben (
id,expected_answer) - Sicherstellen, dass
frequencyoderprobabilitygesetzt ist
Übereinstimmungsmetriken zeigen „No items with N+ annotators"
- Sicherstellen, dass Elemente von mehreren Nutzern annotiert wurden
min_overlapbei Bedarf reduzieren- Prüfen, ob Annotationen korrekt gespeichert werden
Häufige Fragen
Die folgenden Fragen behandeln den Aufbau eines Qualitätssicherungsprozesses und wie Gold-Standards die Genauigkeit eines Annotators über eine Sitzung hinweg verfolgen.
Wie richtet man einen Qualitätssicherungsprozess für die Annotation ein?
Man mischt Elemente mit bekannten Antworten in die Warteschlange und misst die Übereinstimmung bei Elementen, die mehrere Annotatoren gemeinsam bearbeiten. In Potato markieren Aufmerksamkeitschecks Annotatoren, die nicht lesen, Gold-Standards messen die Genauigkeit jedes Annotators gegenüber Expertenlabels, und Übereinstimmungsmetriken zeigen, bei welchen Fragen die Annotatoren uneins sind. Jede dieser Funktionen ist ein eigener Block in der YAML-Konfiguration der Aufgabe.
Wie erkennen Gold-Standards, wenn die Leistung von Annotatoren nachlässt?
Gold-Standards erscheinen weiterhin in einer festen Häufigkeit, etwa eines alle 20 Elemente, sodass die Genauigkeit gegenüber Expertenlabels gemessen wird, solange ein Annotator arbeitet, und nicht nur einmal in der Trainingsphase. Standardmäßig zeichnet Potato die Antworten still auf und führt einen Annotator im Admin-Dashboard auf, sobald seine Genauigkeit über mindestens evaluation_count Gold-Standards unter accuracy.min_threshold fällt. Diese Genauigkeit ist kumulativ über alle Gold-Standard-Antworten eines Annotators, sodass ein Rückgang spät in einer langen Sitzung sie nur langsam bewegt. Fehlgeschlagene Aufmerksamkeitschecks werden gezählt und nicht gemittelt, sodass eine plötzliche Serie von Fehlschlägen die Warnschwelle erreicht, unabhängig davon, wie viele Checks der Annotator zuvor bestanden hat.
Weiterführende Informationen
- Trainingsphase – Annotator-Qualifizierung
- Admin-Dashboard – Metriken überwachen
- Aufgabenzuweisung – Annotationsverteilung steuern
Implementierungsdetails finden Sie in der Quelldokumentation.