Active Learning
Die Annotationswarteschlange von Potato nach Modellunsicherheit neu ordnen, mit fünf Abfragestrategien, sklearn-Classifiern, Kaltstart-Behandlung und Modellpersistenz über Neustarts hinweg.
Active Learning ordnet die Annotationswarteschlange so um, dass Annotatoren die Instanzen sehen, bei denen ein Modell am unsichersten ist, statt das Korpus in der Reihenfolge abzuarbeiten, in der es angekommen ist.
Funktionsweise
- Sammeln einer ersten Menge von Annotationen
- Trainieren eines Classifiers auf dem, was bisher gelabelt wurde
- Bewerten des ungelabelten Pools nach Unsicherheit
- Neu ordnen der Warteschlange, sodass die unsichersten Instanzen vorne stehen
- Annotieren der priorisierten Instanzen
- Neu trainieren in regelmäßigen Abständen, während sich Annotationen ansammeln
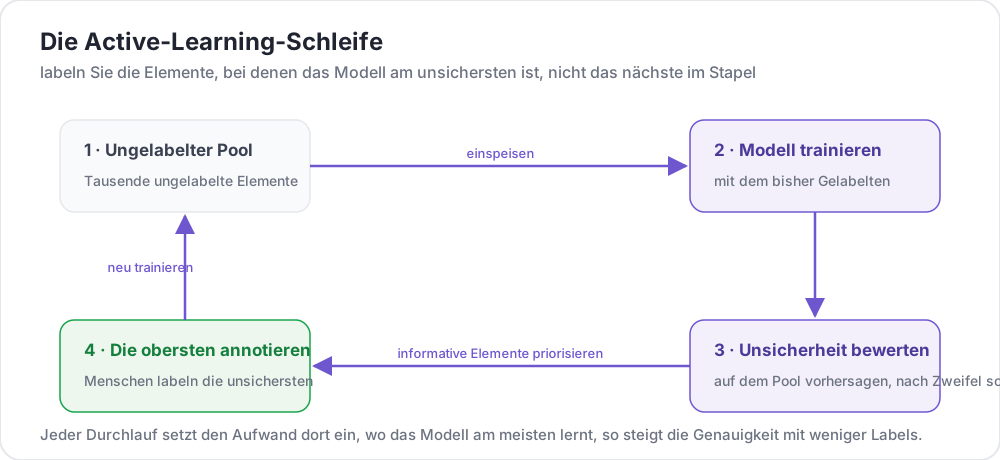 Annotationsaufwand dort einsetzen, wo das Modell am meisten lernt
Konfiguration
Grundeinrichtung
active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000
min_instances_for_training hat den Standardwert 10 und update_frequency den Standardwert 5. Beide Standardwerte sind so niedrig, dass es sich in einem echten Projekt lohnt, sie zu erhöhen, denn ein Neutraining alle fünf Annotationen verbraucht Rechenzeit für ein Modell, das sich kaum verändert hat.
Vollständige Konfiguration
active_learning:
  enabled: true

  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000

  # How disagreement between annotators resolves into one training label
  resolution_strategy: majority_vote

  # Fraction of the queue left in random order, so the model does not
  # only ever see what it already found interesting
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
Die verschachtelten Blöcke classifier, vectorizer und model_persistence sind die dokumentierte Form und die, die potato validate --strict erkennt. Ihre Unterschlüssel sind name und hyperparameters bei den ersten beiden sowie enabled, save_directory und retention_count beim dritten. Ein Block mit anderen Unterschlüsselnamen wird ohne Meldung ignoriert, und der Lauf fällt stillschweigend auf die Standardwerte zurück.
Abfragestrategien
| Strategie | Beschreibung |
|---|---|
uncertainty | Instanzen, bei denen das Modell am wenigsten sicher ist. Der Standard |
diversity | Instanzen, die dem bereits Annotierten am wenigsten ähneln |
badge | Batch Active learning by Diverse Gradient Embeddings |
bald | Bayesian Active Learning by Disagreement |
hybrid | Eine gewichtete Kombination aus Unsicherheit und Diversität |
active_learning:
  query_strategy: uncertainty
Ein unbekannter Strategiename fällt mit einer Warnung auf uncertainty zurück, statt den Start scheitern zu lassen. Prüfen Sie daher das Log, wenn eine Strategie scheinbar keine Wirkung hat.
Hybrid und BALD abstimmen
hybrid gewichtet standardmäßig Unsicherheit mit 70 % und Diversität mit 30 %:
active_learning:
  query_strategy: hybrid
  hybrid_weights:
    uncertainty: 0.7
    diversity: 0.3
bald trainiert ein kleines Ensemble und ordnet nach der Uneinigkeit innerhalb dieses Ensembles:
active_learning:
  query_strategy: bald
  bald_params:
    n_estimators: 5
    bootstrap_fraction: 0.8
Classifier
Classifier werden über ihren sklearn-Importpfad angegeben. Der Standard ist sklearn.linear_model.LogisticRegression.
| Classifier | Pfad | Geeignet für | Geschwindigkeit |
|---|---|---|---|
| Logistische Regression | sklearn.linear_model.LogisticRegression | Die meisten Textaufgaben | Schnell |
| Random Forest | sklearn.ensemble.RandomForestClassifier | Nichtlineare Muster | Mittel |
| SVC | sklearn.svm.SVC | Kleine Datensätze | Langsam |
| Multinomial NB | sklearn.naive_bayes.MultinomialNB | Einfache Textklassifikation | Sehr schnell |
Logistische Regression als empfohlener Ausgangspunkt:
active_learning:
  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000
Random Forest, wenn die Entscheidung nicht annähernd linear ist:
active_learning:
  classifier:
    name: sklearn.ensemble.RandomForestClassifier
    hyperparameters:
      n_estimators: 100
      max_depth: 10
Ein SVC muss ausdrücklich angewiesen werden, Wahrscheinlichkeiten auszugeben, da der Unsicherheitswert davon abhängt:
active_learning:
  classifier:
    name: sklearn.svm.SVC
    hyperparameters:
      kernel: rbf
      probability: true
Naive Bayes, wenn Geschwindigkeit wichtiger ist als der letzte Prozentpunkt Genauigkeit:
active_learning:
  classifier:
    name: sklearn.naive_bayes.MultinomialNB
    hyperparameters:
      alpha: 1.0
calibrate_probabilities ist standardmäßig aktiviert. Das ist wichtig, weil Uncertainty Sampling nach vorhergesagter Wahrscheinlichkeit ordnet und ein unkalibrierter Classifier Elemente, bei denen er sich zuversichtlich irrt, so einordnet, als wären sie geklärt.
Vectorizer
Der Standard ist sklearn.feature_extraction.text.TfidfVectorizer.
TF-IDF, gewichtete Merkmale:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]
      stop_words: english
Einfache Zählungen:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.CountVectorizer
    hyperparameters:
      max_features: 3000
      ngram_range: [1, 1]
Hashing, für ein Vokabular, das zu groß ist, um es im Speicher zu halten:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.HashingVectorizer
    hyperparameters:
      n_features: 10000
ngram_range wird als YAML-Liste geschrieben und in das Tupel umgewandelt, das sklearn erwartet. [1, 2] ist hier also korrekt und braucht keine besondere Syntax.
Kaltstart
Bevor ein Modell existiert, gibt es nichts, worüber es unsicher sein könnte. Die erste Charge wird deshalb ohne Modell ausgewählt:
active_learning:
  cold_start_strategy: random
  cold_start_batch_size: 20
LLM-gestützte Auswahl
Ein LLM kann Instanzen während der Kaltstartphase oder parallel zum Classifier bewerten:
active_learning:
  enabled: true
  schema_names:
    - sentiment

  llm:
    enabled: true
    endpoint_type: vllm
    base_url: http://localhost:8000/v1
    model: meta-llama/Llama-3.2-3B-Instruct
    confidence_method: verbalized
confidence_method legt fest, wie der Konfidenzwert ermittelt wird. Die Wahl ist wichtig, weil dieser Wert die Auswahl steuert:
| Methode | Funktionsweise | Abwägung |
|---|---|---|
verbalized | Das Modell gibt seine eigene Konfidenz auf einer Skala von 1 bis 10 an | Universell, bei manchen Modellen aber unzuverlässig |
logprobs | Aus den Log-Wahrscheinlichkeiten der Tokens berechnet | Am besten kalibriert, braucht einen Endpoint, der Logprobs zurückgibt |
consistency | Dieselbe Instanz wird mehrmals abgefragt und nach Übereinstimmung bewertet | Funktioniert überall, kostet aber N Aufrufe pro Instanz |
logprobs fällt auf die verbalisierte Konfidenz zurück, wenn der Endpoint keine Logprobs zurückgibt.
Modellpersistenz
Trainierte Modelle können einen Neustart überdauern, statt von Grund auf neu aufgebaut zu werden:
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
retention_count hat den Standardwert 2 und begrenzt, wie viele gespeicherte Modelle aufbewahrt werden.
Datenbankgestützte Persistenz ist nicht mehr konfigurierbar. Die Schlüssel database_enabled und database_config wurden entfernt, weil die Schicht dahinter ein Platzhalter war, der Erfolg protokollierte und nichts speicherte. Der Laufverlauf wird jetzt immer aufgezeichnet und braucht keine Konfiguration, und beide Schlüssel werden ignoriert, falls eine Konfiguration sie noch enthält.
Mehrere Schemata
schema_names listet die Schemata auf, deren Annotationen das Modell trainieren. Ist es nicht gesetzt, werden standardmäßig die labelbaren Schemata des Projekts verwendet:
annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels: [Positive, Negative, Neutral]

  - annotation_type: radio
    name: topic
    description: "What is the topic?"
    labels: [Politics, Sports, Tech, Entertainment]

active_learning:
  enabled: true
  schema_names:
    - sentiment
    - topic
Vollständige Konfiguration
annotation_task_name: "Sentiment Analysis with Active Learning"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 30
  update_frequency: 50
  max_instances_to_reorder: 500
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5

output_annotation_dir: "output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Kombination mit AI-Unterstützung
Active Learning entscheidet, was als Nächstes angezeigt wird. AI-Unterstützung hilft dem Annotator bei dem, was gerade auf dem Bildschirm ist. Beide sind unabhängig voneinander und lassen sich kombinieren:
active_learning:
  enabled: true
  schema_names:
    - sentiment
  min_instances_for_training: 30

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true
Lesen Sie das Ergebnis mit Vorsicht. Wenn das Modell ein Label vorschlägt, der Annotator es übernimmt und dieselbe Modellfamilie die Instanz ausgewählt hat, dann besteht die am Ende gemessene Übereinstimmung zum Teil darin, dass das Modell mit sich selbst übereinstimmt.
Überwachung
Das Admin-Dashboard zeigt die Modellgenauigkeit, die Anzahl der Trainingszyklen, die Verteilung der Unsicherheit und die Zahl der verbleibenden Instanzen. Für den Zugriff braucht es den Admin-Key oder eine Rolle mit view_admin_dashboard.
Bewährte Vorgehensweisen
Zuerst eine Basis sammeln
Auf einer leeren Menge lässt sich nichts trainieren, und ein Modell, das auf zwanzig Annotationen trainiert wurde, ordnet überwiegend Rauschen um:
active_learning:
  min_instances_for_training: 50
Die Klassenbalance im Blick behalten
Uncertainty Sampling konzentriert sich auf die Entscheidungsgrenze, wodurch sich die Labelverteilung von der des Korpus entfernt. Für das Training eines Modells ist das unproblematisch, irreführend aber, wenn Sie die annotierte Stichprobe als Beschreibung der Daten berichten. Genau aus diesem Grund hält random_sample_percent einen Teil der Warteschlange unverzerrt.
Nicht zu oft neu trainieren
active_learning:
  update_frequency: 100
Modelle über Neustarts hinweg behalten
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
Fehlerbehebung
Das Training startet nie
Prüfen Sie, ob die Annotationen min_instances_for_training erreicht haben und ob jede Klasse mindestens ein Beispiel hat. Mit einem Trainingsdatensatz aus nur einer Klasse lässt sich kein Classifier anpassen.
Die Neuordnung scheint nichts zu bewirken
Suchen Sie im Log nach einer unbekannten query_strategy, die stillschweigend auf Unsicherheit zurückfällt. Stellen Sie sicher, dass enabled: true gesetzt ist und dass schema_names Schemata nennt, die tatsächlich existieren.
Langsam bei einem großen Pool
Senken Sie max_instances_to_reorder, erhöhen Sie update_frequency oder wechseln Sie bei einem sehr großen Vokabular zu HashingVectorizer.
Weiterführende Informationen
- AI-Unterstützung - LLM-Unterstützung während der Annotation
- Aufgabenzuweisung - Die anderen Zuweisungsstrategien
- Admin-Dashboard - Den Trainingskreislauf überwachen
- Diversity Ordering - Embedding-basierte Anordnung ohne Classifier
Implementierungsdetails finden Sie in der Quelldokumentation.