Process-Reward-Annotation
Reward-Labels pro Schritt für Process Reward Models erheben, mit First-Error- und Pro-Schritt-Modus, optionalen neutralen Labels und LLM-Vorbeschriftung mit menschlicher Verifikation.
Neu in v2.4.0
Process Reward Models bewerten die Denkschritte, die ein Modell unternimmt, und nicht nur seine Endantwort. Um eines zu trainieren, braucht es deshalb ein Label pro Schritt statt eines Labels pro Trace. Das Schema process_reward erhebt diese Labels.
Zwei Modi wägen Tempo gegen Detailtiefe ab. Der First-Error-Modus verlangt einen einzigen Klick auf den ersten Schritt, der schiefgeht, wobei alles danach als verdorben gilt. Der Modus pro Schritt verlangt ein Urteil über jeden Schritt. Das kostet mehr und erfasst Fälle, die der First-Error-Modus nicht abbilden kann, etwa einen Agenten, der sich von seinem eigenen Fehler erholt.
Beide Modi arbeiten mit den Anzeigen für Coding-Traces, Agent-Traces und Chain-of-Thought zusammen.
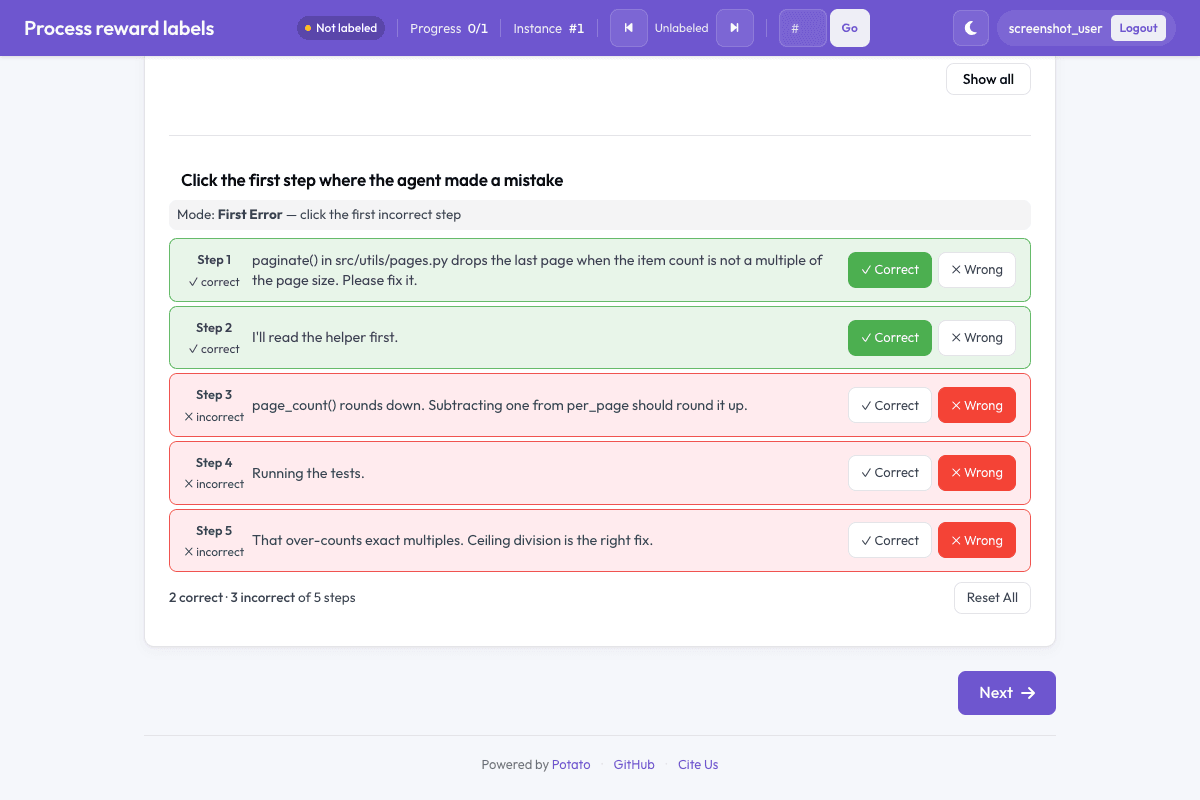 Ein Klick auf den ersten falschen Schritt beschriftet den ganzen Trace
First-Error-Modus
Der Annotator liest den Trace von oben nach unten und klickt auf den ersten inkorrekten Schritt. Die Schritte davor werden als korrekt aufgezeichnet, der angeklickte Schritt und alles danach als inkorrekt. Daraus entsteht die Labelfolge, die das binäre PRM-Training erwartet: 1 bis zum Fehler, danach -1 ab dem Fehler.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent made a mistake"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
steps_key nennt das Feld mit der Schrittliste, und step_text_key nennt das Feld innerhalb jedes Schritts, das angezeigt wird.
Annotationsablauf
- Die Schritte sind zunächst unmarkiert
- Der Annotator klickt den ersten inkorrekten Schritt an
- Alles davor wird grün
- Dieser Schritt wird als erster Fehler markiert
- Alles danach wird als verdorben markiert
Die Farben machen die Kaskade sichtbar, und genau darin liegt der Sinn des Modus: Ein einziges Urteil labelt den gesamten Trace.
Modus pro Schritt
Jeder Schritt wird für sich beurteilt. Fügen Sie allow_neutral für das dreiwertige Label im Stil von PRM800K hinzu, bei dem ein Schritt weder richtig noch falsch sein kann:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
allow_neutral gilt nur im Modus pro Schritt. Die First-Error-Kaskade hat keine Position für einen neutralen Schritt, daher wird die Option dort ignoriert.
inline_with_trace: true hängt die Bewertungselemente an jeden Schritt in der Anzeige, statt sie in einem separaten Bereich zu sammeln. Das ist bei einem langen Trace sinnvoll, bei dem der Annotator sonst die Orientierung verlöre.
Labels umbenennen
Die drei Schaltflächen heißen standardmäßig Correct, Neutral und Wrong. reward_labels benennt sie für Fachgebiete um, in denen diese Wörter nicht passen:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    reward_labels:
      correct: "Valid"
      neutral: "Neutral"
      incorrect: "Flawed"
Eine Chain of Thought segmentieren
Reasoning-Traces kommen meist als eine lange Zeichenkette an und nicht als Schrittliste. cot_segmentation teilt sie auf, bevor die Annotation beginnt:
cot_segmentation:
  source_key: reasoning      # the item field holding the long CoT string
  strategy: auto             # blank_line | numbered | markers | sentence | llm | auto
  target_key: cot_steps      # where the step list is written
  min_step_chars: 30         # merge anything shorter into the previous step
  max_steps: 200

instance_display:
  fields:
    - key: cot_steps
      type: cot_trace
      label: "Reasoning"

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
Es lohnt sich, min_step_chars zu setzen. Ohne diese Einstellung erzeugt die Segmentierung nach Sätzen und Leerzeilen einzeilige Fragmente, die Annotatoren nicht isoliert beurteilen können, und das zurückgelieferte Label ist Rauschen.
LLM-Vorbeschriftung
Ein Modell kann die Labels pro Schritt vorschlagen, und der Annotator bestätigt oder überschreibt jedes einzelne. Das ist bei langen Traces schneller als Labeln von Grund auf:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Verify or correct each suggested reward"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
    ai_prelabel: true
    require_verification: true

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    max_tokens: 768
    temperature: 0.1
    include:
      all: true
ai_prelabel fügt die Schaltfläche hinzu, die Vorschläge anfordert. require_verification nimmt die Annotation erst an, wenn jeder Vorschlag bestätigt oder geändert wurde. Dadurch bleibt die Ausgabe ein menschliches Label und wird nicht zu dem eines Modells.
Geben Sie max_tokens echten Spielraum. Eine lange Chain of Thought plus ein Urteil pro Schritt ergibt eine große Antwort, und eine abgeschnittene Antwort erscheint als gar kein Vorschlag.
Was die Ausgabe enthält
Die Annotation wird unter dem Namen des Schemas als Liste steps gespeichert, zusammen mit dem mode, in dem sie erhoben wurde:
{
  "step_rewards": {
    "mode": "per_step",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": 0, "source": "ai", "verified": true, "ai_reward": 0},
      {"reward": null, "source": null, "verified": false}
    ]
  }
}
reward ist 1 für korrekt, -1 für inkorrekt und 0 für neutral. Ein übersprungener Schritt ist null und nicht 0, sodass ein Schritt, den niemand beurteilt hat, von einem als weder richtig noch falsch beurteilten unterscheidbar bleibt. Diese Unterscheidung zählt, sobald die Labels zu Trainingsdaten werden, denn übersprungene Schritte als neutral zu behandeln erfindet unbemerkt ein Signal.
source hält fest, ob der Wert von einer Person oder einem Modell stammt, und verified, ob eine Person ihn bestätigt hat. Bei aktivem ai_prelabel behält ai_reward den ursprünglichen Vorschlag des Modells auch dann, wenn ein Annotator ihn überschreibt. So lässt sich ohne zweiten Durchgang berichten, wie oft das Modell richtig lag.
Export
Potato hat kein eingebautes PRM- oder DPO-Exportformat. Exportieren Sie die Annotationen, und bringen Sie sie selbst in die gewünschte Form:
python -m potato.export -c config.yaml -f jsonl -o ./export/Die Umwandlung von First-Error-Annotationen in Trainingslabels auf Schrittebene ist kurz, und wer sie selbst schreibt, entscheidet damit, wie übersprungene Schritte behandelt werden:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "steps": [
                    {"content": src, "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_training_data.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Auswertung
import json
from collections import Counter
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

print(f"Traces annotated: {len(traces)}")

all_correct = sum(
    1 for t in traces
    if all(s.get("reward") == 1 for s in t.get("steps", []))
)
print(f"Traces with no errors: {all_correct} ({all_correct / len(traces):.1%})")

# Where the first error lands
first_error_positions = []
for t in traces:
    for i, s in enumerate(t.get("steps", [])):
        if s.get("reward") == -1:
            first_error_positions.append(i)
            break

if first_error_positions:
    avg = sum(first_error_positions) / len(first_error_positions)
    print(f"Average first-error position: step {avg:.1f}")
    print("By position:", Counter(first_error_positions).most_common(10))
Bei aktivem ai_prelabel zeigen dieselben Datensätze, wie oft der Vorschlag des Modells die Prüfung überstanden hat:
kept = changed = 0
for t in traces:
    for s in t.get("steps", []):
        if s.get("ai_reward") is None:
            continue
        if s.get("reward") == s.get("ai_reward"):
            kept += 1
        else:
            changed += 1

total = kept + changed
if total:
    print(f"AI suggestions kept: {kept}/{total} ({kept / total:.1%})")
Diese Akzeptanzrate ist die Zahl, die man im Blick behalten sollte, bevor man der Vorbeschriftung in einem neuen Fachgebiet vertraut. Eine Rate nahe 100 % bedeutet meist, dass Annotatoren bestätigen, statt zu prüfen, und nicht, dass das Modell recht hat.
Forschungskontext
Die Process-Reward-Annotation soll Arbeiten an Reward-Modellen für mehrstufige Systeme unterstützen. Der Befund, der den gesamten Ansatz motiviert, lautet, dass eine korrekte Endantwort auf fehlerhaftem Denken beruhen kann. Labels auf Schrittebene trennen beides, und der First-Error- und der Pro-Schritt-Modus bilden die Labelformate dieser Arbeitslinie ab.
Zum Entwurf der Taxonomie und den damit verbundenen Übereinstimmungsfragen siehe die Fehlerlokalisierung pro Schritt, die dieselben Traces von der Seite der Fehlerklassifikation behandelt.
Siehe auch
- Annotation von Coding-Agenten -- Traces von Coding-Agenten darstellen und annotieren
- Agentische Annotation -- allgemeine Annotation von Agent-Traces
- Exportformate -- die Formate, die Potato exportiert
- Qualitätskontrolle -- Übereinstimmung und Adjudikation
- Ein LLM auf deinen Annotationen fine-tunen -- ein Prozess-Reward-Modell mit
prm-rewardauf den Schrittbewertungen trainieren
Implementierungsdetails stehen in der Quelldokumentation.