Trainingsphase
Annotatoren mit Übungsfragen trainieren und qualifizieren, bevor die Hauptaufgabe beginnt.
Potato 2.0 enthält eine optionale Trainingsphase, die Annotatoren vor Beginn der Hauptannotationsaufgabe qualifiziert. Annotatoren beantworten Übungsfragen mit bekannten richtigen Antworten und erhalten Feedback zu ihrer Leistung.
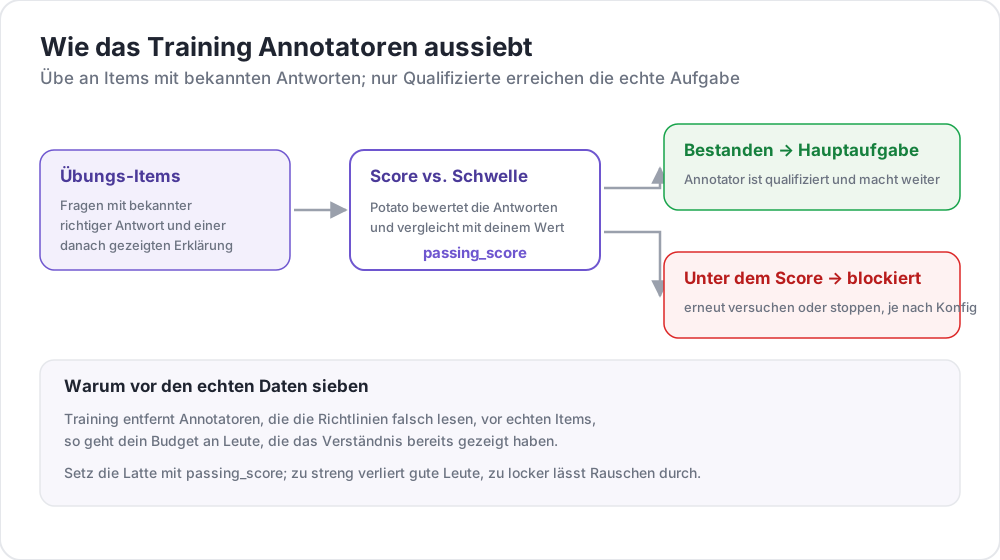 Wie das Training Annotatoren aussiebt
Anwendungsfälle
- Sicherstellen, dass Annotatoren die Aufgabe verstehen
- Minderwertige Annotatoren herausfiltern
- Geführtes Üben vor echten Annotationen bereitstellen
- Grundlegende Qualitätsmetriken erfassen
- Annotationsrichtlinien durch Beispiele vermitteln
Funktionsweise
- Annotatoren beantworten eine Reihe von Trainingsfragen
- Sie erhalten sofortiges Feedback zu jeder Antwort
- Fortschritt wird gegenüber Bestehenskriterien verfolgt
- Nur Annotatoren, die bestehen, können zur Hauptaufgabe übergehen
Konfiguration
Grundeinrichtung
training:
  enabled: true
  data_file: "data/training_data.json"
  annotation_schemes: ["sentiment"]
  passing_criteria:
    min_correct: 3
    require_all_correct: false
  allow_retry: true
  failure_action: "repeat_training"
Vollständige Konfiguration
phases:
  order: [consent, instructions, training, annotation]

  consent:
    type: consent
    file: surveyflow/consent.json

  instructions:
    type: instructions
    file: surveyflow/instructions.html

  training:
    type: training
    file: data/training_data.json
Bestehenskriterien
Verschiedene Kriterien für das Bestehen der Trainingsphase können festgelegt werden:
Mindest-Richtige
passing_criteria:
  min_correct: 3
Annotator muss mindestens 8 von 10 Fragen richtig beantworten.
Alle richtig erforderlich
passing_criteria:
  require_all_correct: true
Annotator muss jede Frage richtig beantworten, um zu bestehen.
Maximale Fehler
passing_criteria:
  max_mistakes: 5
Annotator wird nach 3 Gesamtfehlern disqualifiziert.
Maximale Fehler pro Frage
passing_criteria:
  max_mistakes_per_question: 2
Annotator wird nach 2 Fehlern bei einer einzelnen Frage disqualifiziert.
Kombinierte Kriterien
passing_criteria:
  min_correct: 3
  max_mistakes: 5
  max_mistakes_per_question: 2
Muss 8 richtig UND keine einzelne Frage mehr als 3 Mal falsch beantworten.
Trainingsdatenformat
Trainingsdaten müssen richtige Antworten und optionale Erklärungen enthalten:
[
  {
    "id": "train_1",
    "text": "I absolutely love this product! Best purchase ever!",
    "correct_answers": {
      "sentiment": "Positive"
    },
    "explanation": "This text expresses strong positive sentiment with words like 'love' and 'best'."
  },
  {
    "id": "train_2",
    "text": "This is the worst service I've ever experienced.",
    "correct_answers": {
      "sentiment": "Negative"
    },
    "explanation": "The words 'worst' and the overall complaint indicate negative sentiment."
  },
  {
    "id": "train_3",
    "text": "The package arrived on time.",
    "correct_answers": {
      "sentiment": "Neutral"
    },
    "explanation": "This is a factual statement without emotional indicators."
  }
]
Multi-Schema-Training
Für Aufgaben mit mehreren Annotationsschemata:
{
  "id": "train_1",
  "text": "Apple announced new iPhone features yesterday.",
  "correct_answers": {
    "sentiment": "Neutral",
    "topic": "Technology"
  },
  "explanation": {
    "sentiment": "This is a factual news statement.",
    "topic": "The text discusses Apple and iPhone, which are tech topics."
  }
}
Nutzererfahrung
Trainingsablauf
- Nutzer sieht den Indikator "Trainingsphase"
- Frage wird mit Annotationsformular angezeigt
- Nutzer sendet seine Antwort ab
- Feedback wird sofort angezeigt:
- Richtig: Grünes Häkchen, weiter zur nächsten Frage
- Falsch: Rotes X, Erklärung angezeigt, Wiederholungsoption
Feedback-Anzeige
Wenn ein Annotator falsch antwortet:
- Die richtige Antwort wird hervorgehoben
- Die bereitgestellte Erklärung wird angezeigt
- Wiederholungsschaltfläche erscheint (wenn Wiederholungen aktiviert)
- Fortschritt zu den Bestehenskriterien wird angezeigt
Admin-Überwachung
Trainingsleistung im Admin-Dashboard verfolgen:
- Abschlussraten
- Durchschnittliche richtige Antworten
- Bestanden-/Nicht-bestanden-Raten
- Im Training verbrachte Zeit
- Genauigkeit pro Frage
Zugriff über /admin-API-Endpunkte:
GET /api/admin/training/stats
GET /api/admin/training/user/{user_id}
Beispiel: Sentiment-Analyse-Training
annotation_task_name: "Sentiment Analysis"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment of this review?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

training:
  enabled: true
  data_file: "data/training_data.json"
  annotation_schemes: ["sentiment"]
  passing_criteria:
    min_correct: 3
    require_all_correct: false
  allow_retry: true
  failure_action: "repeat_training"

phases:
  order: [training, annotation]
  training:
    type: training
    file: "data/training_data.json"

output_annotation_dir: "output/"
export_annotation_format: "jsonl"

user_config:
  allow_all_users: true
Beispiel: NER-Training
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - Person
      - Organization
      - Location
      - Date

training:
  enabled: true
  data_file: "data/ner_training.json"
  annotation_schemes: ["entities"]
  passing_criteria:
    min_correct: 2
  allow_retry: true
Trainingsdaten für Span-Annotation:
{
  "id": "train_1",
  "text": "Tim Cook announced that Apple will open a new store in New York on March 15.",
  "correct_answers": {
    "entities": [
      {"start": 0, "end": 8, "label": "Person"},
      {"start": 24, "end": 29, "label": "Organization"},
      {"start": 54, "end": 62, "label": "Location"},
      {"start": 66, "end": 74, "label": "Date"}
    ]
  },
  "explanation": "Tim Cook is a Person, Apple is an Organization, New York is a Location, and March 15 is a Date."
}
Bewährte Vorgehensweisen
1. Einfach beginnen
Mit einfachen Beispielen beginnen, bevor Grenzfälle eingeführt werden:
[
  {"text": "I love this!", "correct_answers": {"sentiment": "Positive"}},
  {"text": "I hate this!", "correct_answers": {"sentiment": "Negative"}},
  {"text": "It arrived yesterday.", "correct_answers": {"sentiment": "Neutral"}}
]
2. Alle Labels abdecken
Sicherstellen, dass das Training Beispiele für jedes mögliche Label enthält:
[
  {"correct_answers": {"sentiment": "Positive"}},
  {"correct_answers": {"sentiment": "Negative"}},
  {"correct_answers": {"sentiment": "Neutral"}}
]
3. Klare Erklärungen schreiben
Erklärungen sollten die Annotationsrichtlinien vermitteln:
{
  "explanation": "While this text mentions a problem, the overall tone is constructive and the reviewer expresses satisfaction with the resolution. This makes it Positive rather than Negative."
}
4. Angemessene Kriterien festlegen
Keine unnötige Perfektion fordern:
passing_criteria:
  require_all_correct: true
5. Grenzfälle einschließen
Knifflige Beispiele hinzufügen, um Annotatoren vorzubereiten:
{
  "text": "Not bad at all, I guess it could be worse.",
  "correct_answers": {"sentiment": "Neutral"},
  "explanation": "Despite negative words like 'not bad' and 'worse', this is actually a lukewarm endorsement - neutral rather than positive or negative."
}
Integration mit Workflows
Training integriert sich in mehrphasige Workflows:
passing_criteria:
  min_correct: 3
  max_mistakes_per_question: 2
Leistungsüberlegungen
- Trainingsdaten werden beim Start geladen
- Fortschritt wird im Arbeitsspeicher pro Sitzung gespeichert
- Minimale Auswirkung auf die Hauptannotationsleistung
- Bei komplexem Training die Aufteilung auf mehrere Phasen erwägen
Weiterführende Informationen
- Qualitätskontrolle – Aufmerksamkeitschecks und Gold-Standards
- Kategoriezuweisung – Elemente nach Annotator-Expertise weiterleiten
- Mehrphasige Workflows – Komplexe Annotationsworkflows
Implementierungsdetails finden Sie in der Quelldokumentation.