KI-Agenten evaluieren: menschliche Annotation von Agenten-Traces
Wie Sie in Potato die menschliche Evaluierung von KI-Agenten-Ausgaben einrichten, vom Trace-Import über das Design von Schemata auf Trace- und Schrittebene bis zur Analyse der exportierten Ergebnisse.
Konvertieren Sie Agenten-Traces mit python -m potato.trace_converter, zeigen Sie sie über ein agent_trace-Anzeigefeld an und erfassen Sie ein Urteil auf Trace-Ebene zusammen mit einer schrittweisen trajectory_eval-Bewertung. Die schrittweise Bewertung ist der Teil, der den Schritt findet, an dem der Lauf schiefging.
Eine Erfolgsquote sagt Ihnen, wie oft ein Agent die Aufgabe abschließt, und nichts darüber, warum die Fehlschläge gescheitert sind. Zwei Agenten mit derselben Erfolgsquote von 62 % können aus völlig verschiedenen Gründen scheitern, der eine, weil er das falsche Tool wählt, der andere, weil er korrekt über ein schlechtes Retrieval-Ergebnis schlussfolgert, und die Korrektur ist jeweils eine andere. Menschliche Evaluierung auf Schrittebene trennt die beiden, weil der Annotator markiert, welcher Schritt gebrochen ist und welche Art von Bruch es war.
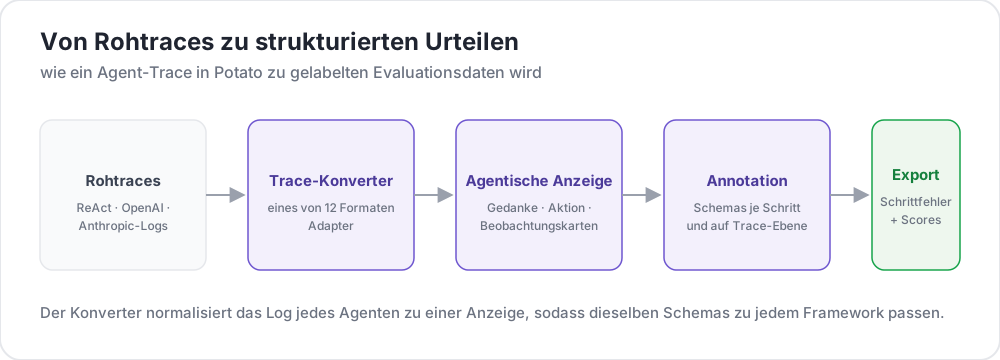 Von rohen Traces zu strukturierten Urteilen
Dieser Leitfaden baut die Pipeline für einen Agenten im ReAct-Stil, der Fragen per Websuche beantwortet. Die Konfigurationen sind gegen Potato 2.9.1 geprüft:
pip install --upgrade potato-annotationSchritt 1: die Traces konvertieren
Potato registriert 15 Trace-Konverter, und die CLI listet sie mit ihren Beschreibungen auf:
python -m potato.trace_converter --list-formatsDie Liste umfasst react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code und aider. LangSmith-Run-Exporte laufen über langchain, und Logs aus CrewAI, AutoGen und LangGraph laufen über multi_agent.
Der react-Konverter liest einen Trace, dessen Schritte die Schlüssel thought, action und observation tragen:
{
  "id": "trace_001",
  "task": "What is the capital of Australia and what is its population?",
  "steps": [
    {"thought": "I need the capital of Australia and then its population.",
     "action": "search('capital of Australia')",
     "observation": "Canberra is the capital city of Australia."},
    {"thought": "Now I need Canberra's population.",
     "action": "search('Canberra population 2025')",
     "observation": "Canberra has a population of approximately 467,000 as of 2025."},
    {"thought": "I have both pieces of information.",
     "action": "finish('Canberra, approximately 467,000')"}
  ],
  "metadata": {"agent": "GPT-4", "tokens": 2340}
}
Ein einziger Befehl konvertiert die Datei:
python -m potato.trace_converter \
  --input raw_traces.json \
  --input-format react \
  --output data/traces.jsonl
Übergeben Sie --auto-detect statt --input-format, wenn Sie nicht sicher sind, welcher Konverter passt, dann wählt die Registry anhand der Feldsignaturen einen aus. Geben Sie das Format explizit an, sobald Sie es kennen, denn die Erkennung nimmt den ersten passenden Konverter, und mehrere Formate überschneiden sich in den Feldern, die sie enthalten.
Jeder Konverter schreibt dieselbe kanonische Form, und deshalb funktioniert eine Konfiguration über Frameworks hinweg. Jede Zeile enthält id, task_description und conversation, eine Liste von Turns mit einem speaker und einem text. Ein Konverter, der sie hat, schreibt außerdem agent_name, metadata_table und screenshots:
{
  "id": "trace_001",
  "task_description": "What is the capital of Australia and what is its population?",
  "agent_name": "GPT-4",
  "metadata_table": [{"Property": "Steps", "Value": "3"},
                     {"Property": "tokens", "Value": "2340"}],
  "conversation": [
    {"speaker": "Agent (Thought)", "text": "I need the capital of Australia and then its population."},
    {"speaker": "Agent (Action)", "text": "search('capital of Australia')"},
    {"speaker": "Environment", "text": "Canberra is the capital city of Australia."}
  ]
}
Schritt 2: den Trace anzeigen
Die agent_trace-Anzeige stellt jeden Turn als Karte dar, farbcodiert nach Schritttyp, sodass der Annotator den Lauf liest und keinen JSON-Block:

instance_display legt fest, was auf der Seite erscheint und in welcher Reihenfolge. Die Aufgabenbeschreibung steht oben, weil der Annotator wissen muss, worum der Agent gebeten wurde, bevor irgendein Schritt etwas bedeutet, und die Metadatentabelle steht darunter in einem kompakten Tabellenfeld:
instance_display:
  layout:
    direction: vertical
    gap: 16px

  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120

    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Eingeklappte Beobachtungen verhindern, dass lange Suchergebnisse den Rest des Traces aus dem Bildschirm schieben, denn ein Trace mit einem Dutzend vollständiger Suchergebnisse besteht vor allem aus Scrollen, und der Annotator verliert den Überblick, wo im Lauf er sich befindet. Mit span_target: true auf demselben Feld kann ein Span-Schema die genauen Wörter einer halluzinierten Behauptung innerhalb eines Turns markieren, was eine feinere Aufzeichnung ist, als den ganzen Schritt als falsch zu markieren.
Schritt 3: das Urteil auf Trace-Ebene
Drei Fragen decken den Trace als Ganzes ab. Der Aufgabenerfolg ist die Hauptkennzahl, die Antwortkorrektheit trennt eine richtige Antwort, die auf schlechtem Weg erreicht wurde, von einer falschen Antwort, und die Effizienz unterscheidet zwei Agenten, die beide erfolgreich sind:
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
        tooltip: "Fully completed correctly"
      - name: "Partial success"
        tooltip: "Completed with errors or omissions"
      - name: "Failure"
        tooltip: "Not completed"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3
„Cannot determine" hat seinen Platz verdient. Ohne diese Option rät ein Annotator, der die Antwort nicht überprüfen kann, oder er markiert sie als falsch, und beide Entscheidungen bringen Rauschen in genau die Zahl, auf die es Ihnen am meisten ankommt.
Schritt 4: das Urteil pro Schritt
trajectory_eval stellt jeden Schritt als Karte mit eigenen Bedienelementen dar und trägt das Korrektheitslabel, die Fehlertaxonomie und den Schweregrad in einem Schema statt in dreien. Richten Sie steps_key auf das Feld, das die Schritte enthält, bei einem konvertierten Trace also conversation, und step_text_key auf den Schlüssel innerhalb jedes Schritts, der angezeigt werden soll:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options:
      - correct
      - partially_correct
      - incorrect
      - unnecessary
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - factual_error
          - planning_error
      - name: execution
        subtypes:
          - wrong_tool
          - wrong_args
          - api_error
      - name: termination
        subtypes:
          - premature_stop
          - redundant_step
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100
Die Schweregradgewichte machen aus einer Liste markierter Schritte eine einzige vergleichbare Zahl pro Trace, und es lohnt sich, die Standardwerte zu ändern, statt sie zu übernehmen. Ein Gewicht drückt aus, wie viel schlimmer ein kritischer Fehler für Ihre Aufgabe ist als ein geringfügiger, und bei einer Sicherheitsevaluierung ist dieses Verhältnis viel steiler als bei einer Suchaufgabe.
unnecessary getrennt von incorrect zu halten ist die andere Entscheidung, die Sie bewusst treffen sollten. Ein überflüssiger Schritt kostet Tokens und Zeit, ohne einen Fehler einzuführen, und wer beides zusammenlegt, verdeckt den Unterschied zwischen einem Agenten, der umherirrt, und einem, der falsch liegt.
Schritt 5: die vollständige Konfiguration
Alles oben Beschriebene in einer Datei:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."
output_annotation_dir: "output/"

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: task_description

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120
    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
      - name: "Partial success"
      - name: "Failure"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3

  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options: [correct, partially_correct, incorrect, unnecessary]
    error_types:
      - name: reasoning
        subtypes: [logical_error, factual_error, planning_error]
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
      - name: termination
        subtypes: [premature_stop, redundant_step]
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

export_annotation_format: jsonl
Starten Sie den Server und öffnen Sie http://localhost:8000:
potato start config.yaml -p 8000Wie die Annotationssitzung aussieht
Die Seite zeigt die Aufgabe, die Trace-Info-Tabelle und die Schrittkarten, mit den schrittweisen Bedienelementen an jeder Karte und den Schemata auf Trace-Ebene unterhalb des Traces. Die Reihenfolge, in der Annotatoren arbeiten, spielt eine größere Rolle, als es scheint. Wer zuerst die Schritte und dann den Trace bewertet, verankert das Gesamturteil in dem, was der Lauf tatsächlich getan hat, während eine vorgezogene Erfolgsbewertung dazu neigt, jede nachfolgende Schrittbewertung einzufärben.
Drei Gewohnheiten gehören in die Anweisungen für die Annotatoren. Eingeklappte Beobachtungen aufklappen, statt der Zusammenfassungszeile zu vertrauen, denn ein falsch gelesenes Suchergebnis ist die häufigste Quelle einer falschen Antwort, die gut begründet aussieht. Die Abschlussantwort mit der Ground Truth abgleichen, bevor der Aufgabenerfolg bewertet wird, wenn der Datensatz eine hat. Die Schritt-Timeline nutzen, um zu einem Schritt zurückzuspringen, sobald ein späterer Schritt zeigt, dass der frühere schon falsch war.
Schritt 6: exportieren und analysieren
Der JSONL-Exporter schreibt annotations.jsonl, mit einem Datensatz pro Instanz und Annotator:
python -m potato.export --config config.yaml --format jsonl --output ./export/Jeder Datensatz enthält instance_id, user_id, labels, spans und links, und die Antworten zu den Schemata liegen unter labels, nach Schemaname geschlüsselt:
import json
import pandas as pd

records = [json.loads(line) for line in open("export/annotations.jsonl")]

df = pd.DataFrame([
    {"trace": r["instance_id"], "annotator": r["user_id"], **r["labels"]}
    for r in records
])

print(df["task_success"].value_counts())
Ab einigen hundert Traces exportieren Sie besser nach Parquet und fragen die Datei direkt ab. Der Parquet-Export schreibt annotations.parquet mit instance_id, user_id und einer Spalte pro Annotationsschema, sodass der Schemaname eine Spalte ist und kein Wert:
python -m potato.export --config config.yaml --format parquet --output ./export/import duckdb
print(duckdb.sql("""
SELECT task_success, COUNT(*) AS n
FROM 'export/annotations.parquet'
GROUP BY task_success
ORDER BY n DESC
"""))Die Urteile auf Schrittebene sollten Sie zuerst lesen. Wenn Sie Fehler-Subtypen über alle Traces zählen, sehen Sie, ob der Agent einen systematischen Fehler hat oder einen langen Schwanz unzusammenhängender Fehler, und nur der erste Fall lohnt eine gezielte Korrektur.
Schritt 7: mehr Annotatoren und eine Qualifikationsphase
Die Evaluierung von Agenten ist so subjektiv, dass eine einzige Bewertung pro Trace eine Messung ohne Fehlerbalken ist. Drei Annotatoren pro Trace liefern Ihnen einen Übereinstimmungswert, und zufällige Zuweisung verhindert, dass sich die Überlappung auf die Traces konzentriert, die zufällig am Anfang der Datei stehen:
num_annotators_per_item: 3
assignment_strategy: random
Eine Qualifikationsphase erkennt Annotatoren, die die Fehlertaxonomie nicht verstanden haben, bevor sie einen Tag damit verbringen, sie inkonsistent anzuwenden. Der Trainingsblock hält sie bei Traces mit bekannter Antwort, bis sie bestehen:
training:
  enabled: true
  data_file: "data/training_traces.jsonl"
  passing_criteria:
    min_correct: 4
  allow_retry: true
  failure_action: "repeat_training"
Andere Agenten-Frameworks
Anzeige und Schemata bleiben über Frameworks hinweg gleich, nur der Konverter ändert sich. OpenAI-Chat-Completions-Traces und Anthropic-Nachrichten mit tool_use-Blöcken haben jeweils einen eigenen Konverter, und Multi-Agenten-Logs aus CrewAI, AutoGen und LangGraph teilen sich einen:
python -m potato.trace_converter --input runs.json --input-format openai --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format anthropic --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format multi_agent --output data/traces.jsonl
Coding-Agenten brauchen eine andere Anzeige, weil sich ein Diff, der als JSON-String gelesen wird, nicht prüfen lässt. Die coding_trace-Anzeige stellt Unified Diffs mit einem Dateibaum dar und klappt lange Terminalausgaben ein:

instance_display:
  fields:
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
Web-Browsing-Agenten brauchen die Screenshots, die Aktions-Overlays und einen Filmstreifen, um sich durch sie zu bewegen:
instance_display:
  fields:
    - key: steps
      type: web_agent_trace
      label: "Agent Browsing Trace"
      display_options:
        show_overlays: true
        show_filmstrip: true
        show_thought: true
        screenshot_max_width: 900
Web-Browsing-Agenten annotieren behandelt das Overlay-Format und den Erstellungsmodus, der neue Traces aufzeichnet.
Die Implementierungsdetails hinter all dem finden Sie im Leitfaden zur Agenten-Evaluierung und in der Dokumentation zu Agenten-Traces. Wenn Sie Ihre erste Evaluierung einrichten, konvertieren Sie zehn Traces, führen Sie die obige Konfiguration aus und annotieren Sie sie selbst, bevor Sie die Richtlinien schreiben, denn die Fehlertaxonomie, die Sie brauchen, ist meist nicht die, die Sie vorab geschrieben hätten.
Weiterführende Lektüre
- Dokumentation zur agentischen Annotation
- Web-Browsing-Agenten annotieren
- Solo-Modus, um agentische Annotation mit kollaborativer Evaluierung durch Menschen und LLMs zu kombinieren
- Best-Worst Scaling, um Agenten-Ausgaben vergleichend zu ranken
- Parquet-Export, für die Analyse im großen Maßstab